





如何使用 Nano Banana 2.1 結合多張參考圖片
經測試的 Nano Banana 2.1 工作流程,可結合人物身分、服裝與場景參考,同時保留重要細節。
將多個參考來源整合成一張可信的影像,並不只是上傳更多檔案那麼簡單。每張圖片都需要明確分配任務:一張控制人物身分,另一張控制服裝,還有一張控制環境。若沒有這份角色分工,模型可能會混合細節、遺漏配件,或讓某一張參考圖主導整體構圖。
我們在 WeShop Nano Banana 生成器中測試了一套三參考圖工作流程,使用虛構人物肖像、平鋪服裝照,以及京都雨中街景。最終影像保留了角色的主要身分特徵、帶入所有指定服裝項目,並維持場景中暖色櫥窗與冷色街道的光線對比。唯一明顯的不足是取景:要求的四分之三身肖像,結果更接近近乎全身的構圖。
測試工作流程
圖片 1:人物身分。圖片 2:完整服裝。圖片 3:地點與光線。輸出:一張具明確保留規則的旅遊編輯肖像照。
為何多張參考圖片需要分配角色
「結合這些圖片」這句話留下了太多待決定的空間。更好的提示詞會告訴模型,哪個來源負責結果中的哪個部分。它也會重複說明必須保留下來的少數細節:一顆美人痣、圍巾圖樣、口袋數量、一盞燈籠,或特定的色彩對比。
Google 的 Nano Banana 2.1 模型卡指出,該模型針對多參考圖編輯、角色一致性、產品一致性與一般編輯進行了專門評估。因此,以角色分工方式進行合成是合理的使用情境,但這不代表不需要檢查每一項結果。我們的測試只是一次觀察到的執行結果,並非成功率聲明。
本次測試使用的三張參考圖片
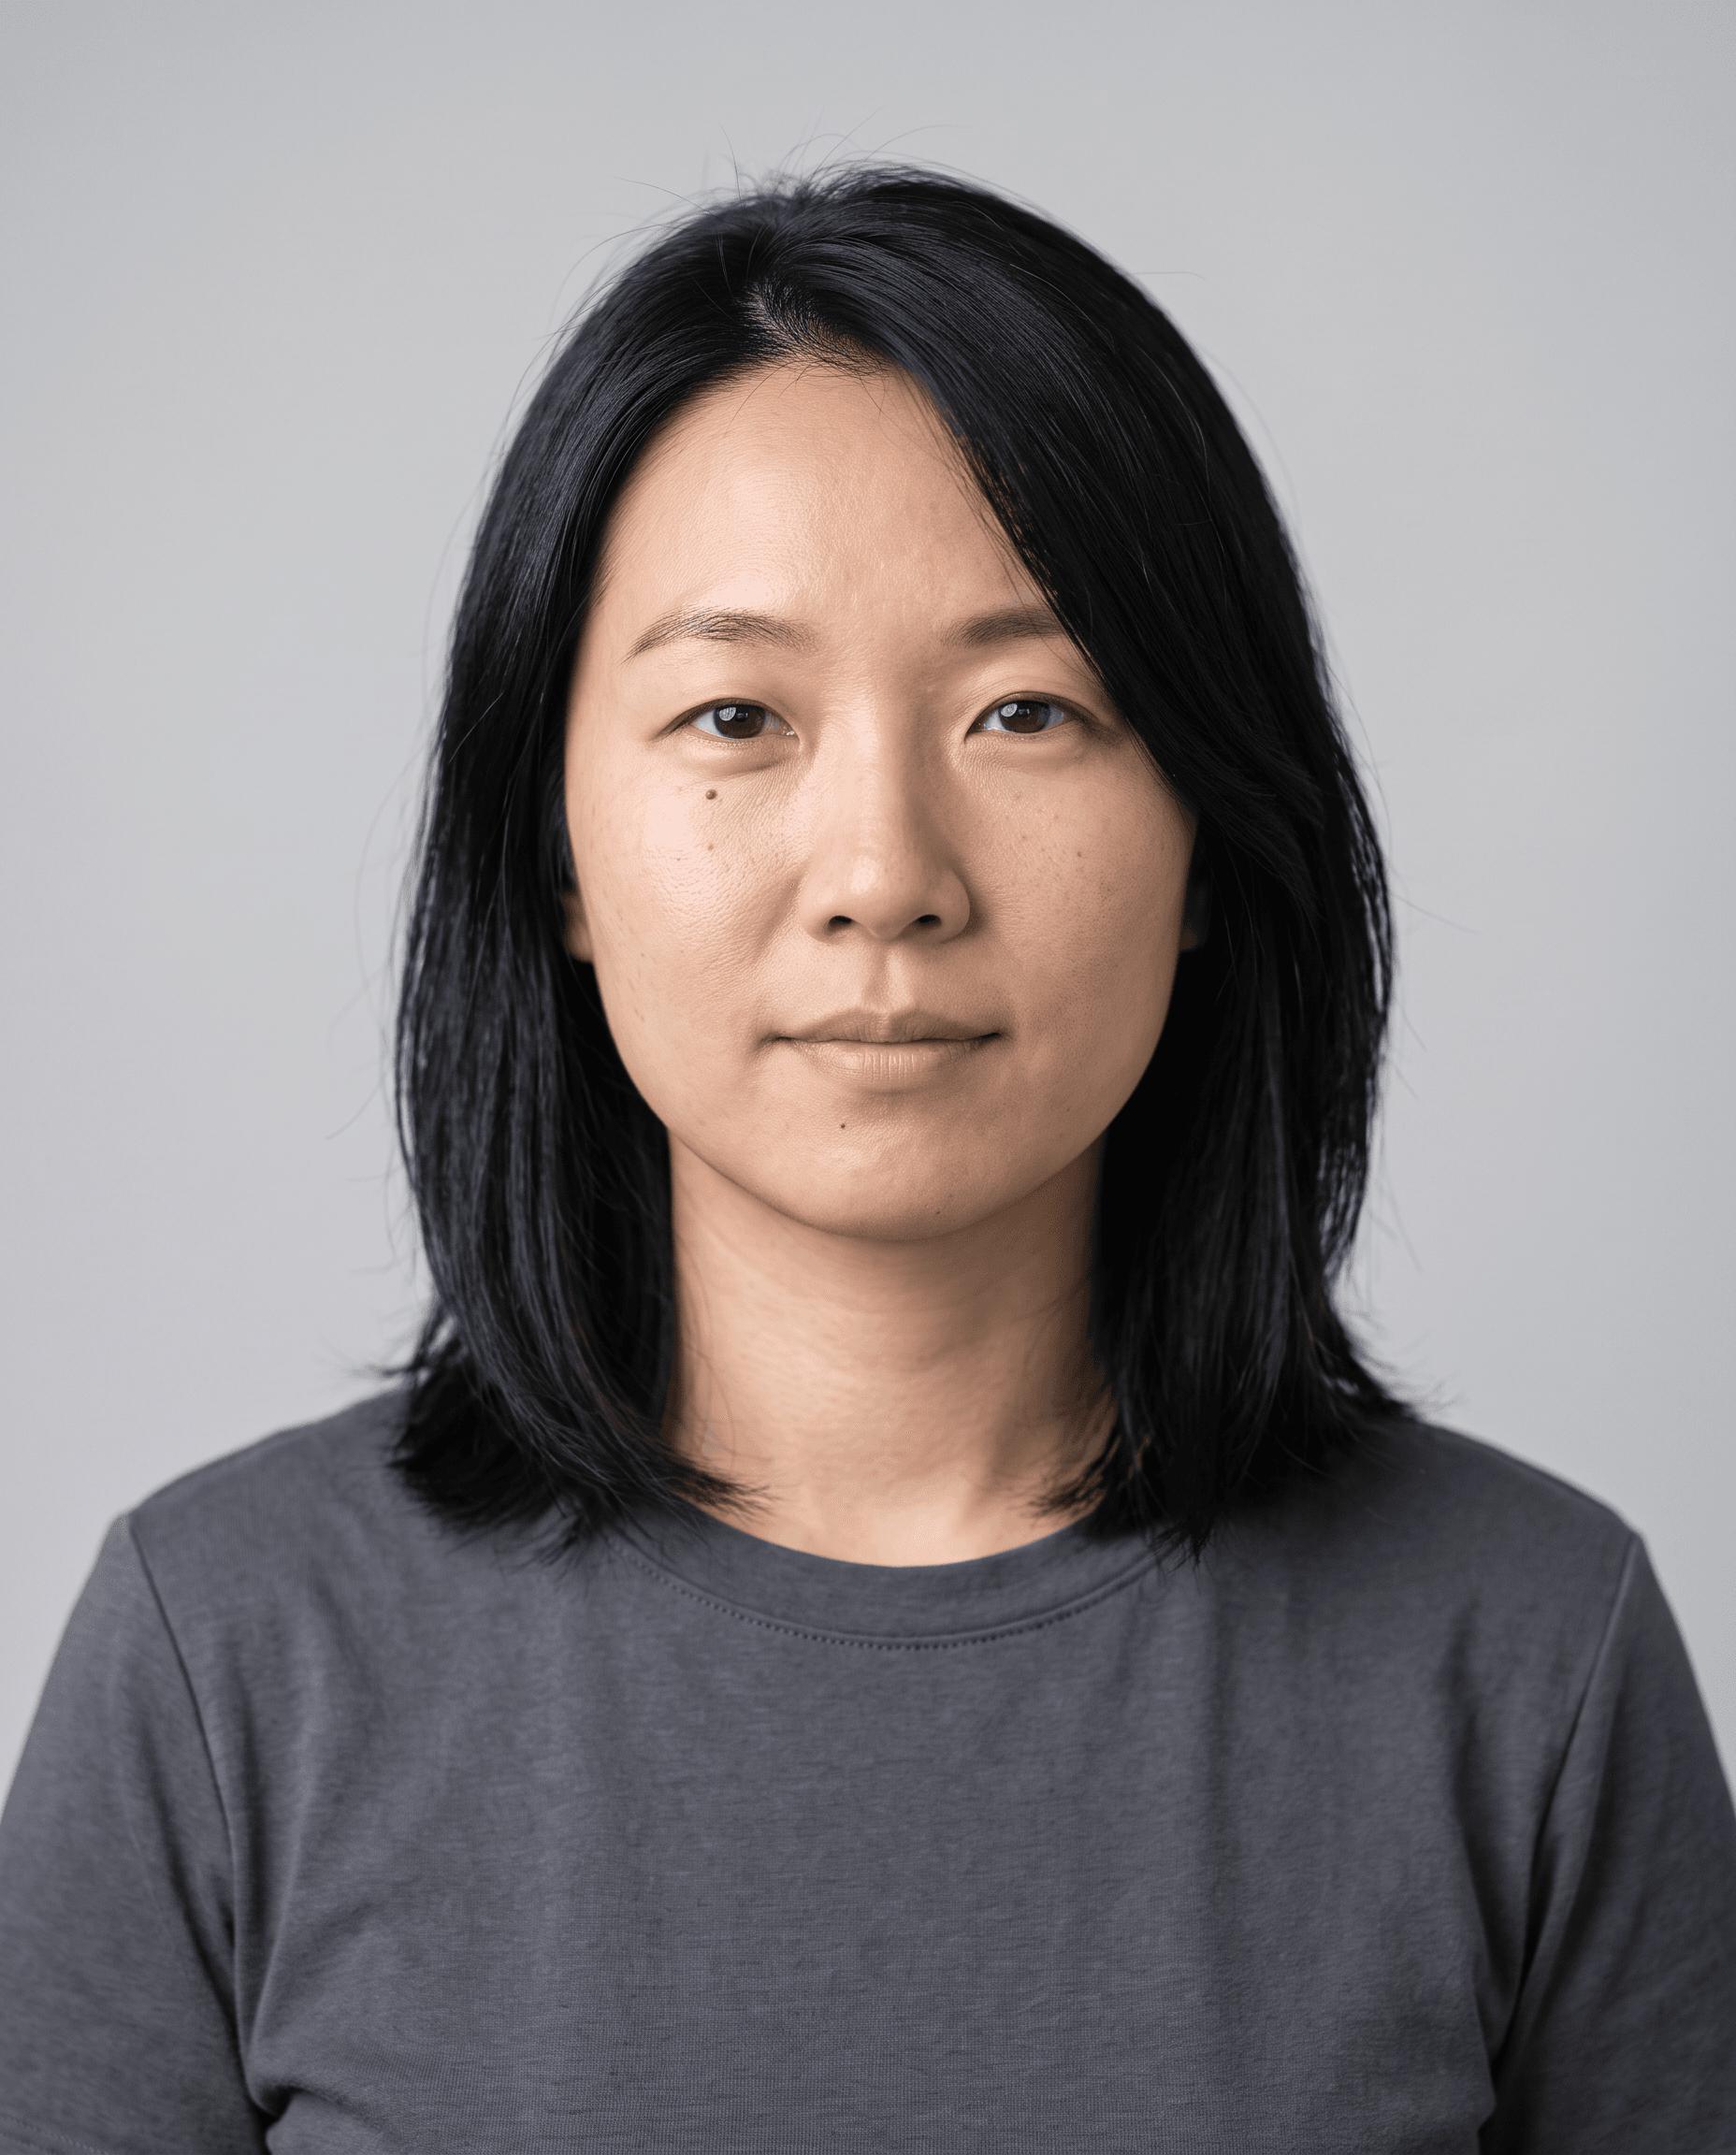
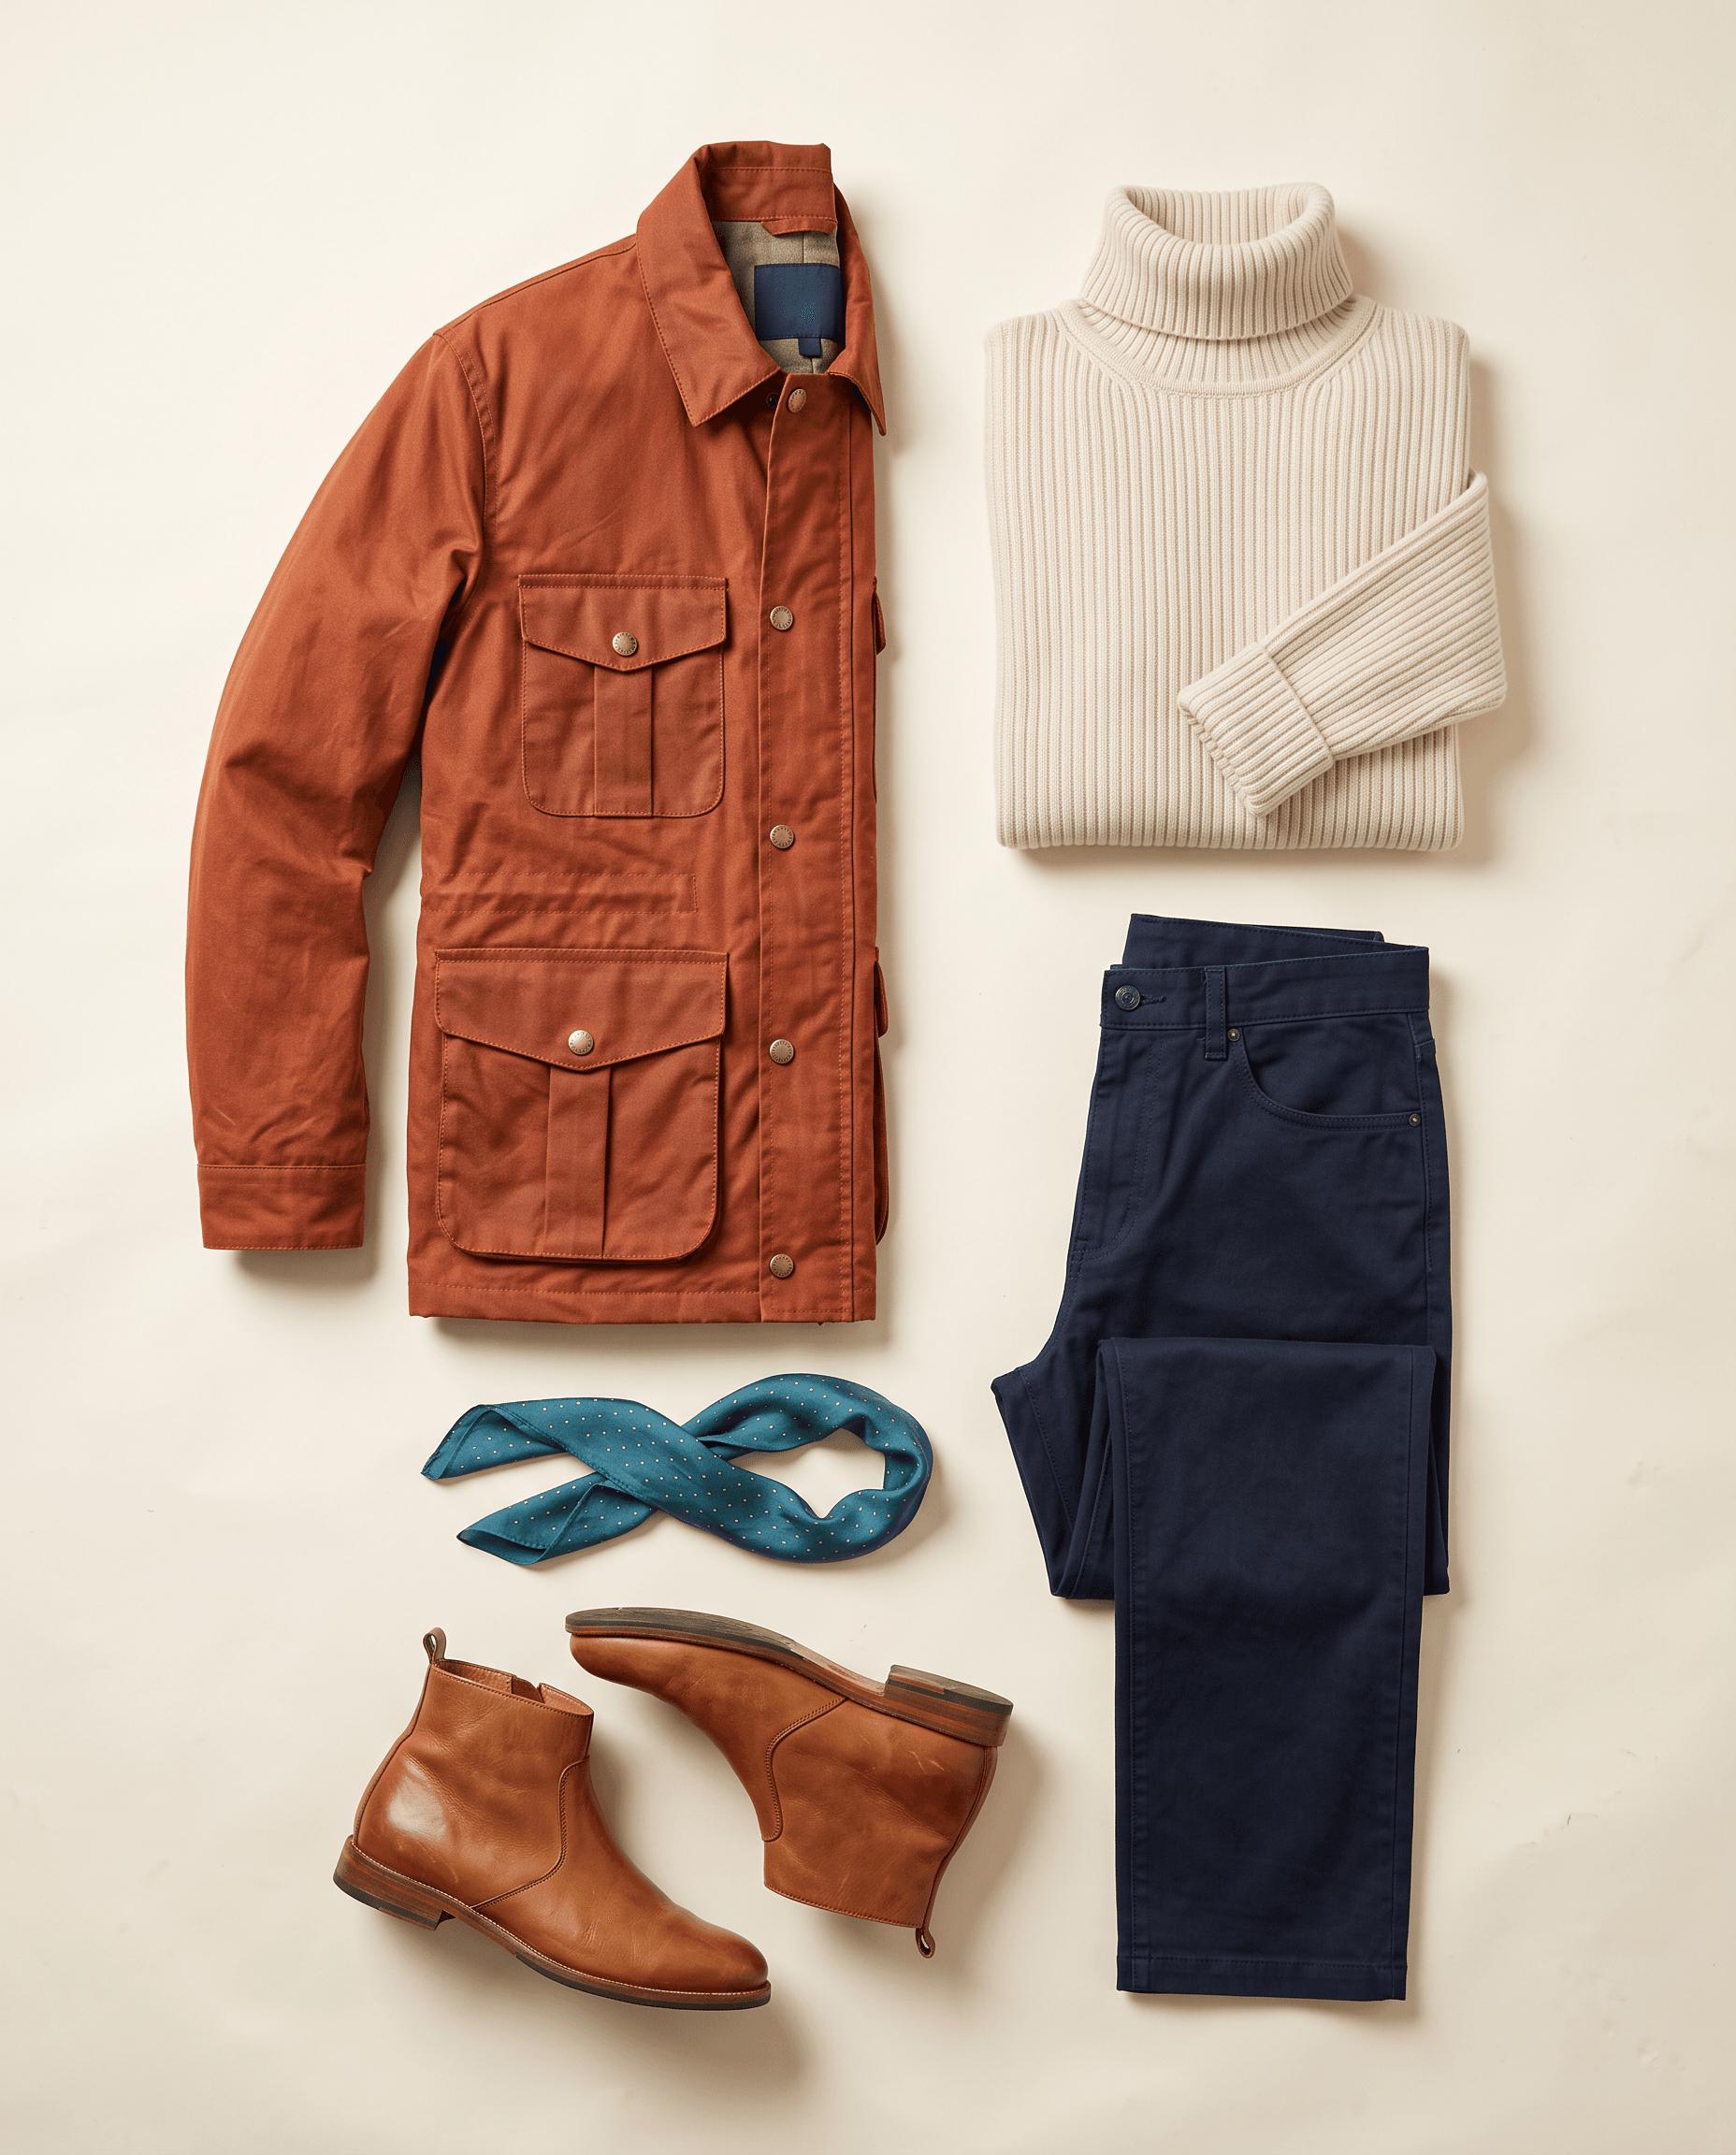
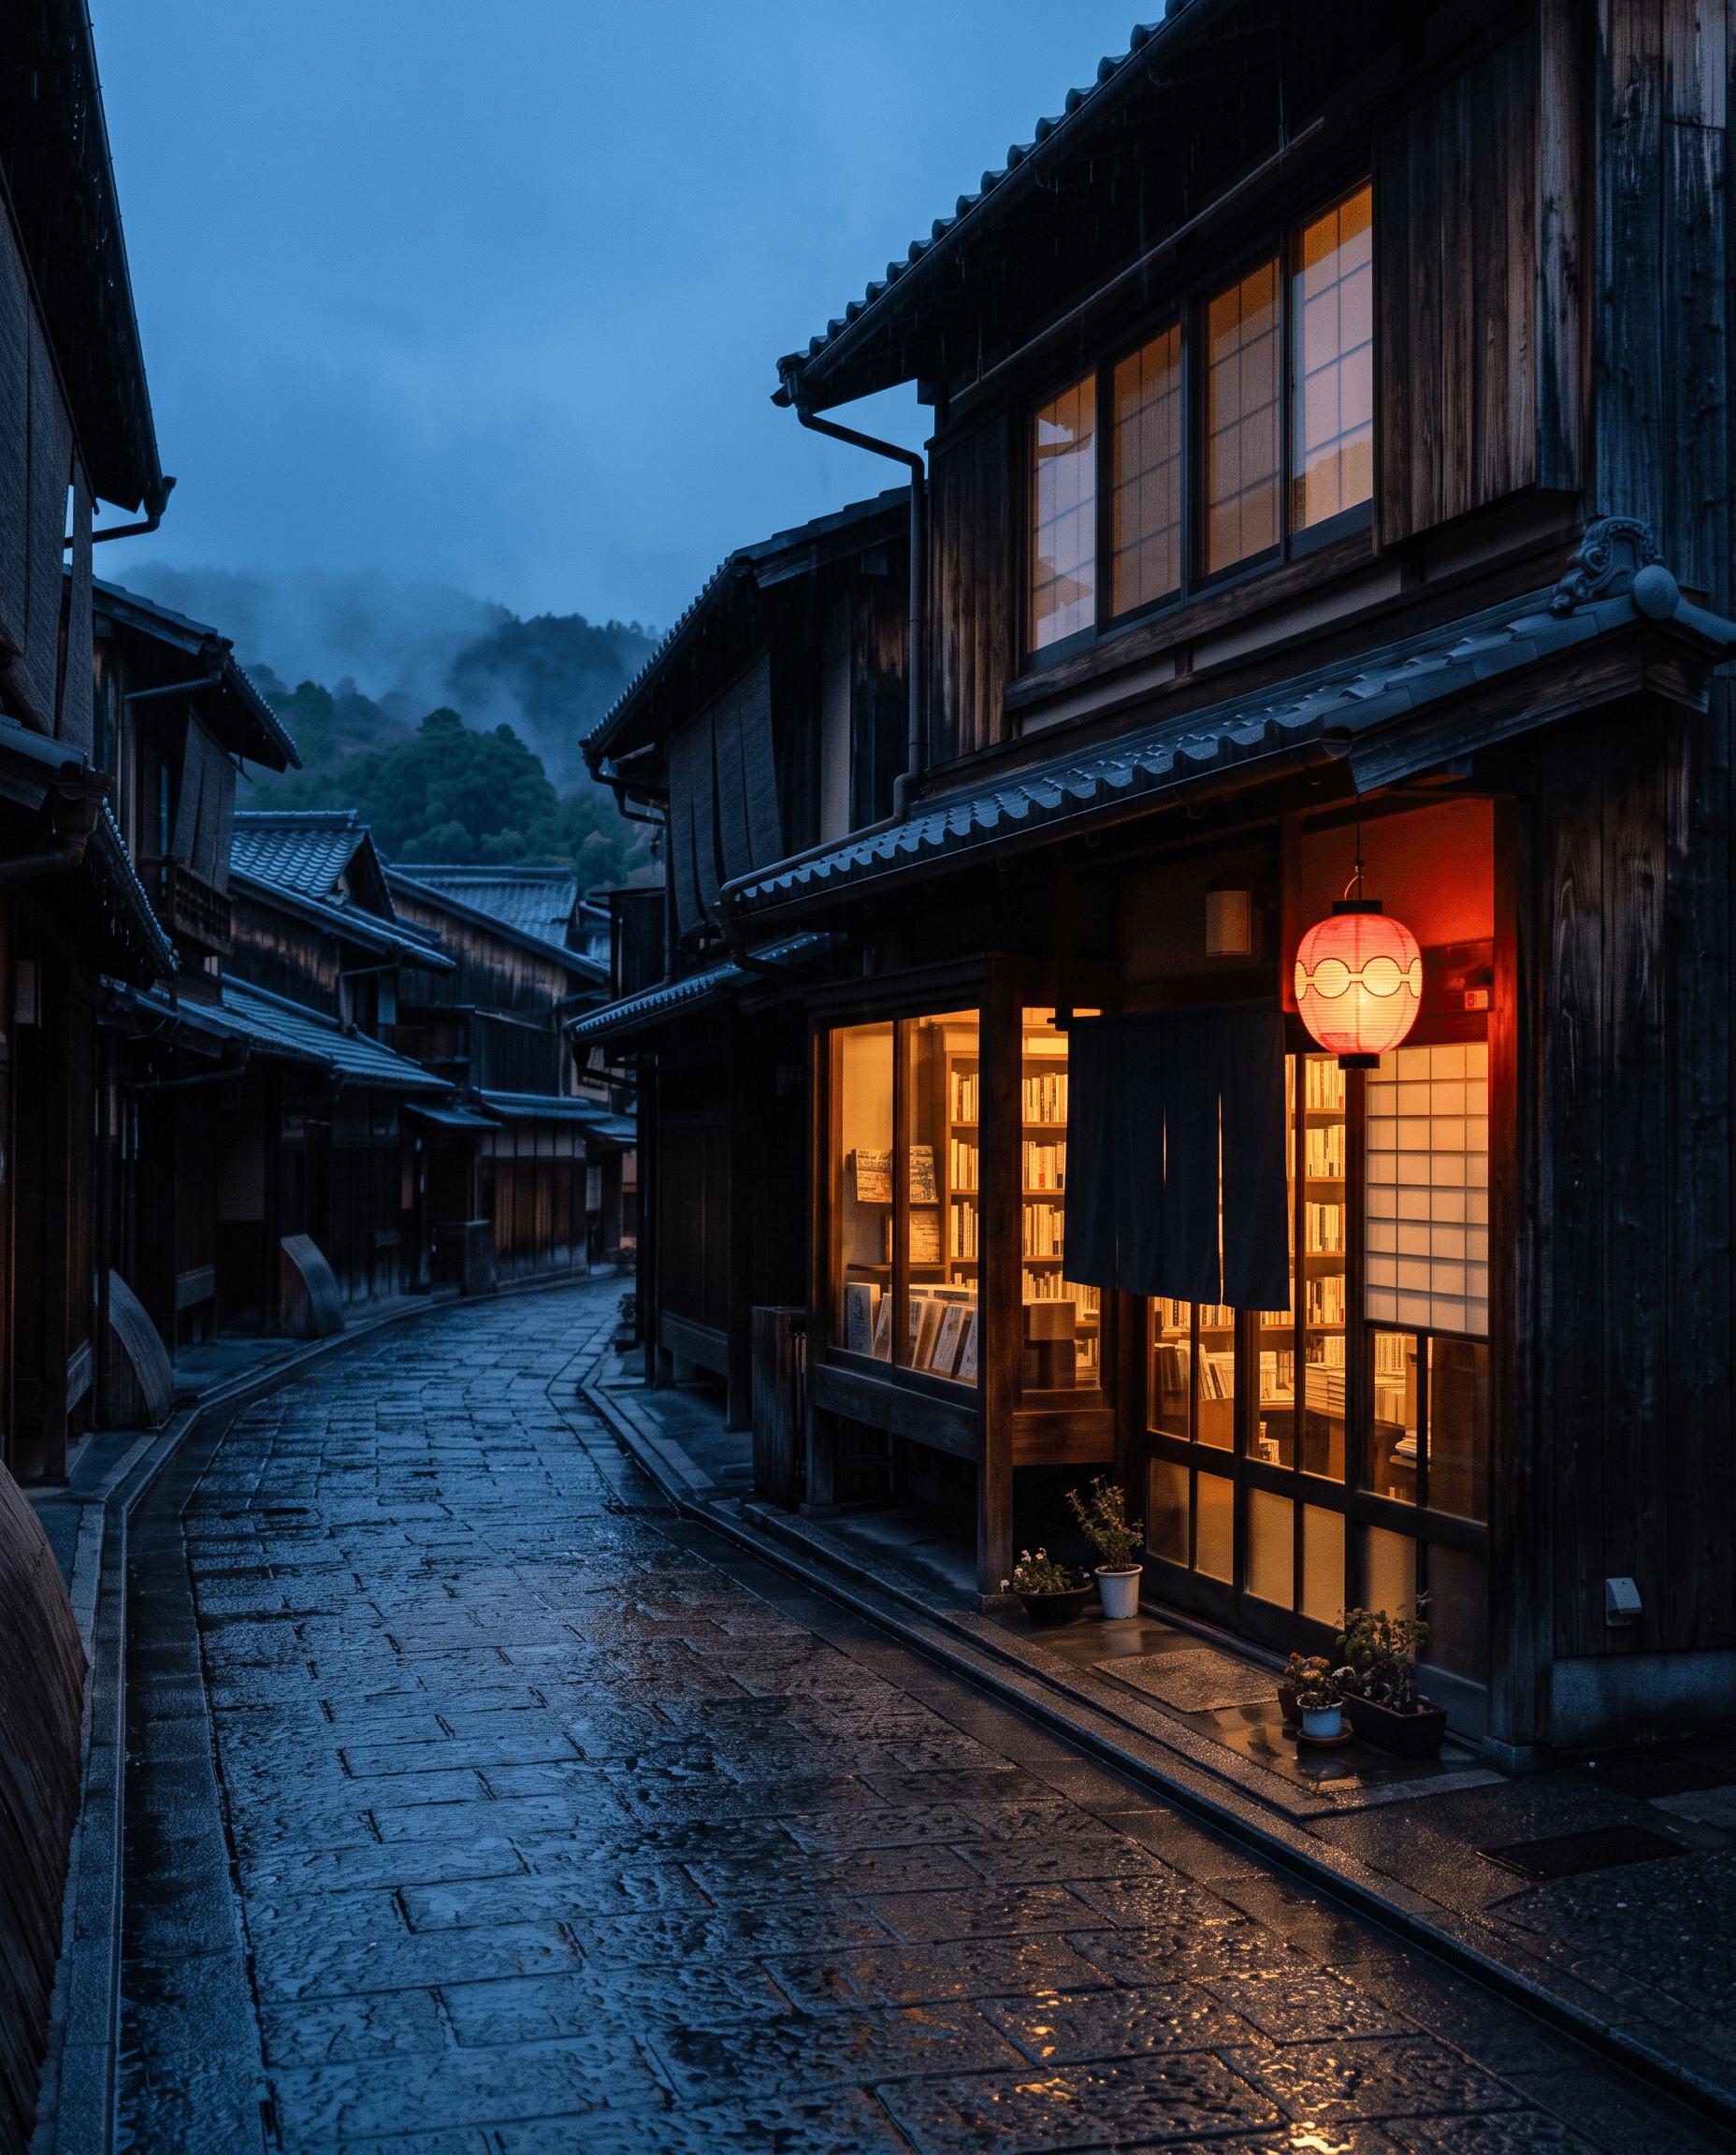
這些參考圖刻意保持乾淨且資訊不重疊。肖像不包含會互相競爭的服裝或地點資訊;服裝以沒有模特兒的平鋪方式呈現;場景中則沒有人物。這能在開始撰寫提示詞前降低歧義。
結合三張參考圖片的提示詞
這種結構之所以有效,是因為它包含四個層次:來源對應、輸出簡述、保留錨點與排除條件。模型無須自行推斷哪張圖片控制哪項特徵。
Nano Banana 2.1 保留了什麼,以及遺漏了什麼
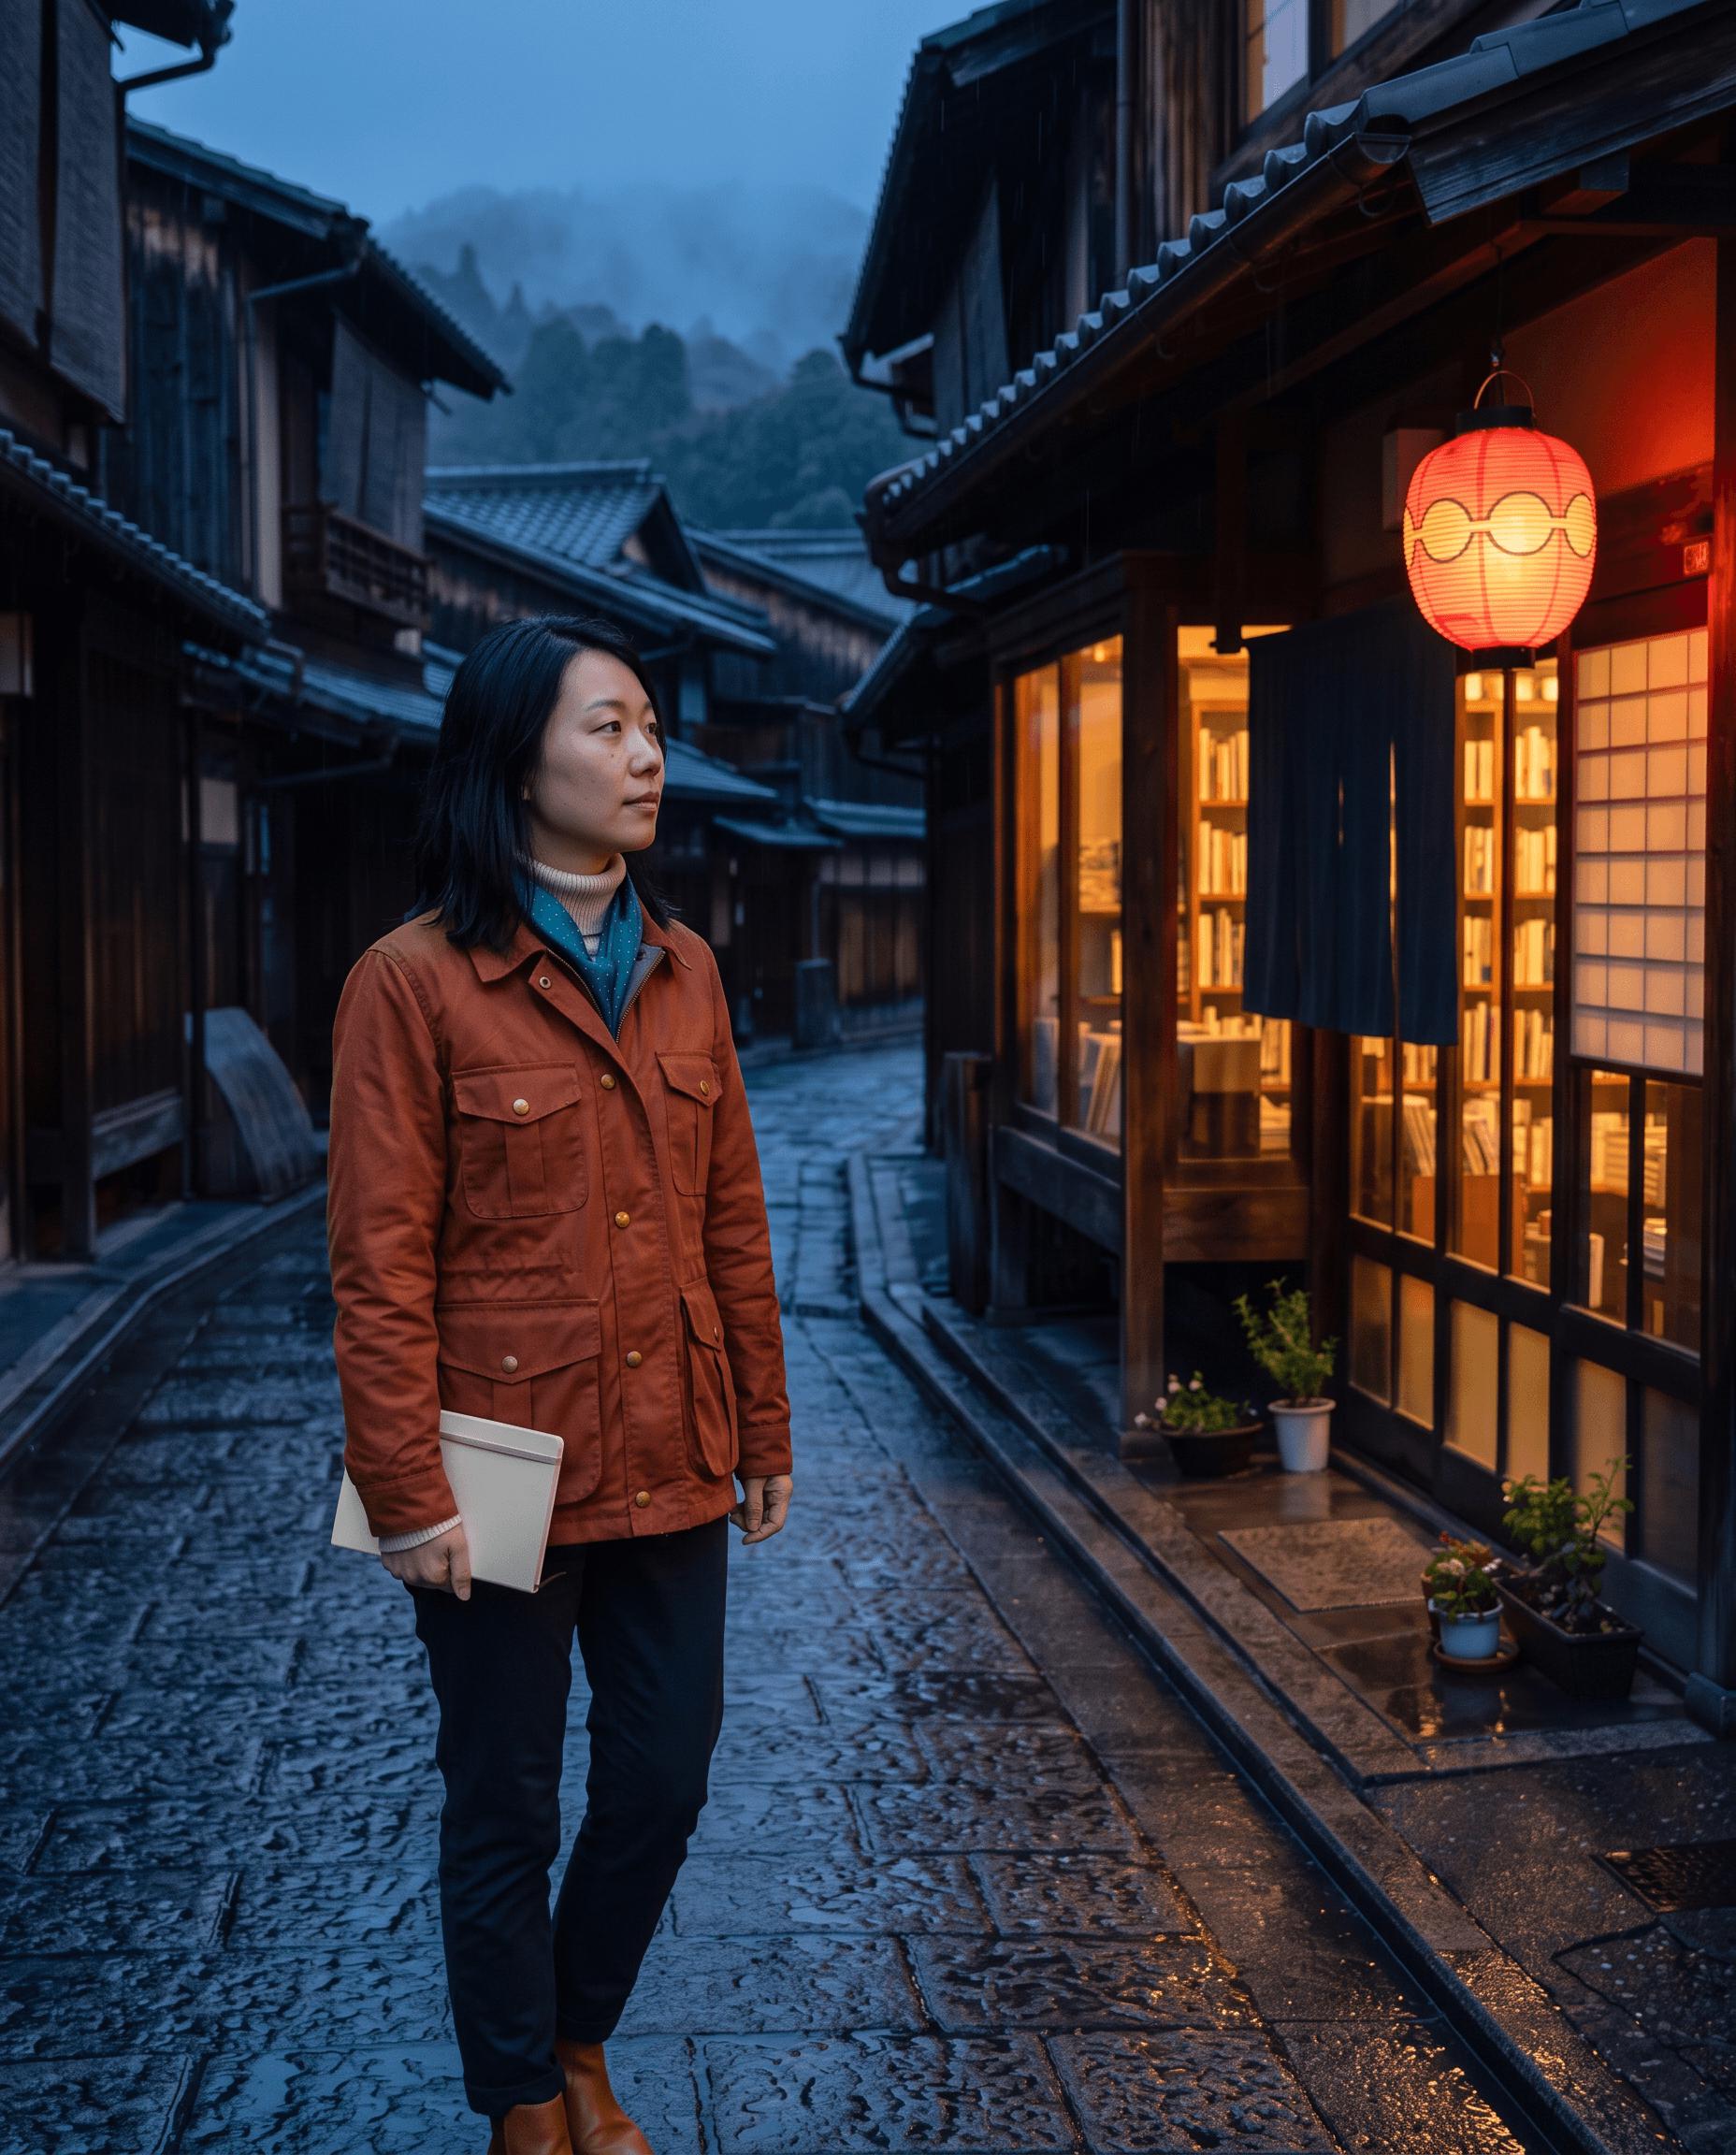
保留效果最強的是那些同時在來源中可見、並於文字中再次說明的細節。圍巾、四口袋外套與美人痣,並非只交由視覺推論決定。取景上的失誤提醒我們:即使影像精緻,仍可能不符合某項製作限制。
可重複使用的多參考圖工作流程
- 為每張參考圖指定一項主要職責。 可使用人物身分、服裝、產品、姿勢、光線或環境等標籤。
- 盡可能移除相互競爭的資訊。 乾淨的服裝平鋪照,比包含另一名人物與地點的繁雜時尚照片更容易解讀。
- 再次說明身分鎖定條件。 指出若被改變就會使輸出無法接受的臉部、物品或服裝細節。
- 獨立描述最終構圖。 參考圖提供素材;提示詞仍需要說明取景、主體位置、視線、鏡頭與光線。
- 加入與可能失敗情況相關的排除條件。 避免額外人物、配件、文字、重複物件或混合材質。
- 逐張參考圖檢查。 先比較人物身分,再比較服裝,最後比較環境,而不是只判斷整體氛圍。
適用於你自己圖片的提示詞範本
常見失敗情況與修正方法
- 人物發生變化: 重複兩到三項身分錨點,並從來源組合中移除其他臉孔。
- 服裝不完整: 列舉每一件必要服裝,以及其關鍵顏色或材質。
- 參考來源被混合: 為每張圖片分配一項明確角色,並說明細節衝突時以哪個來源為準。
- 場景過於通用: 指出兩到三個結構性地標,而不只描述「夜晚的京都」這類氛圍。
- 裁切偏離要求: 同時指定裁切方式與必須保留在畫面內的內容;若不符合便重新生成。
最終重點
多參考圖生成最適合視為一套小型藝術指導系統。圖片提供依據;提示詞分配控制權並定義最終畫面。在這次測試中,Nano Banana 2.1 成功且可信地結合了人物身分、服裝與地點,但取景仍需要人工品質檢查。
如需更完整的提示詞框架,請閱讀 Nano Banana 2.1 提示詞指南。如需經測試的角色工作流程,請參閱 如何建立一致的角色分鏡。