WeShop AIWeShop AI
scroll left

AI 图像

特效

AI 视频

计划和定价

20% OFF

解决方案

资源

下载

Affiliate

API

scroll right
登录
资源
探索帮助您更快完成工作的指南和技巧。
blog
博客
blog
FAQ
feature request
功能请求
jobs
Jobs
app image
随时随地用WeShop AI进行创作
随时随地释放你的创造力。无论是在路上,还是在办公桌前,只需下载WeShop AI,就能将灵感转化为令人惊艳的设计。它强大而灵活,始终伴你左右。
October 16

如何使用 Nano Banana 2.1 合并多张参考图片

一套经过测试的 Nano Banana 2.1 工作流,可合并身份、服装和地点参考,同时不丢失关键细节。

将多张参考图合成为一张可信的图片,并不只是上传更多文件那么简单。每张图片都需要有明确分工:一张控制人物身份,另一张控制服装,还有一张控制环境。没有这份角色分配图,模型可能会混合细节、遗漏配饰,或让某一张参考图主导整体构图。

我们在 WeShop Nano Banana 生成器中测试了一个三参考图工作流,使用了一张虚构人物肖像、一套平铺服装和一条雨中的京都街道。最终图片保留了角色的主要身份特征,呈现了所有指定服装单品,并保留了场景中暖色窗光与冷色街道的光线对比。唯一明显的不足是取景:要求的四分之三肖像最终更接近近乎全身的构图。

经过测试的工作流

图片 1:身份。图片 2:完整服装。图片 3:地点与光线。输出:一张具有明确保留规则的旅行杂志风肖像。

为什么多张参考图片需要分配角色

“合并这些图片”这句话留下了太多需要模型自行决定的内容。更有效的提示词会告诉模型,每个来源分别负责最终结果的哪个部分。它还会重复强调必须保留的少数细节:一颗美人痣、围巾图案、口袋数量、一盏灯笼,或某种特定的色彩对比。

Google 的 Nano Banana 2.1 模型卡报告了针对多参考图编辑、角色一致性、产品一致性和通用编辑的专项评估。因此,基于角色分工的合成是合理的使用场景,但这并不意味着无需检查每一张结果。我们的测试只是一次实际运行观察,并非成功率声明。

本次测试使用的三张参考图片
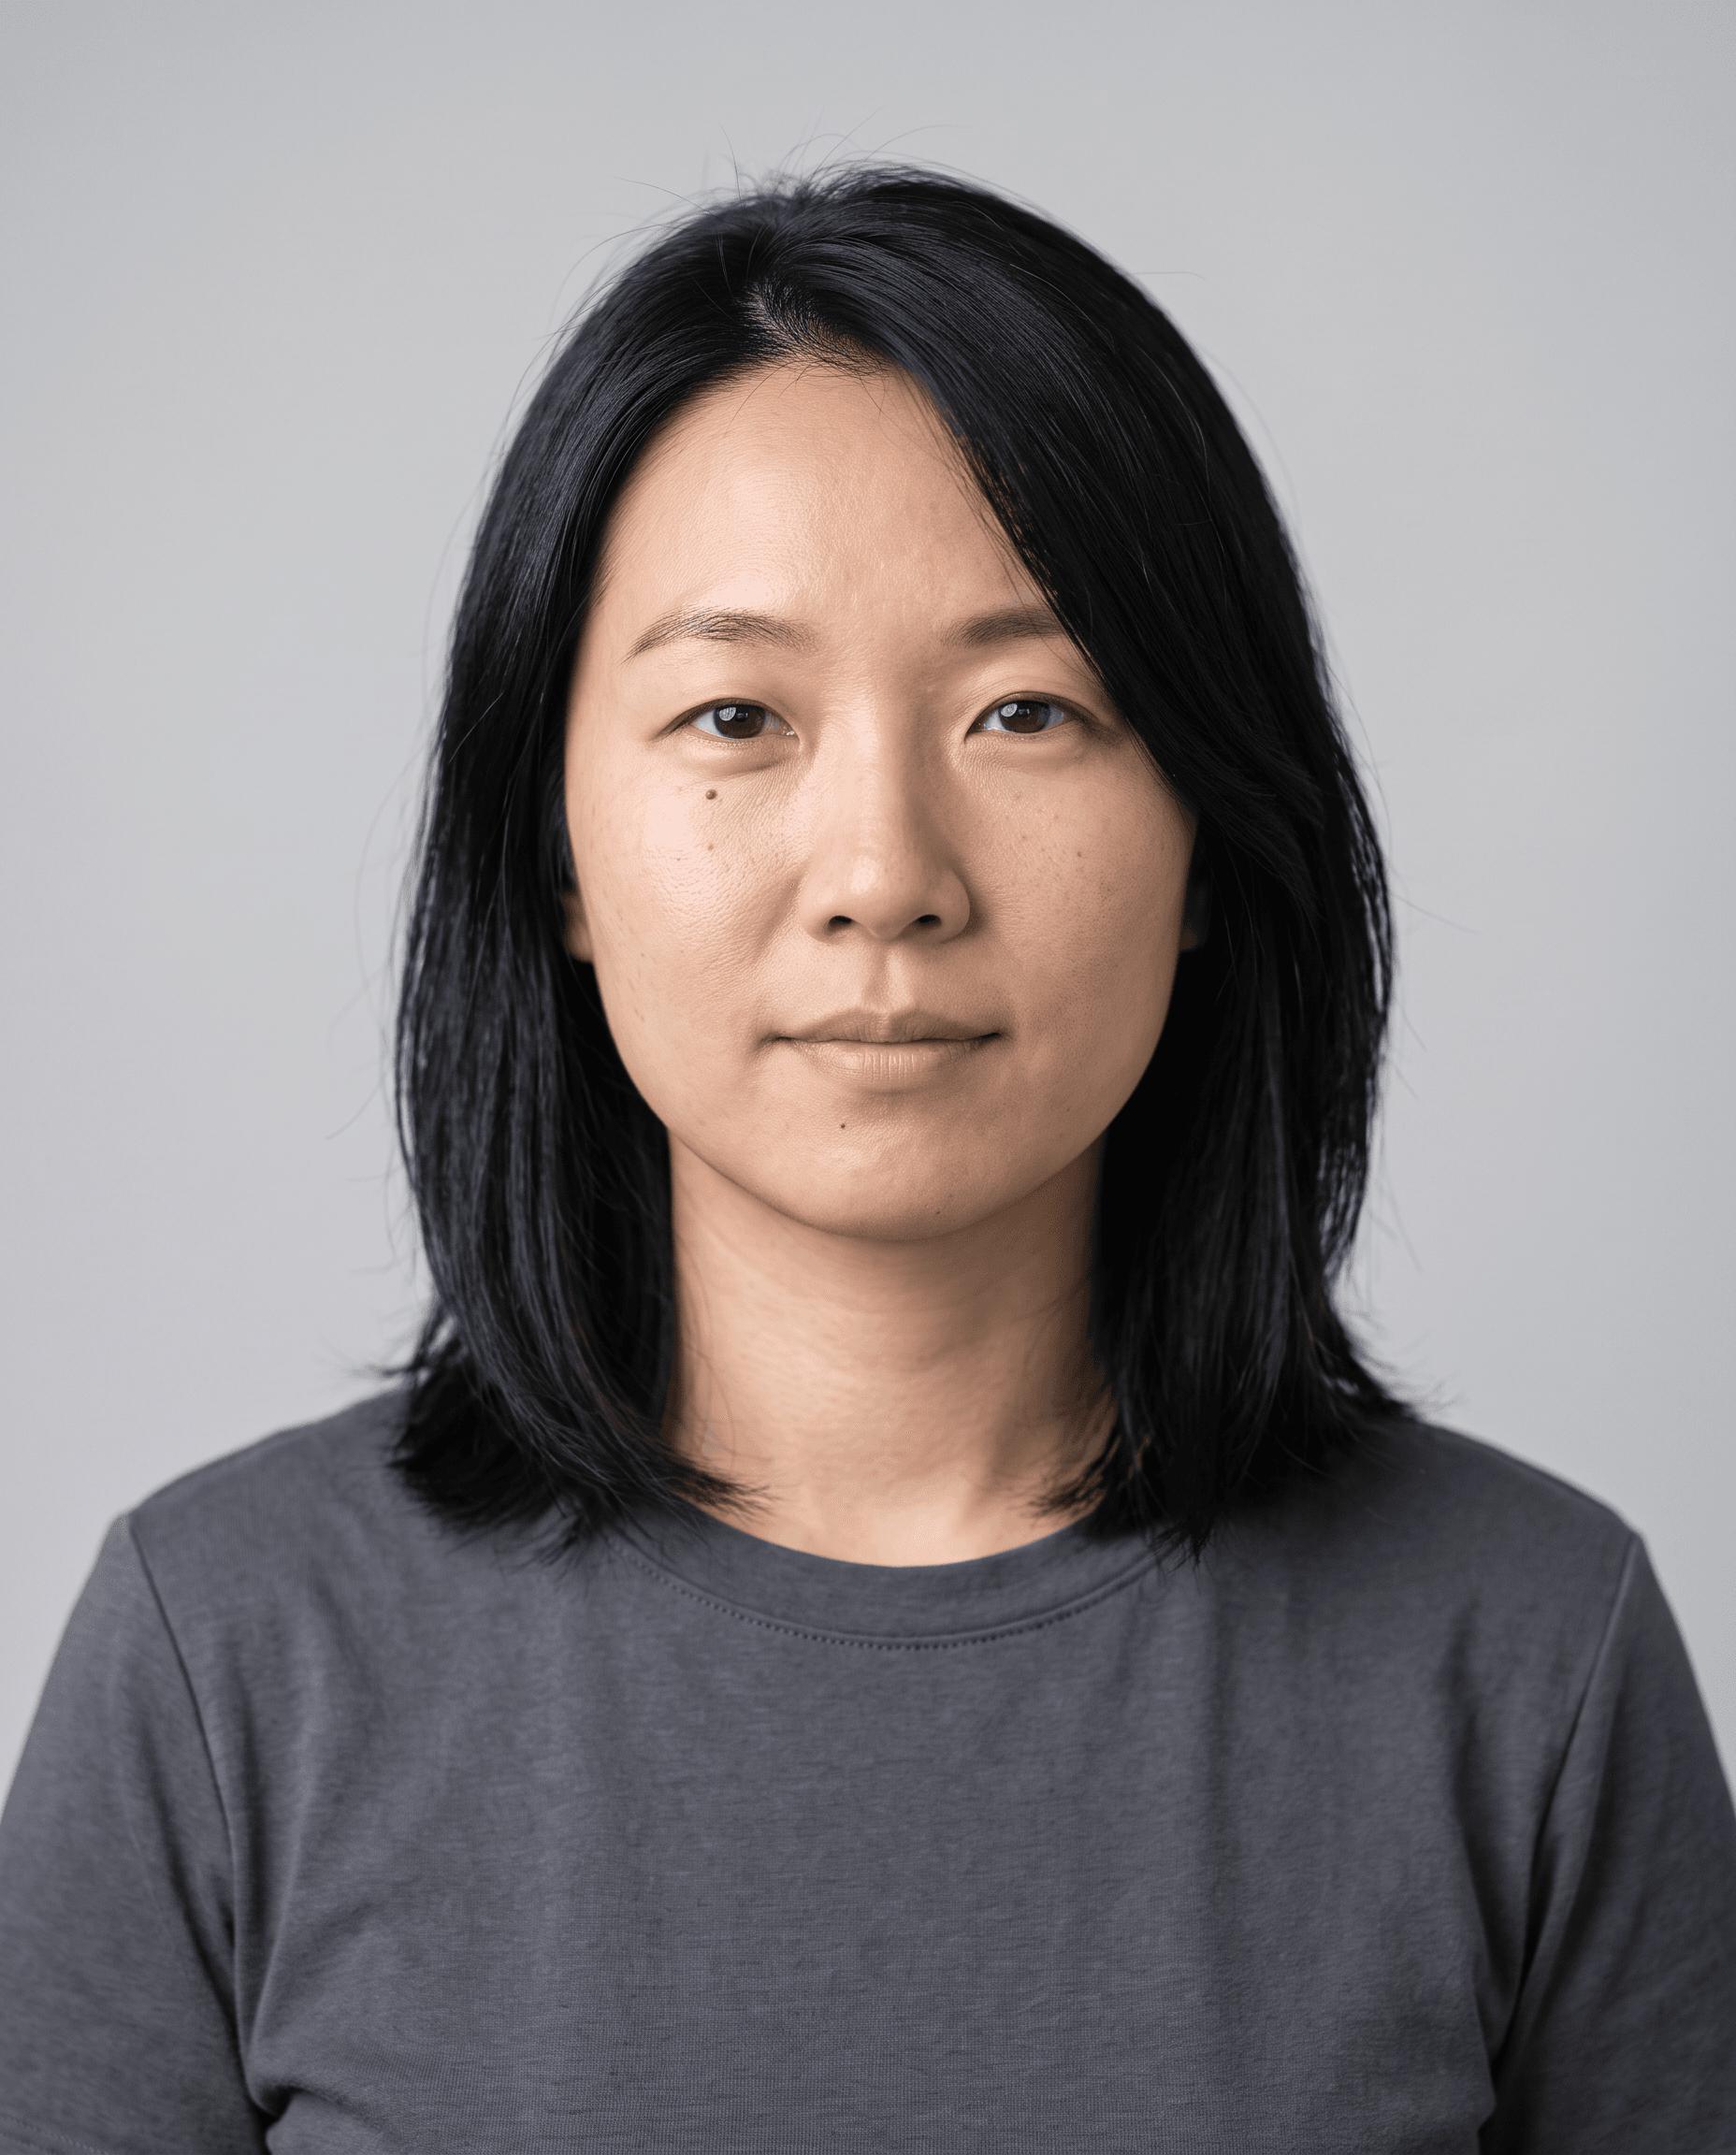
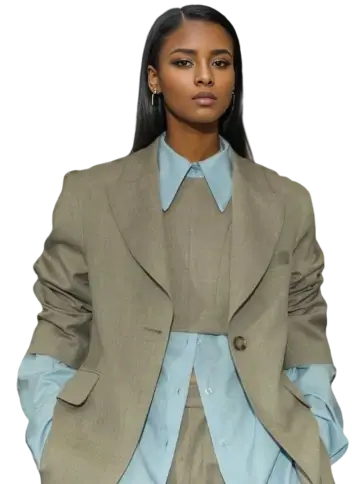
Fictional woman used as the identity reference for Nano Banana 2.1
Reference 1 — identity. Face shape, shoulder-length hair, side part, and beauty mark.
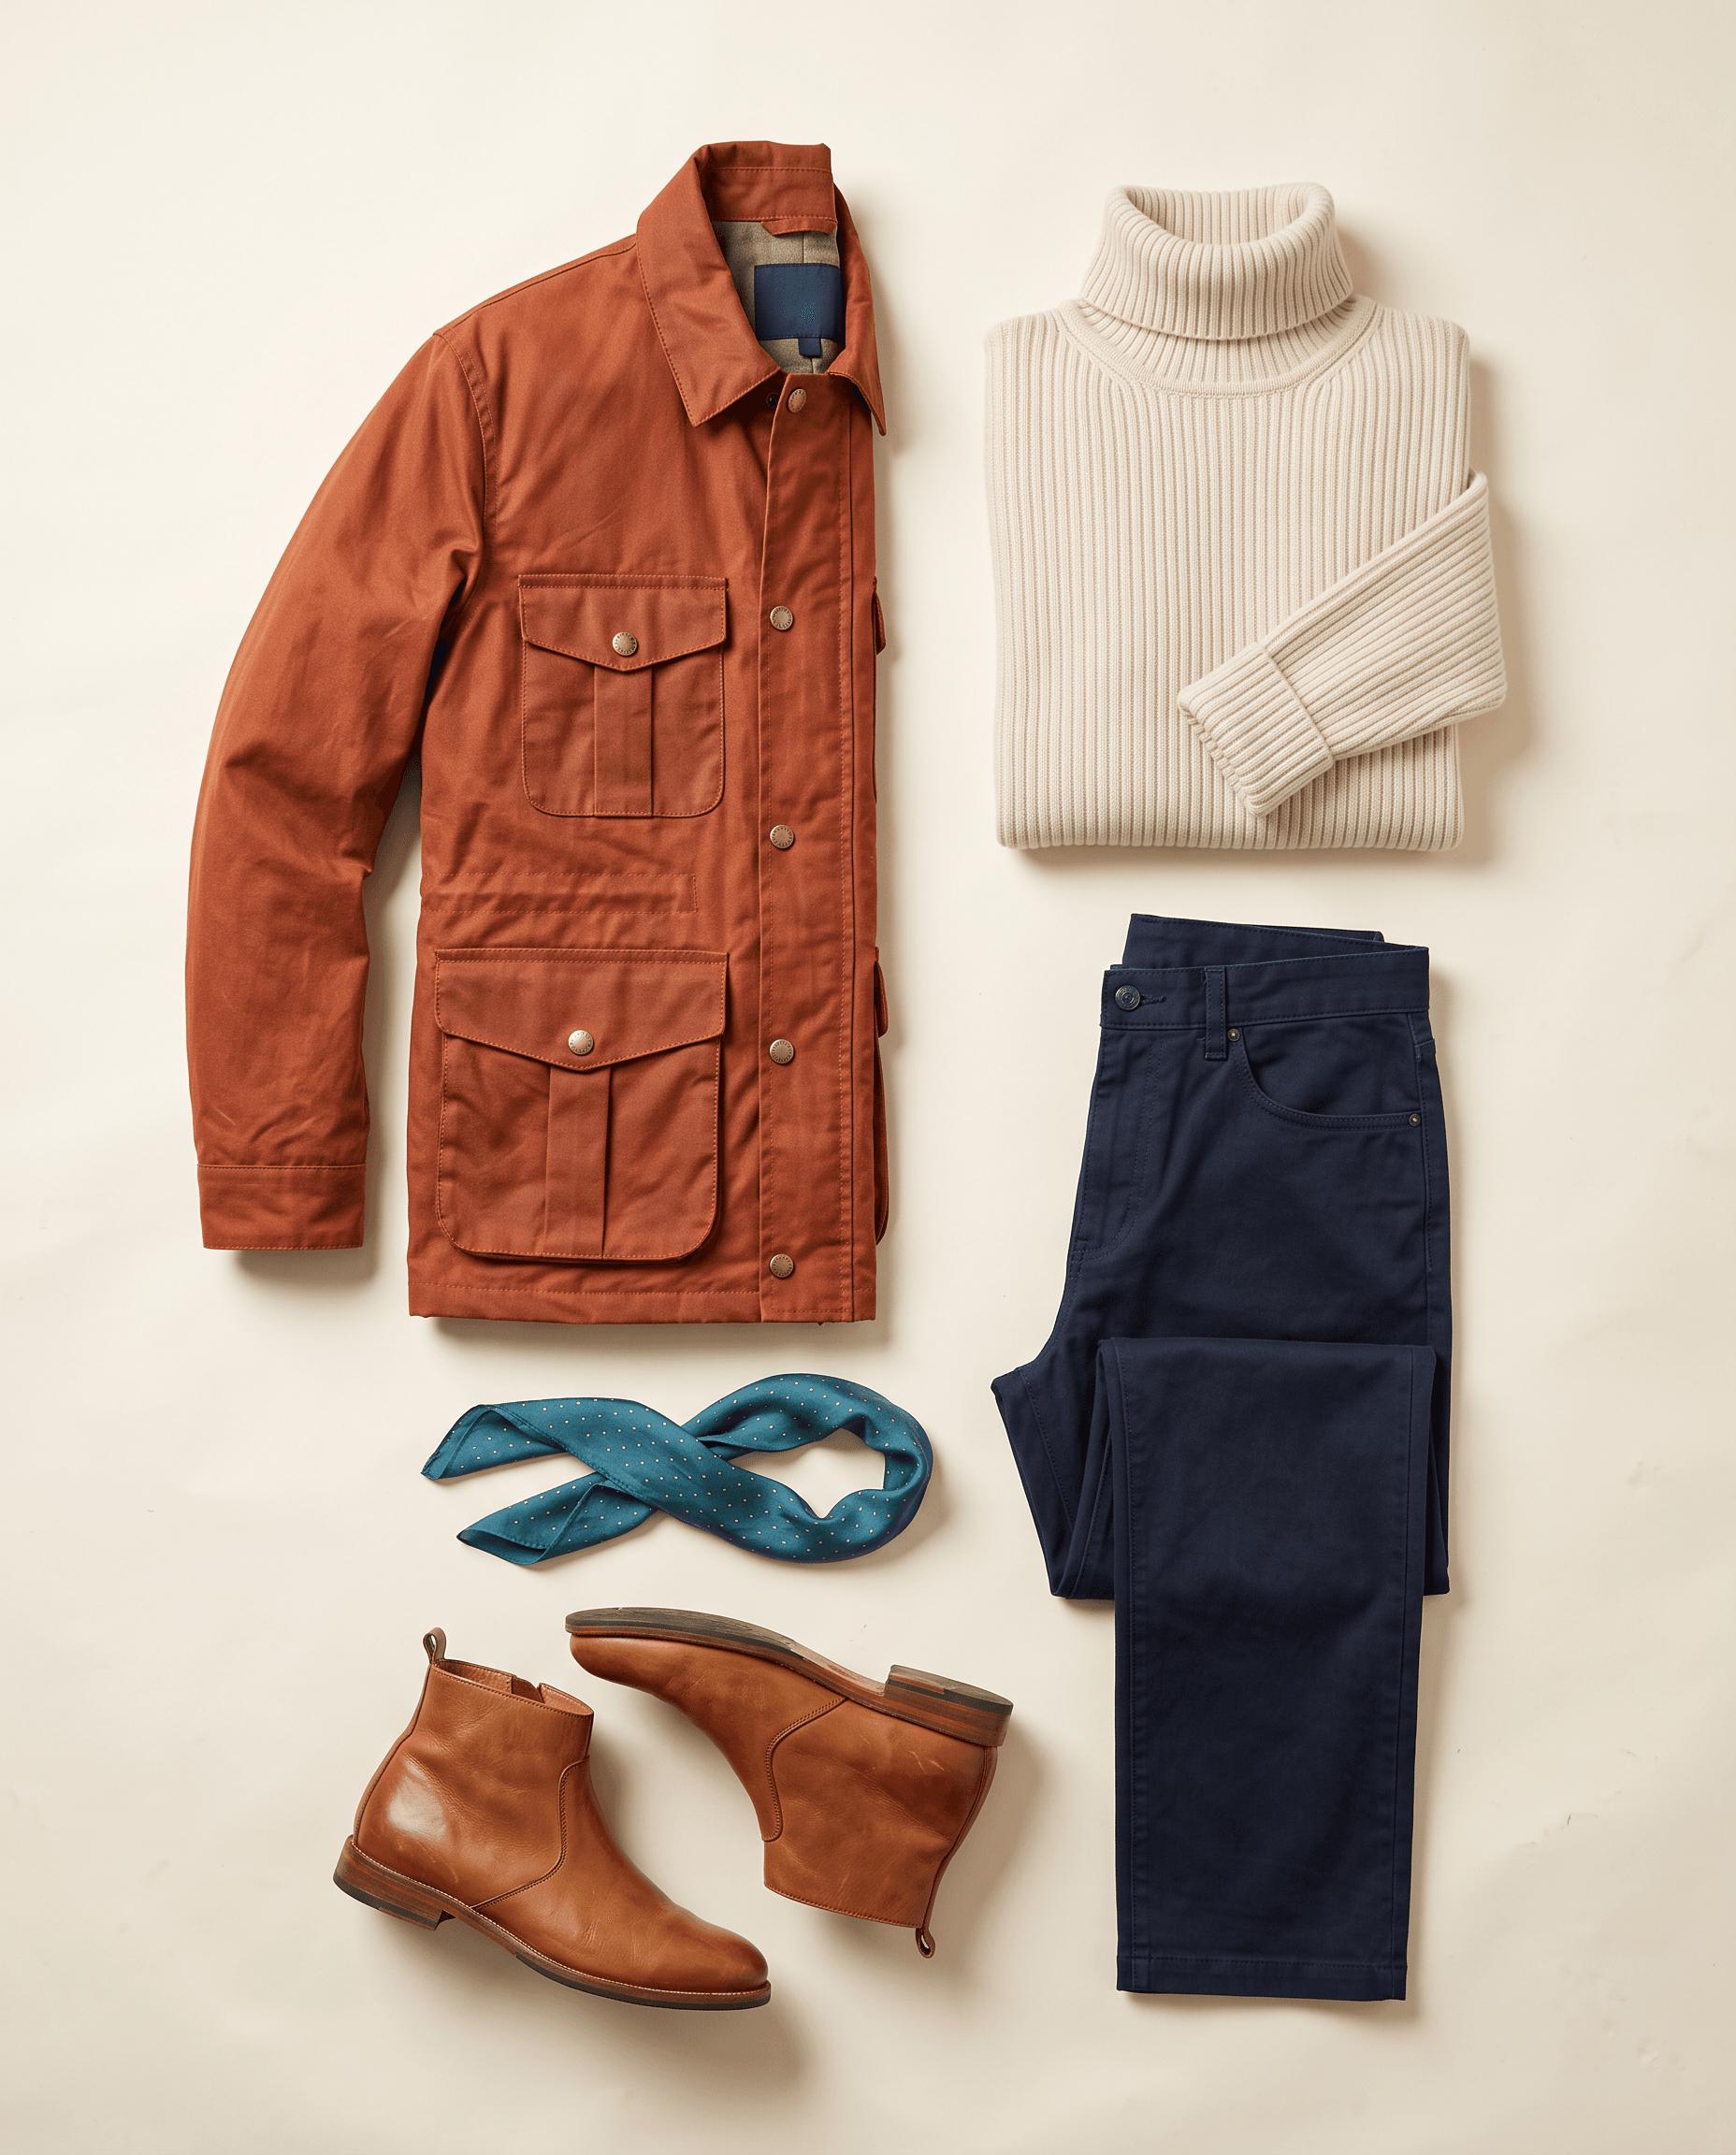
Flat-lay travel outfit used as the wardrobe reference
Reference 2 — wardrobe. Orange jacket, cream turtleneck, navy trousers, teal scarf, and tan boots.
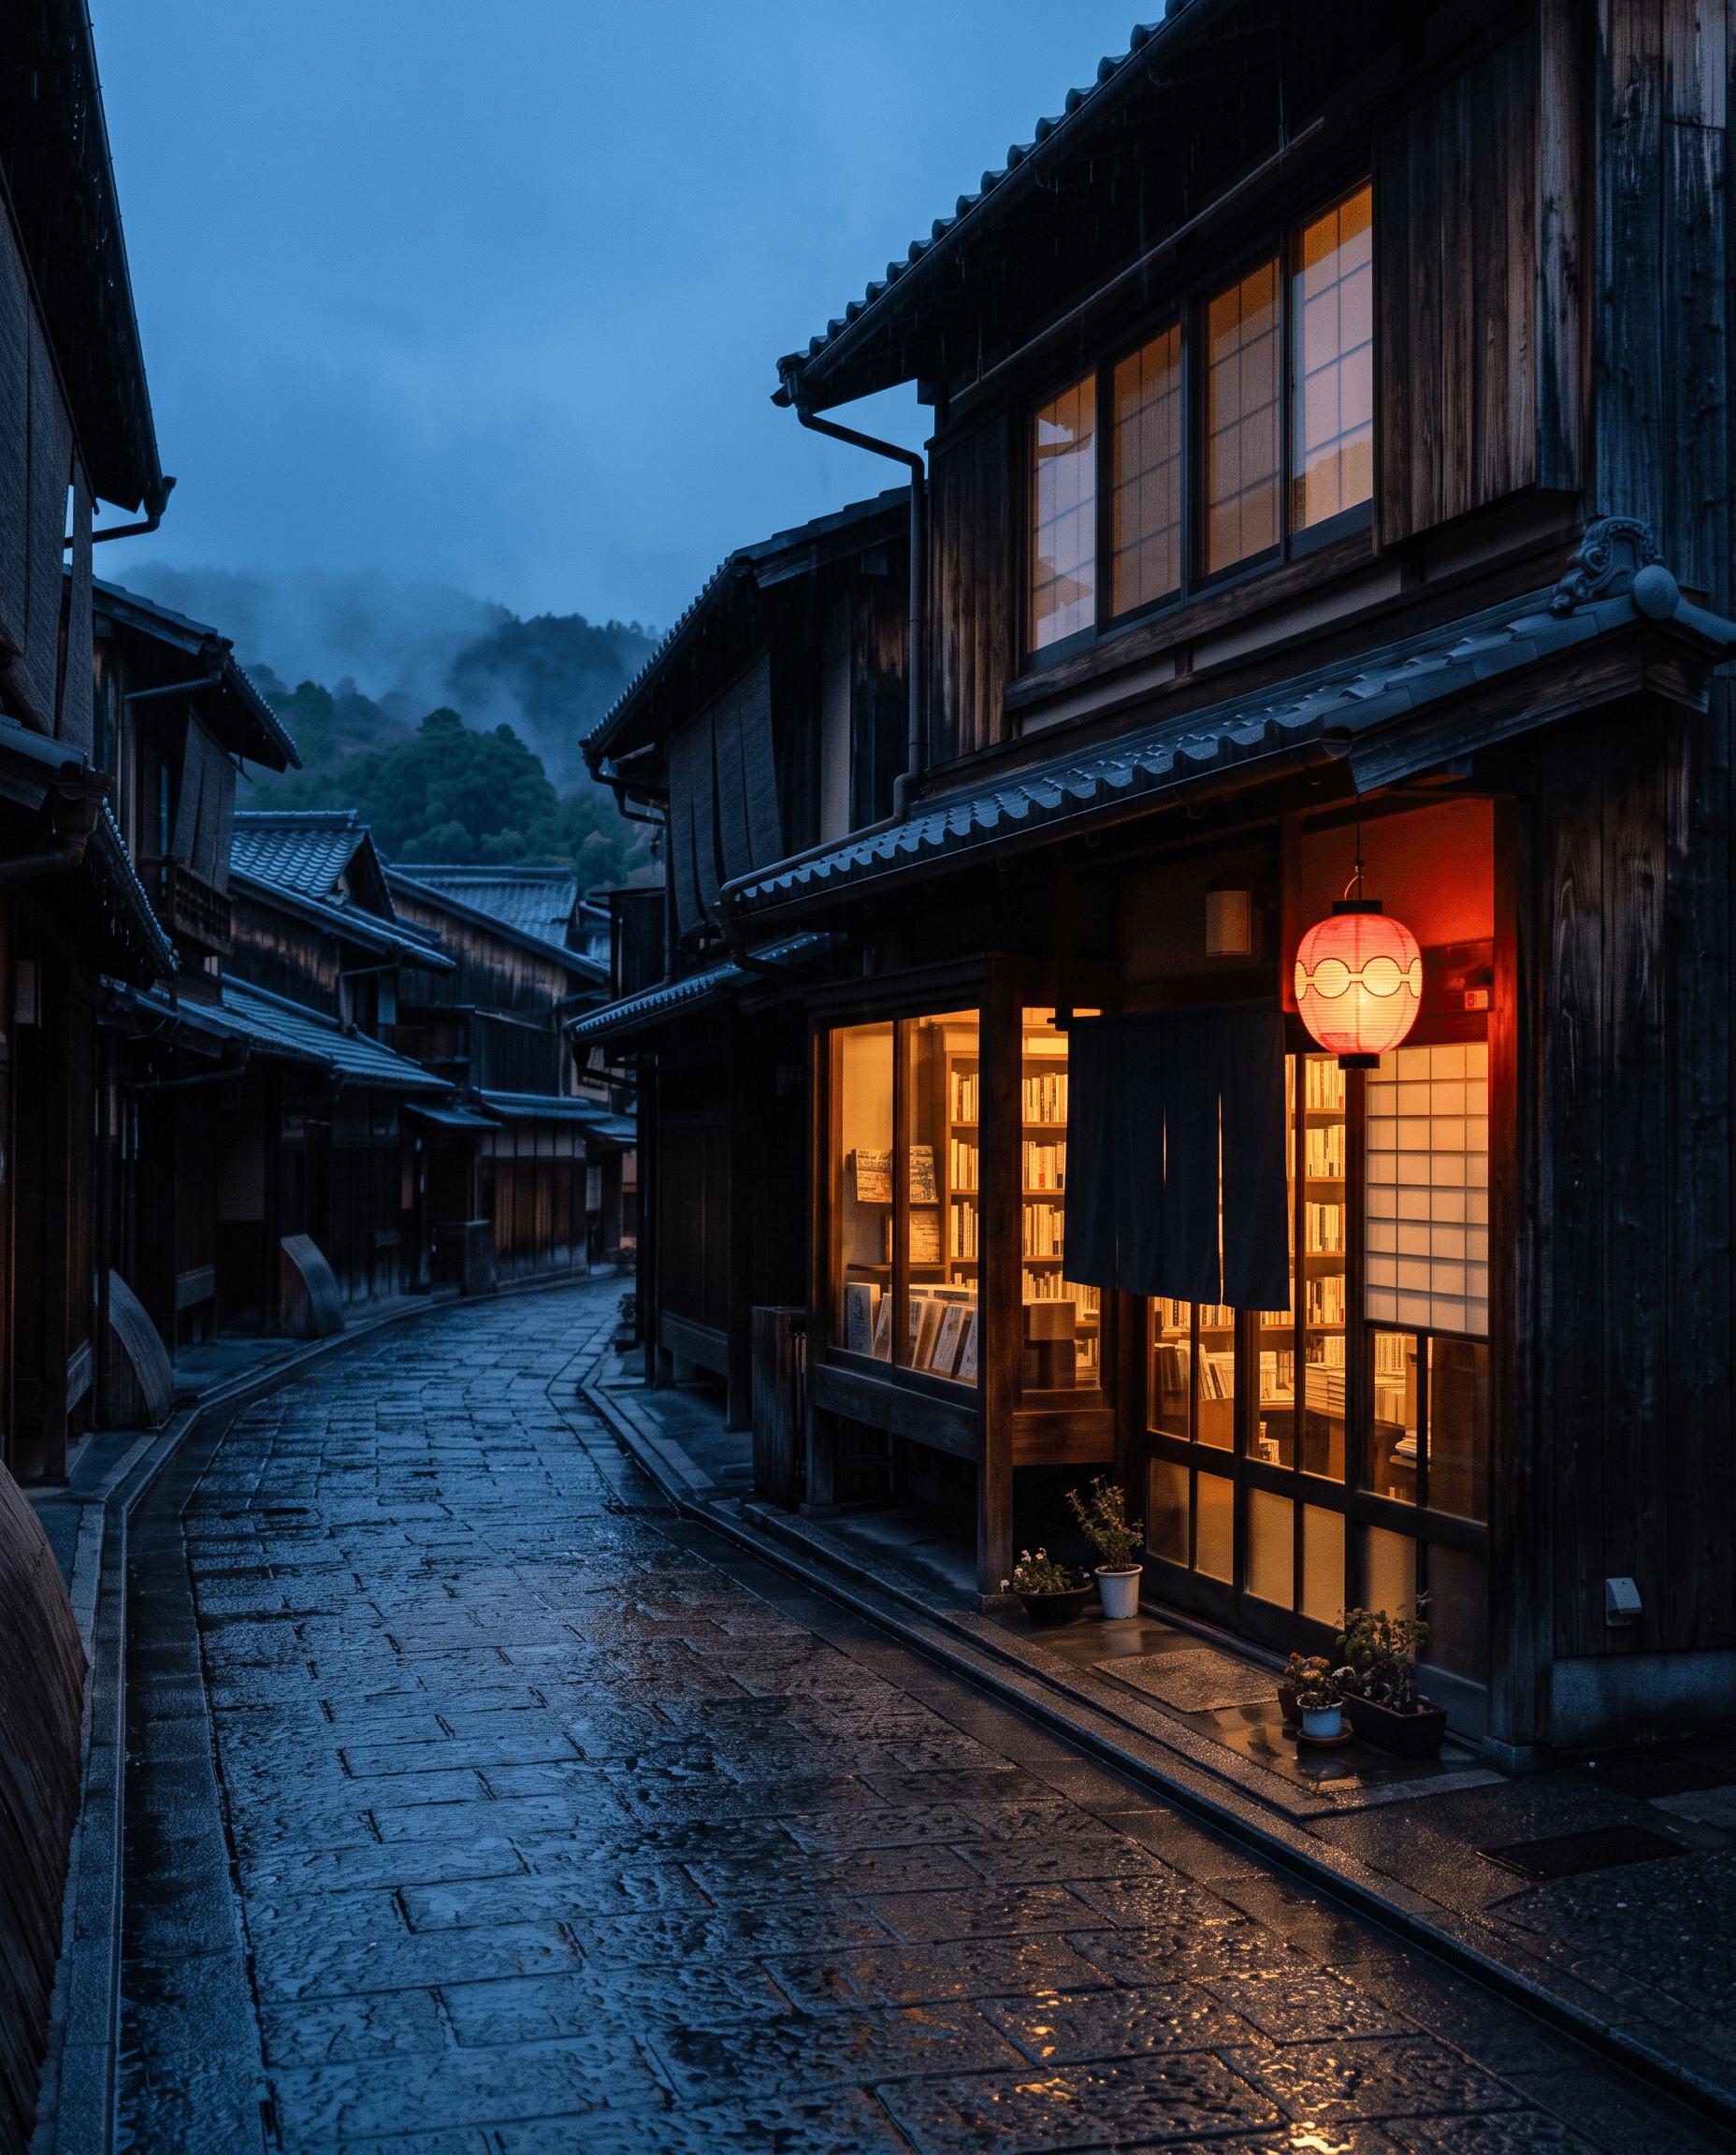
Rainy Kyoto street used as the location reference
Reference 3 — scene. Bookshop, wet stone lane, one red lantern, and blue-hour light.

这些参考图经过刻意选择,画面干净且彼此信息不重叠。肖像中不包含会造成干扰的服装或地点。服装以无人物的平铺形式展示。场景中没有人物。这能在开始编写提示词之前减少歧义。

合并全部三张参考图的提示词

可复制的多参考图提示词
图片 1 是身份参考。图片 2 是服装参考。图片 3 是地点参考。

创建一张完成度高的 4:5 写实旅行杂志风肖像:图 1 中完全相同的女性在蓝调时刻站在图 3 中书店外,身穿图 2 中的完整服装:焦橙色四口袋蜡感夹克、奶油色罗纹高领毛衣、藏青色长裤、带细小金色圆点的青绿色围巾,以及棕褐色短靴。

以四分之三身构图将她置于画面左侧三分之一处,她一侧手持一本合上的奶油色笔记本,望向温暖的店铺橱窗。保留她的脸型、齐肩黑发、侧分发型,以及左眼下方的美人痣。保留街道布局、一盏红色灯笼、湿润石路的倒影,以及暖色橱窗与冷色街道的色彩对比。

自然的 50mm 旅行摄影风格,小雨。不要添加其他人物、包、帽子或额外配饰;不要出现可读标识、文字、Logo 或水印。不要将服装融入背景,也不要改变女性的身份特征。

这一结构之所以有效,是因为它包含四个层面:来源映射、输出简报、保留锚点和排除项。模型无需自行推断哪张图片控制哪项特征。

Nano Banana 2.1 保留了什么——又遗漏了什么
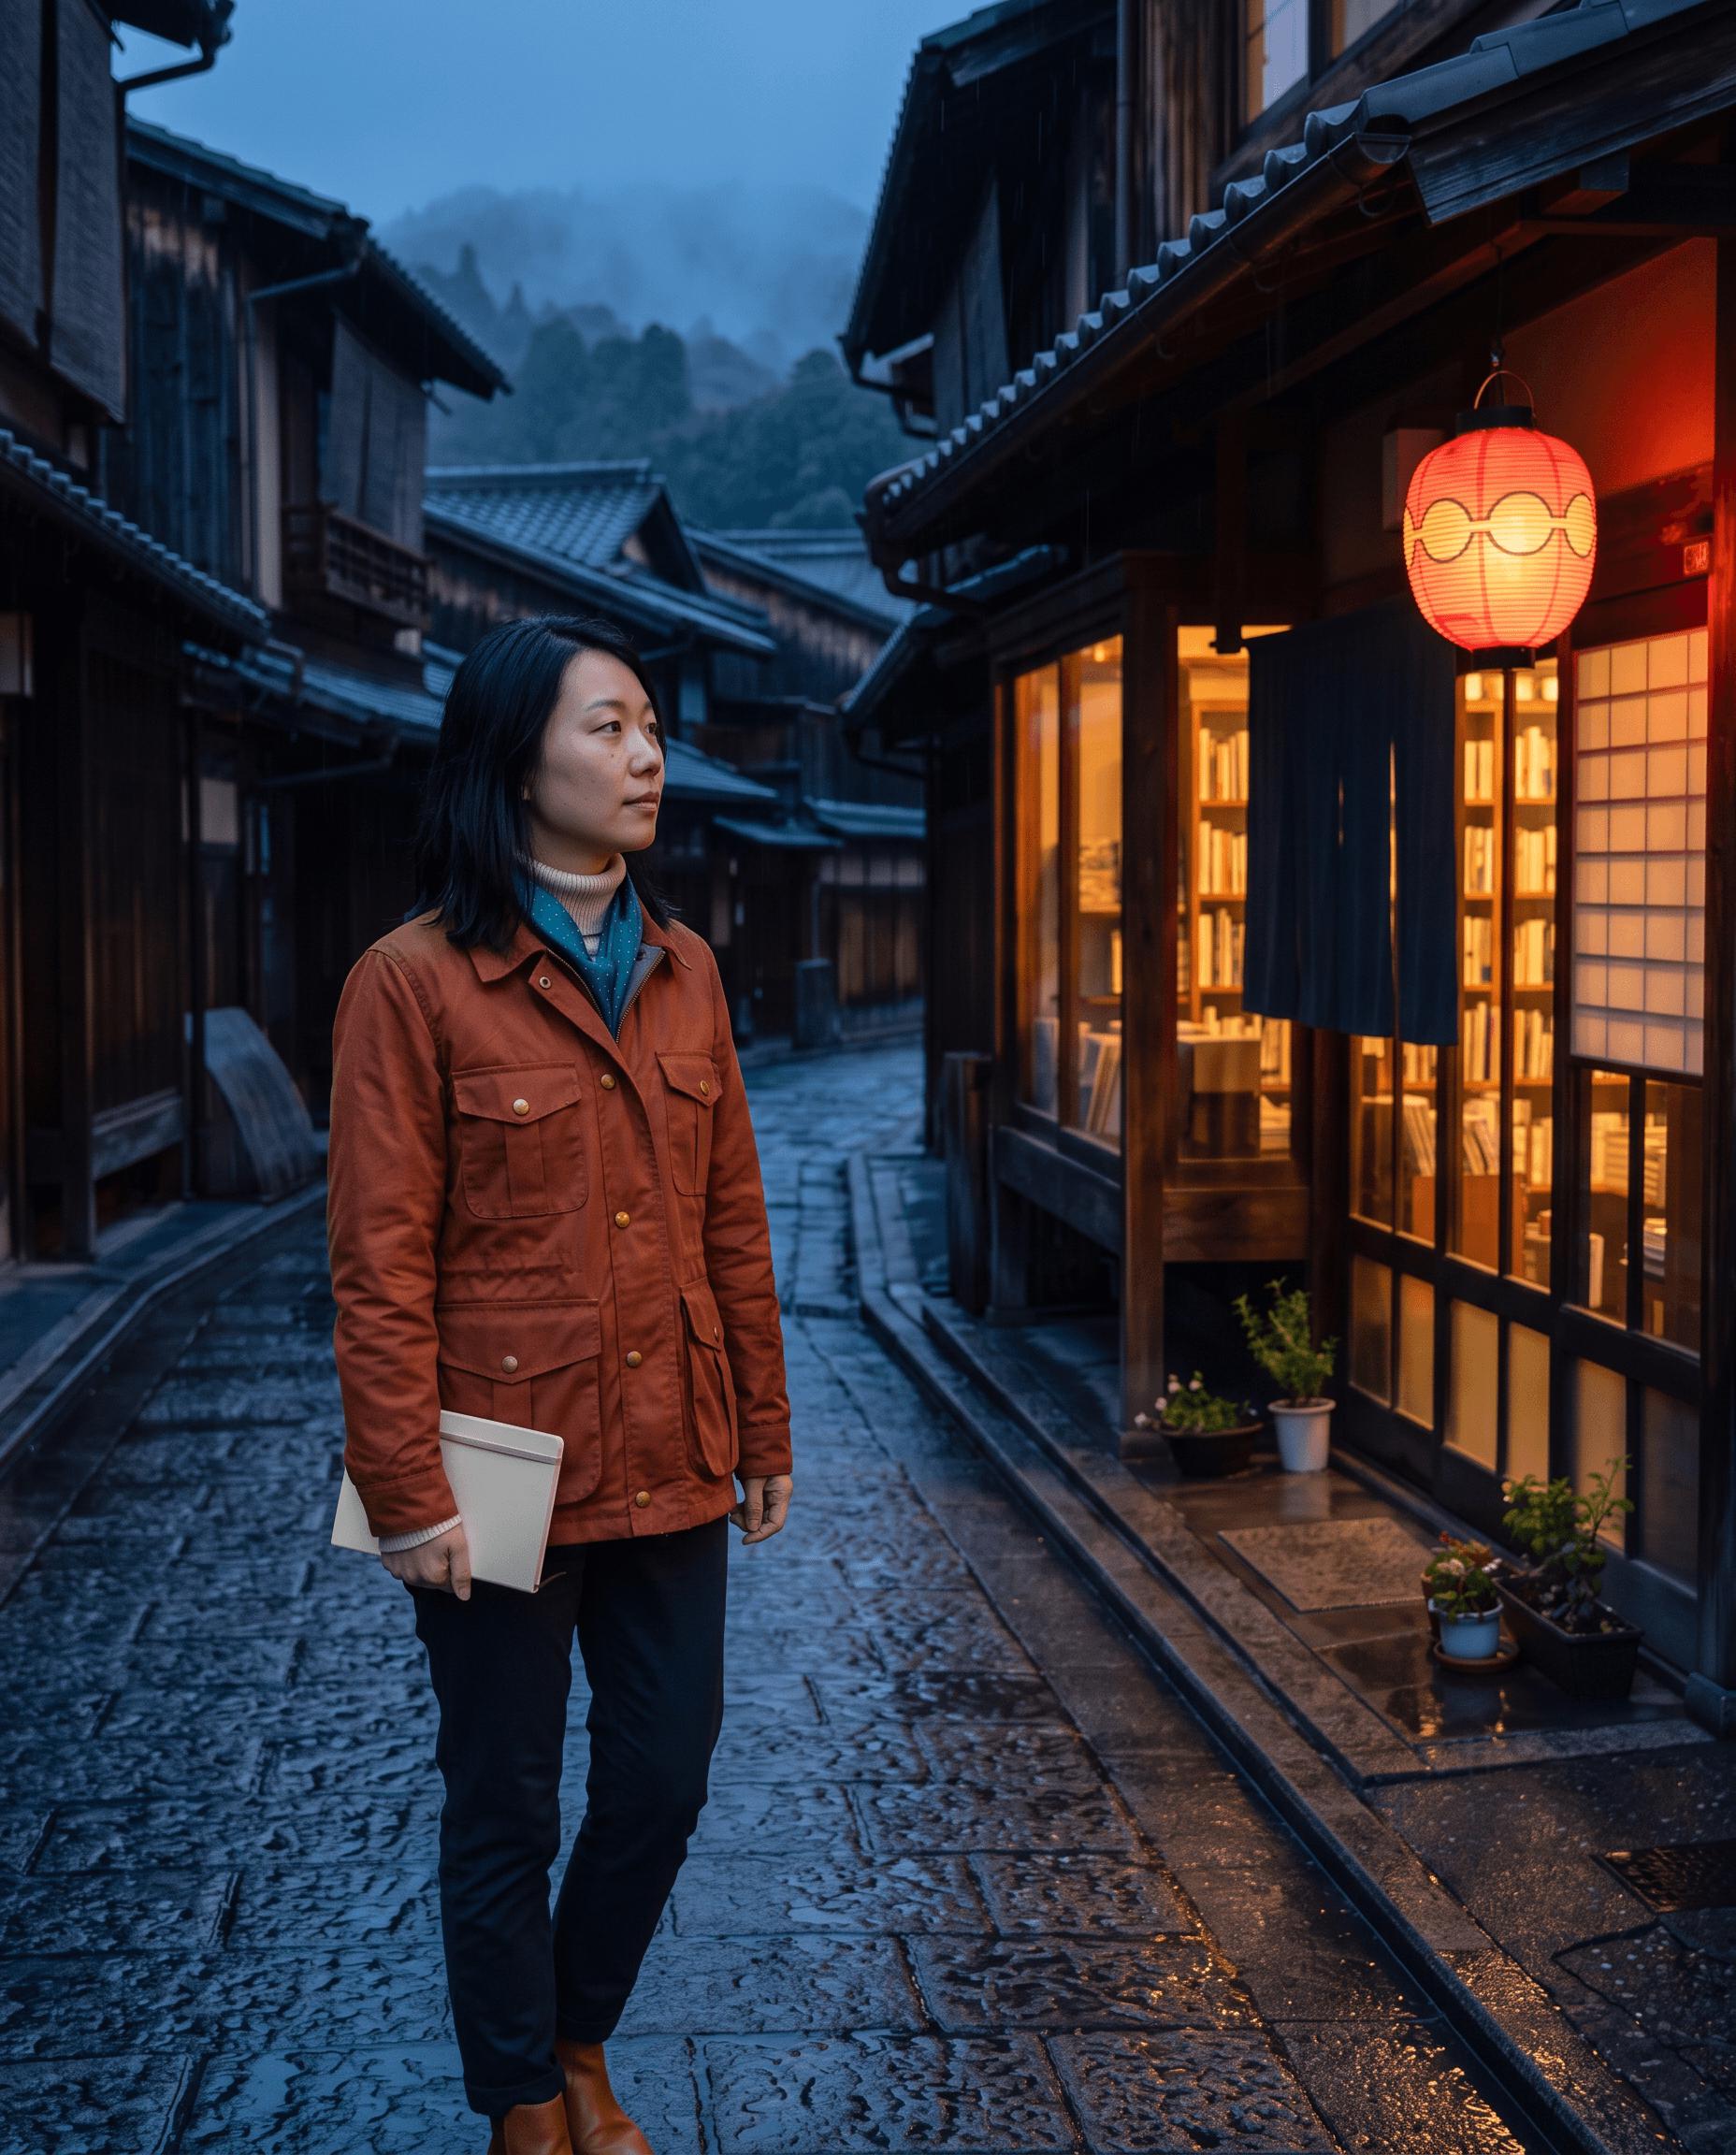
COMBINED RESULT
Nano Banana 2.1 result combining a woman, outfit, and rainy Kyoto street from three references
Observed result. The face and beauty mark remain recognizable; all five wardrobe components appear; the shop, wet lane, single lantern, and warm/cool lighting survive. The figure is framed closer to full body than the requested three-quarter length.

保留效果最强的细节,既在来源图片中可见,也在文本中被重复强调。围巾、四口袋夹克和美人痣并未仅依赖视觉推断。取景偏差提醒我们:一张精致的图片仍可能未能满足某项制作约束。

可重复使用的多参考图工作流

  1. 为每张参考图指定一项主要职责。 使用身份、服装、产品、姿势、光线或环境等标签。
  2. 尽可能移除相互竞争的信息。 干净的服装平铺图比包含另一人物和地点的复杂时尚照片更容易解读。
  3. 重申身份锁定特征。 指出一旦改变就会使输出不可接受的面部、物品或服装细节。
  4. 独立描述最终构图。 参考图提供素材;提示词仍需包含取景、主体位置、视线、镜头和光线。
  5. 针对可能的失败模式添加排除项。 防止出现额外人物、配饰、文字、重复物体或材质混合。
  6. 逐张参考图进行审查。 先比较身份,再比较服装,最后比较环境,而不是只评判整体氛围。

用于你自己图片的提示词模板

角色映射模板
图片 1 是[身份 / 产品]参考。
图片 2 是[服装 / 材质]参考。
图片 3 是[地点 / 光线]参考。

创建一张[宽高比]的[图片类型],呈现[最终场景]。 使用图片 1 中的[主体]、图片 2 中的[细节]以及图片 3 中的[环境]。

严格保留:[身份锚点]、[物体细节]、[颜色 / 图案]和[场景地标]。 构图:[取景]、[位置]、[视线 / 动作]、[镜头]。 光线:[主光]、[色彩对比]、[一天中的时间]。

不要添加[常见多余元素]。不要改变[锁定特征]。不要有文字、Logo 或水印。

常见失败模式与修复方法

  • 人物发生变化: 重复两到三个身份锚点,并从来源集合中移除其他人脸。
  • 服装不完整: 列出每一件必需服装及其标志性颜色或材质。
  • 参考图被混合: 为每张图片分配一个明确角色,并说明细节冲突时以哪个来源为准。
  • 场景过于泛化: 指明两到三个结构性地标,而不只是描述“夜晚的京都”这样的氛围。
  • 裁切发生偏移: 同时指定裁切方式和必须保留在画面内的内容;��果不符合要求,则重新生成。

最终要点

多参考图生成最适合作为一套小型艺术指导系统来使用。图片提供依据;提示词分配控制权并定义最终画面。在本次测试中,Nano Banana 2.1 令人信服地合并了身份、服装和地点,但取景仍需要人工质检。

如需了解更全面的提示词框架,请阅读 Nano Banana 2.1 提示词指南。如需了解经过测试的角色工作流,请参阅 如何创建一致的角色分镜故事板。