












将视频中的人物换成 Comatozze:Kling 4.0 教程与提示词
观看 22 秒 Comatozze 地铁 AI 换人视频,对比原片与结果,使用 Kling 4.0、人物参考照和完整提示词,将自己上传视频中的主角替换为 Comatozze。
使用 Kling 4.0 Reference,你可以尝试将自己上传视频中的主角替换为 Comatozze。上传视频,并添加一张 Comatozze 肖像作为人物外貌参考;只输入名字不能代替参考照。先看下方这段 22 秒的 Comatozze 地铁 AI 换人视频,对比原片与结果,再将完整提示词用于你自己的视频。
AI-generated character edit
这是一次 AI 生成编辑,并非科马托泽在车站的纪实影像。一个重要限制显而易见:尽管提交的提示词要求保留原始上衣和蓝色牛仔裤,输出仍改变了服装。
将肖像分配给身份,将视频分配给动作
该工作流程将替换对象与她所处的场景分开。上传的肖像用于引导面部和长发。地铁视频提供原始前景表演、手持视角、车站布局和动作序列。
| 输入 | 预期作用 |
|---|---|
@Image1:所选肖像 | 替换身份、面部特征和头发 |
@Video1:地铁片段 | 前景动作、构图、转身、站台移动和背景 |
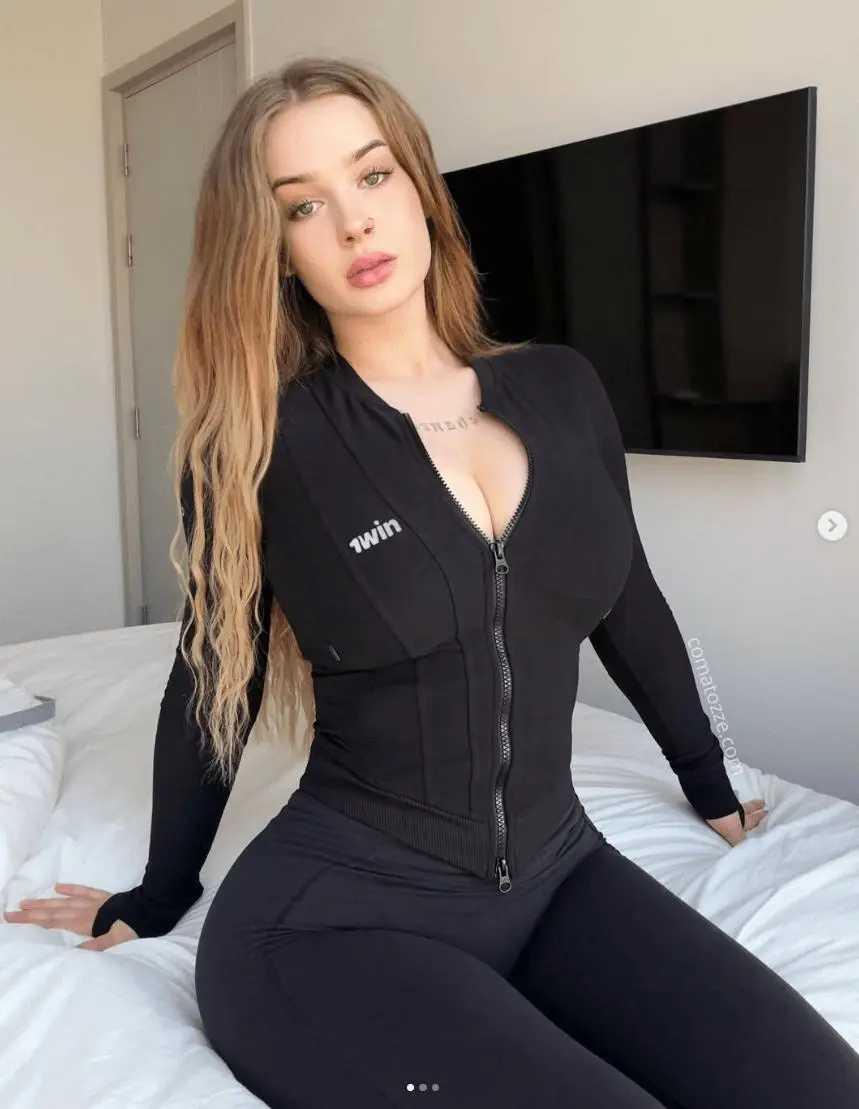
科马托泽是此提供案例所使用的名称。实际生成由附加图像引导;并不依赖模型从文本中识别名称。请使用你有权重复使用的肖像和视频,并将分享的结果标注为 AI 编辑。
在替换前识别前景表演者
源视频中包含一位主要表演者以及列车周围的路人。提示词通过可见服装识别目标:身穿黑色长袖连帽上衣和蓝色牛仔裤的人。然后它将替换范围限制为该人物。
这比“替换视频中的人”更精确。身份参考应在正面、侧面、转身和快速移动中跟随前景表演者,而源视频仍作为镜头和车站的指引。
提示词还要求保留手持车票/卡片和有线耳机。将这些小物件视为检查点,而非生成状态成功后自动得到保证的细节。
使用记录的 22 秒 Kling 4.0 设置
打开 WeShop 上的 Kling,选择 Kling 4.0 Reference,并附加两个文件。生成前,请确认 Image 1 是目标肖像,且 Video 1 是地铁片段。
| 设置 | 所选案例值 |
|---|---|
| 模型 | Kling 4.0 Reference |
| 时长 | 22 秒 |
| 分辨率 | 1080p |
| 宽高比 | 9:16 |
| 数量 | 1 |
| 参考输入 | 一张图像和一段视频 |
WeShop Kling 4.0 模型页面介绍了其 Reference 工作流程。请在控件中选择时长,同时在提示词中描述预期序列。生成前请查看任务中的当前积分报价。
此处展示的结果来自该任务的第二次执行,使用了上方展示的肖像。第一次执行使用了不同的图像。如果你正在优化任务,请检查你保留的特定结果所附的参考资料,而不要假设每次执行都具有相同输入。
复用原始地铁角色替换提示词
以下是准确提交的提示词。它明确区分了身份、源服装、动作和镜头指令。这使得请求与输出之间的差异易于评估。
编辑 @Video1,仅将主要前景表演者——身穿黑色长袖连帽上衣和蓝色牛仔裤的人——替换为 @Image1 中的成年女性。仅将 @Image1 用于身份和头发:在正面视角、侧面视角、转头、特写和运动模糊中,始终匹配她的面部结构、眼睛、眉毛、鼻子、嘴唇、肤色以及浅棕色/深金色头发。整个片段中保持同一位可识别的参考女性,包括检票闸机镜头和后续步行/奔跑镜头。移除原表演者的面部特征和棕色短发。不要复制参考照片的户外场景、姿势、水印或领口。保留主要表演者的源服装:不透明的黑色长袖连帽衫/上衣、蓝色牛仔裤、腰带和鞋子,并以自然合身、符合真实比例的方式适配参考女性。她从头到尾保持完整着装,上衣稳妥遮盖躯干,牛仔裤遮盖臀部;不得脱衣或强调身体。保留可见的源小配件,包括有线耳机和她手中的车票/卡片。不要引入参考照片中的新服装、包、太阳镜或首饰。
在全部 22 秒内遵循准确的源表演、步伐时序和镜头运动:面向镜头做手势、转向检票闸机、使用车票/卡片并与闸机互动、走回镜头前、嘴唇动作和表情、俏皮的步伐,然后以相同的手臂摆动、转身和身体姿势沿站台快速移动,最后在镜头平移离开时退出画面。在每个镜头中保持相同位置和表观比例。保留原始剪辑、手持镜头路径、运动模糊、光线变化、地铁站建筑、站台、标志、栏杆、列车、海报、车门和背景透视。保持所有路人不变;仅替换主要表演者。修正解剖结构、手部和物体接触;头发和织物自然运动;每个镜头中的身份保持一致。不要有新场景、重新设计的镜头、字幕、水印、新人物或特效。保留原始音轨和准确动作时序。
复用时有两个细节需要解读。排除照片“户外场景”的指令是沿用的措辞;此处展示的所选肖像是在室内拍摄。请更新背景排除项以适配你自己的照片。要求保留原始音轨和准确时序的句子同样只是指令,而非经过验证的音频结果:请分别预览音频和唇部动作。
对比地铁序列与服装偏移
Metro action reference
Generated character edit
所选输出遵循了源视频的大致序列:朝镜头靠近、在列车旁转身、在海报墙边做手势、沿站台快速移动并退出视野。替换人物在可识别的车站场景中具有参考图像引导的长发和面部外观。
服装未能按要求保留。 源表演者穿着蓝色牛仔裤和黑色连帽上衣。生成的表演者穿着黑色长裤和受肖像影响的修身黑色前拉链上衣。领口和整体轮廓也与源视频不同。此案例展示了角色重新选定;并未展示可可靠地将身份与参考服装分离。
| 检查点 | 检查内容 |
|---|---|
| 开场靠近 | 主体接近时的替换面部、头发和位置 |
| 转向列车 | 侧面和背面视角的连续性,尤其是头发遮住��部的情况 |
| 手持物品 | 卡片/手机形状、耳机线、手指和物体接触 |
| 墙边手势 | 头部和肩膀改变方向时的面部连续性 |
| 站台快速移动 | 主体位置、镜头跟踪和运动模糊 |
| 背景 | 应保持可识别的路人、列车、标志和海报形状 |
请查看整个片段,而非仅接受封面帧。场景和动作的可见匹配并不代表面部保真度准确、标志未被改变、手部无瑕疵或背景逐帧得到保留。
优化结果实际发生变化的部分
如果改变了错误的人,请通过服装、位置和动作识别目标。如果图像中的房间替代了车站,请说明图像提供人物,而视频提供环境和镜头。确认视频确实已附加;书面的车站描述并不是同样的参考输入。
如果保留源服装至关重要,请不要因这一要求而批准此特定结果。你可以尝试使用包含较少服装内容的身份裁剪图,并保留简短、明确的服装保留指令,但本案例未测试此调整。再次将下一个结果与源视频进行比较。
尝试肖像引导的科马托泽地铁编辑
可复用的设置是肖像加原始地铁片段,并明确命名前景目标和使用记录的 22 秒设置。将其用于可审查并接受服装诠释的角色重新选定。检查期间请保持源视频可见,以便分别判断身份、衣物、物品和背景的变化。
你可以使用右侧的工具直接尝试。