





AI 換裝工具:結合服裝、模特與背景參考圖
了解如何透過分別指定服裝、成人模特兒與背景參考圖,再搭配清楚的三圖提示詞,建立可控的 AI 時尚圖片。
AI 圖片生成器:使用 GPT Image 2.5 結合服裝、模特兒與背景參考圖的 AI 換裝工具
一張圖片決定模特兒穿什麼。第二張圖片決定由誰穿著。第三張圖片則決定最終照片的拍攝場景。
在生成結果中,短髮模特兒穿著服裝參考圖中的炭灰色大衣、黑色上衣、寬鬆長褲與銀色運動鞋,並站在場景圖片中的淺色牆面與石階前。
與其要求 AI「換衣服」並任由它重新設計整張照片,這個工作流程會為每張參考圖片賦予明確的責任。
本教學使用 WeShop AI GPT Image 作為 AI 換裝工具,將服裝圖片、成人模特兒照片與背景參考圖結合為一張時尚視覺圖。
僅限使用您自己的圖片,或您已獲得使用許可的成人模特兒照片。
此 AI 換裝工具工作流程需要準備的內容
請準備三張參考圖片:
- 顯示完整目標穿搭的全身圖片
- 清晰的成人模特兒照片
- 顯示所需背景與構圖的場景圖片
每張參考圖都會控制生成圖片的不同部分。
| 參考圖 | 控制內容 | 不應控制的內容 |
|---|---|---|
| 圖 1 | 服裝、鞋類、層次搭配與輪廓 | 模特兒身分或最終背景 |
| 圖 2 | 臉部、髮型、膚色與身分 | 服裝或場景 |
| 圖 3 | 背景、構圖、光線與主體位置 | 最終模特兒身分或穿搭 |
這種分離方式非常重要,因為背景參考圖中可能包含另一位人物、穿搭、手提包、太陽眼鏡或配件。
如果提示詞未定義每張圖片的用途,這些非預期細節可能會出現在生成結果中。
步驟 1:上傳服裝參考圖
圖 1 是服裝參考圖。
它會確立最終圖片中應出現的完整穿搭:
- 炭灰色全長大衣
- 黑色圓領上衣
- 寬鬆的深灰色打褶長褲
- 銀色運動鞋
- 寬鬆、低飽和度的輪廓
- 大衣、上衣與長褲之間的層次搭配
| 服裝參考圖 — 圖 1 |
|---|
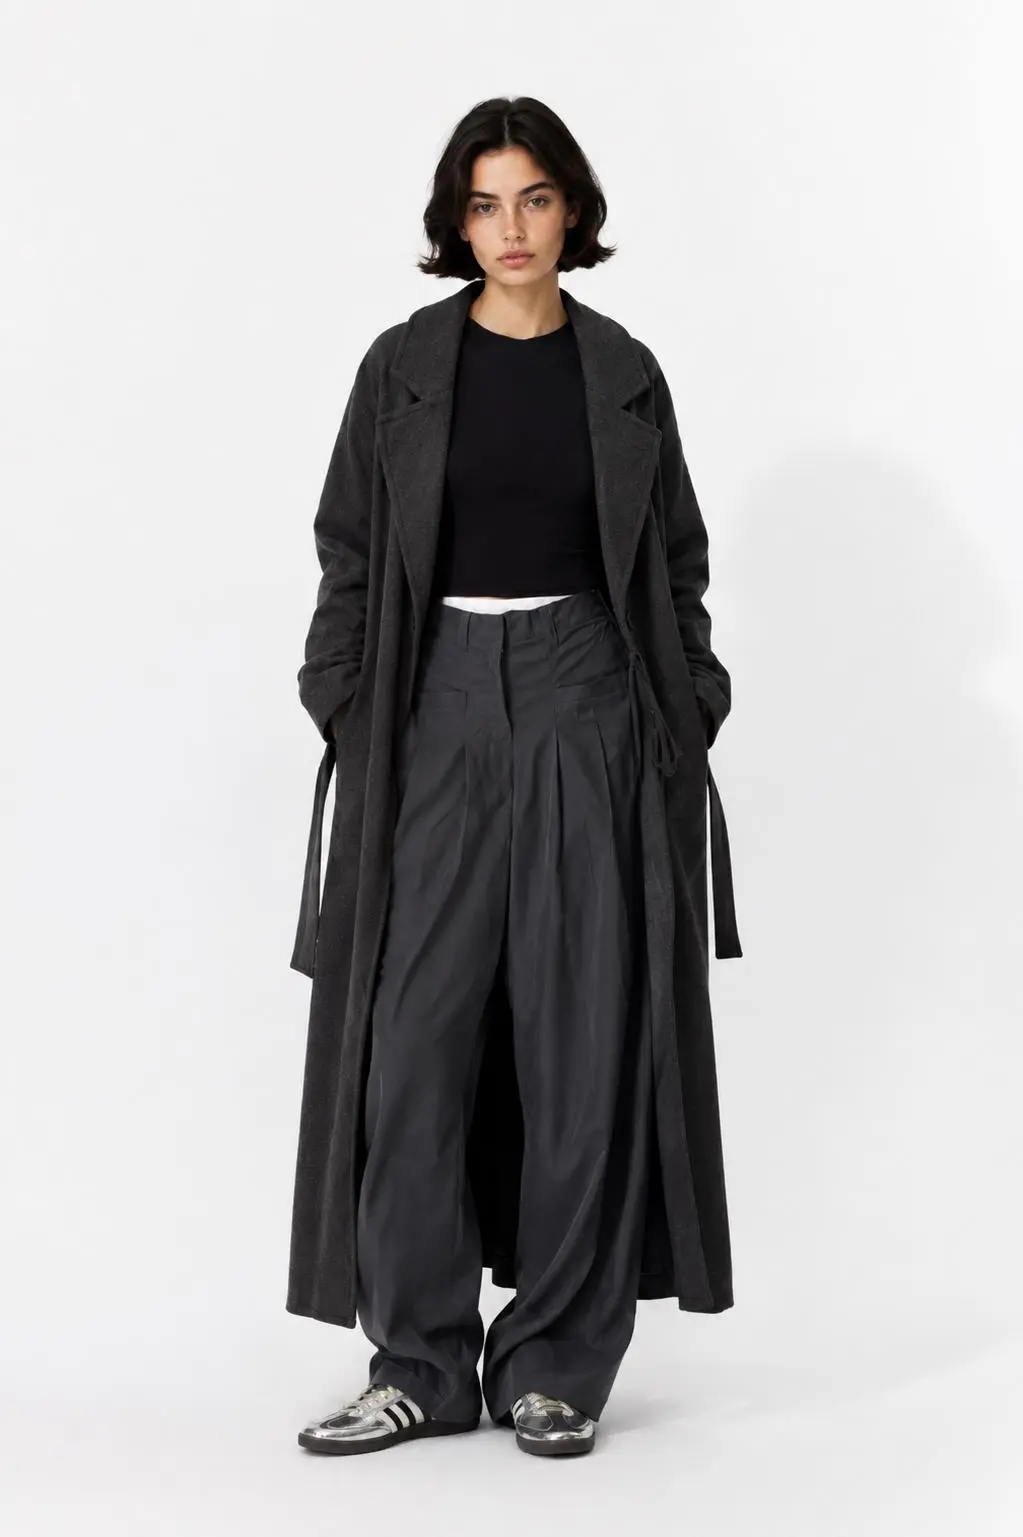 |
| 圖 1 控制穿搭、鞋類、服裝比例與整體造型。 |
此圖片中的人物不是身分參考。最終模特兒的臉部與髮型應來自圖 2。
這項區分可避免 AI 換裝工具僅僅複製原始時尚照片。
步驟 2:上傳成人模特兒參考圖
圖 2 是身分參考圖。
它提供模特兒的可見特徵:
- 短黑髮造型
- 臉部輪廓
- 眼睛、鼻子與嘴唇
- 膚色
- 自然妝容
- 簡約、沉穩的時尚美學
| 成人模特兒參考圖 — 圖 2 |
|---|
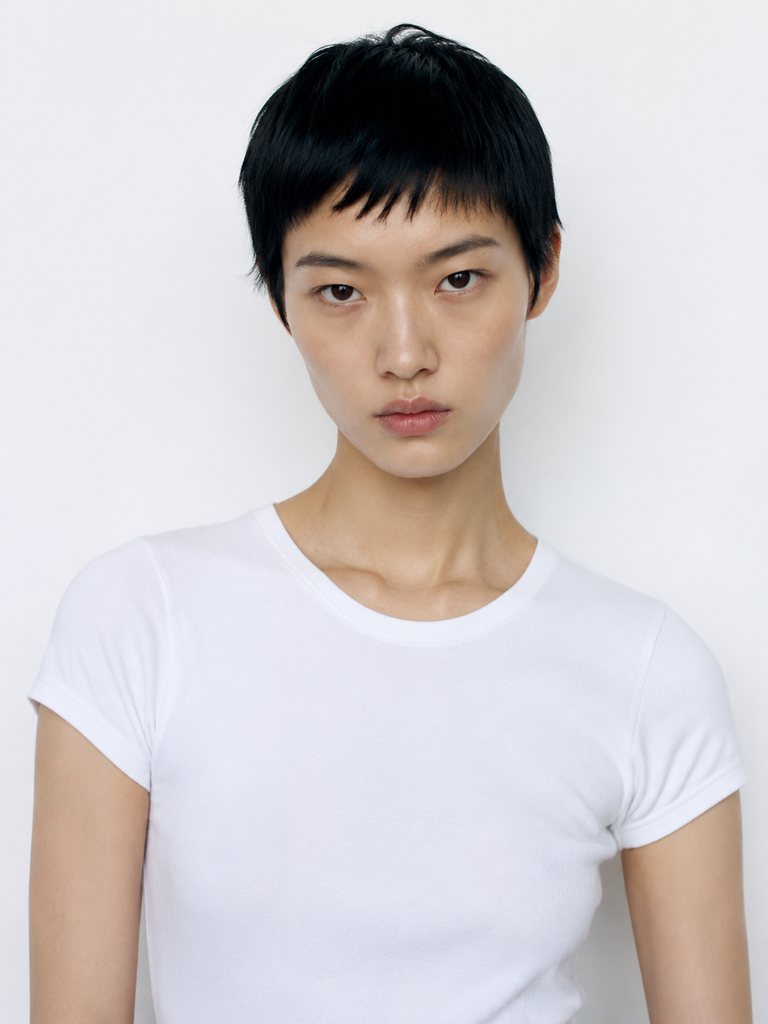 |
| 圖 2 提供成人模特兒的臉部身分、短髮造型、膚色與整體外觀。 |
由於參考圖只顯示模特兒的上半身,AI 必須推斷缺失的身體、全身姿勢與服裝合身程度。
因此,生成結果應視為創意 AI 合成圖,而非真實人物身體或實際穿著的精確呈現。
步驟 3:上傳背景參考圖
圖 3 控制環境與基本構圖。
可用的視覺資訊包括:
- 淺色外牆
- 深色木門口
- 灰色石階
- 全身直式畫面構圖
- 主體位於牆邊的位置
- 柔和的戶外日光
- 克制的街頭時尚氛圍
| 背景參考圖 — 圖 3 |
|---|
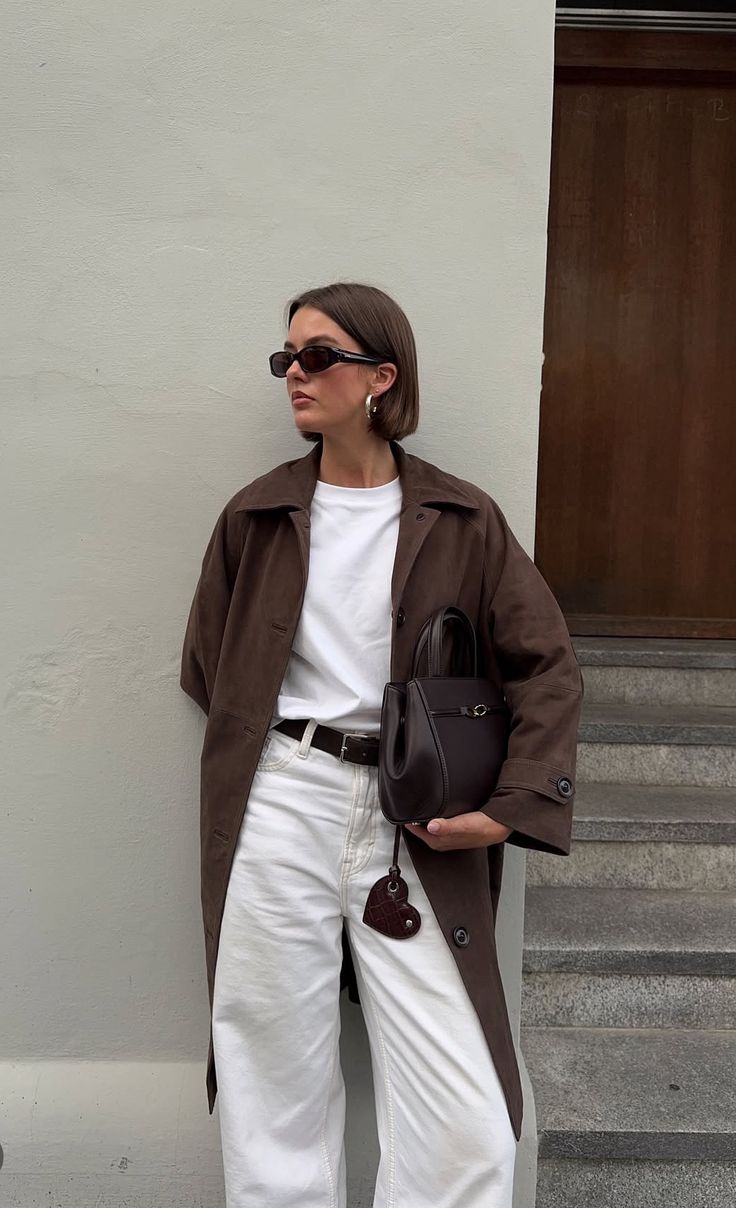 |
| 圖 3 提供建築背景、鏡頭構圖、自然光線與主體位置。 |
圖 3 中已出現的人物不應成為最終模特兒。
除非刻意要求,否則應忽略她的臉部、穿搭、太陽眼鏡、耳環、手提包及其他個人細節。
步驟 4:輸入三圖提示詞
提示詞最簡短的版本,是描述三張參考圖之間的關係。
簡易提示詞
圖 2 中的模特兒穿著圖 1 的服裝,並站在圖 3 的背景前。
這傳達了基本目標,但仍將多項決定留給模型處理:
- 哪些臉部細節必須來自圖 2?
- 圖 1 中哪些服裝細節必須保留?
- 圖 3 是否應只控制環境?
- 是否應複製圖 3 中的配件?
- 構圖的哪些部分可以變更?
更有結構的提示詞可為 AI 換裝工具提供更清楚的界線。
可直接複製的提示詞
將圖 1 作為服裝參考圖、圖 2 作為成人模特兒身分參考圖,以及圖 3 作為背景與構圖參考圖。

建立一張全身直式街頭風格照片,畫面中的成人模特兒來自圖 2,穿著圖 1 的完整服裝,並站在圖 3 的建築場景中。

保留圖 2 中模特兒的短黑髮、可辨識的臉部特徵、膚色與自然身材比例。

保留圖 1 中的炭灰色長大衣、黑色上衣、寬鬆深灰色打褶長褲、銀色運動鞋、服裝層次與寬鬆輪廓。

保留圖 3 中的淺色外牆、深色木門口、石階、自然日光、鏡頭視角與主體位置。

圖 3 僅用於環境與構圖。請勿複製圖 3 中原本的人物、服裝、太陽眼鏡、耳環、手提包或其他個人配件。

保持結果為擬真風格,具有真實的布料皺褶、準確的手部與腳部、自然的接觸陰影,以及連貫的身體比例。

請勿加入標誌、文字、水印、額外服裝、無關配件或新的設計細節。
此版本為每張圖片指定一個清楚的角色:
- 圖 1 控制服裝
- 圖 2 控制模特兒
- 圖 3 控制背景與構圖
它也可防止場景參考圖中的太陽眼鏡、珠寶、手提包與原始服裝被非預期複製。
步驟 5:生成 AI 換裝工具圖片
開啟 WeShop AI GPT Image,並依照提示詞所使用的相同順序加入參考圖:
- 將圖 1 上傳為服裝參考圖。
- 將圖 2 上傳為成人模特兒參考圖。
- 將圖 3 上傳為背景參考圖。
- 貼上三圖提示詞。
- 生成全身直式結果。
功能可用性可能有所不同,請依照工具頁面顯示的目前狀態與控制項操作。
您可直接使用右側工具試用。
若第一個結果錯誤繼承了圖 3 中的太陽眼鏡、珠寶、手提包或其他造型元素,請以針對性的修正繼續處理,而不是重寫整個場景。
保持目前的模特兒、服裝、姿勢、背景、光線與構圖不變。

移除從圖 3 複製的太陽眼鏡、耳環、手提包及任何其他配件。

模特兒的臉部與髮型必須繼續遵循圖 2,而完整服裝必須繼續遵循圖 1。
這項後續指令可指出不需要的元素,同時保護已經正確的部分。
步驟 6:檢視生成結果
最終圖片結合了三張參考圖的資訊。
| AI 生成結果 — 圖 4 |
|---|
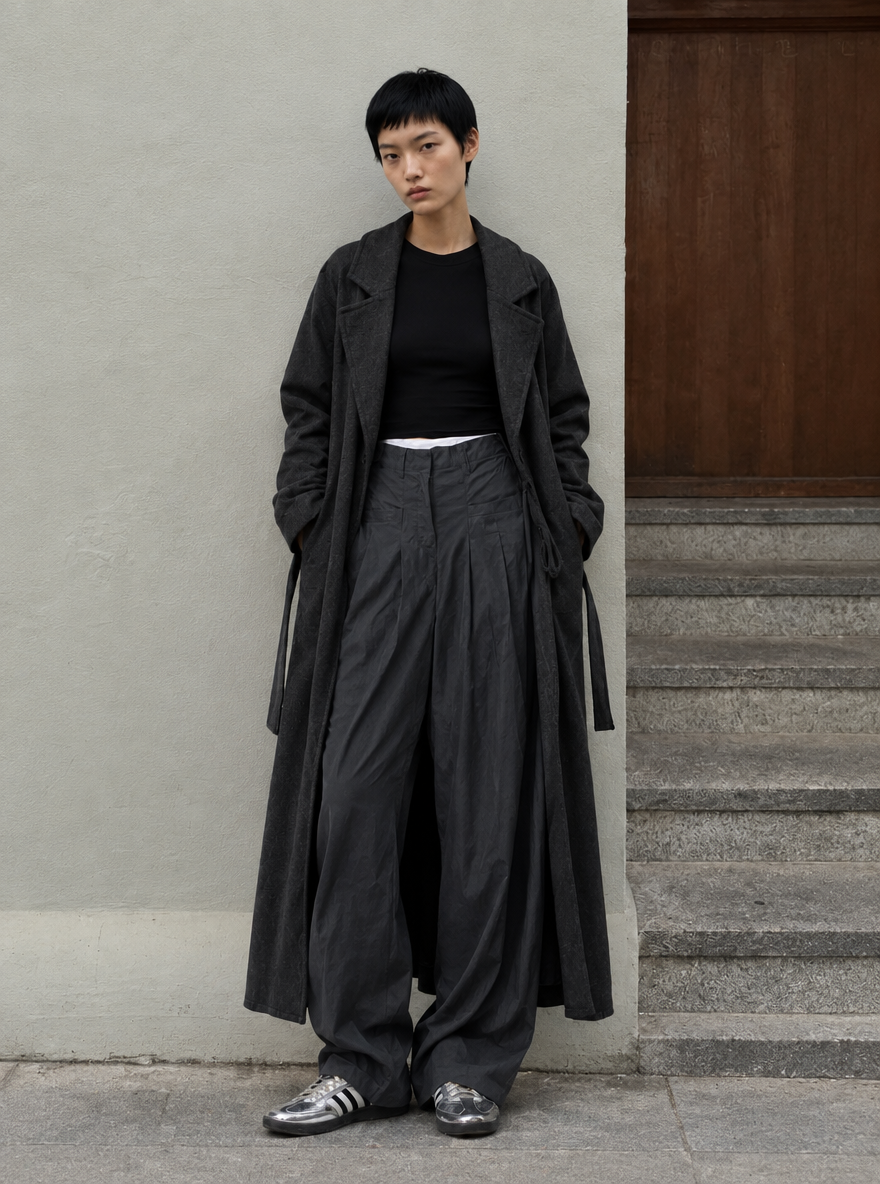 |
| 生成結果結合了圖 1 的穿搭、圖 2 的成人模特兒身分,以及圖 3 的建築場景。 |
完成的圖片保留了數個可辨識元素:
- 短黑髮與主要臉部外觀來自圖 2。
- 炭灰色大衣、黑色上衣、寬鬆長褲與銀色運動鞋來自圖 1。
- 淺色牆面、木門口、石階與主體位置來自圖 3。
- 最終構圖維持為全身直式街頭風格照片。
結果也顯示多參考圖圖片生成中的一個常見問題:場景參考圖的影響可能不只限於背景。
即使目標模特兒與服裝來自不同圖片,太陽眼鏡等配件仍可能從圖 3 一併帶入。若配件不是目標造型的一部分,請在主要提示詞中明確排除,或透過第二次針對性編輯將其移除。
為什麼「換衣服」不夠具體
像「換衣服」這樣的基本指令,會迫使圖片模型做出過多決定。
它必須猜測:
- 要使用哪一套穿搭
- 要保留哪一位人物
- 人物應站在哪裡
- 最終環境應呈現何種樣貌
- 配件是否應保留
- 哪些視覺細節可以重新設計
三參考圖工作流程可將這些決定分開處理。
服裝圖片定義時尚產品。模特兒圖片定義人物。背景圖片定義場景與構圖。提示詞再說明這些參考圖應如何共同運作。
此方法可支援:
- 時尚產品圖片
- Shopify 服裝視覺圖
- 形象型錄概念
- 社群媒體穿搭內容
- 模特兒與場景實驗
- 時尚前期製作概念
- 電商行銷活動草稿
若用於銷售圖片,請手動將生成服裝與實際產品進行比對。在將圖片作為產品呈現之前,請檢查其長度、顏色、材質、結構、扣件與配件。
將三張參考圖轉化為一張可控的時尚圖片
有效的 AI 換裝工具提示詞應回答三個問題:誰在穿這套服裝、穿著什麼,以及照片在哪裡拍攝?
圖 1、圖 2 與圖 3 分別回答這些問題。GPT Image 2.5 隨後將它們結合為單一時尚視覺圖,而提示詞則定義哪些細節應保持獨立。
這種責任分工能將三張彼此無關的參考圖,轉化為更可控、可重複使用的時尚內容工作流程。