












Kling 4.0 喜剧短片:一镜生成 vs 分镜剪辑
对比四支使用 Kling 4.0 和 Seedream 5.5 制作的 30 秒 AI 喜剧视频:一镜生成与分镜剪辑,以及竖屏和横屏版本。
一名学生把作业不见了归咎于狗。一只鹅叼着笔记本走进来。“它连狗也吃了,”学生解释道。老师审视证据后,让鹅来上课,自己坐下来记笔记。
我们使用 Seedream 5.5 图像作为参考,通过 Kling 4.0 Reference 制作了这支 30 秒 AI 喜剧短片。其中一种工作流通过单次请求生成完整视频;另一种则生成六段独立片段,再通过剪辑组装。两种工作流各有横屏和竖屏版本,共有四支成片可供对比。
观看同一课堂喜剧的两种制作方式
One-pass · Landscape
Shot-by-shot · Landscape
One-pass · Portrait
Shot-by-shot · Portrait
四支成片均为 30 秒,包含英文对白及中英双语字幕。原始横屏导出分辨率为 1920 × 1080;竖屏导出分辨率为 1080 × 1920,均为 24 fps。文章中的播放器分别使用 Media Library 的 854 × 480 和 480 × 854 播放副本,保留了 30 秒时长、帧率和音频。人物是俄罗斯成人学校课堂中的虚构成年人。画面和原始对白由 AI 生成;字幕和后期制作在之后添加。
| 制作选择 | 一镜生成 | 分镜生成与剪辑 |
|---|---|---|
| 每种格式的视频请求数 | 一次 30 秒请求 | 六次 6 秒请求 |
| 谁决定内部切点? | 模型解读完整时间线 | 剪辑师选择源片段范围和切点 |
| 图像准备 | 课堂主图、三张场景照片、三张走位图 | 共享素材,另加一张交接粉笔的照片和走位图 |
| 本案例使用的后期处理 | 字幕、响度调整;竖屏版移除重复台词 | 组接、基于对白的修剪、选定画面的重新构图、响度调整和字幕 |
| 主要取舍 | 对每个节拍发生的准确时间控制较少 | 需要对分别生成的片段进行更多连续性检查 |
一镜生成并不代表一个连续镜头。 生成的视频可以包含切换。同样,分镜剪辑是对生成的视频片段进行剪切,并可对剪辑进行逐帧控制;我们并非将每一帧都作为单独图像生成。
在请求运动前先构建参考素材
故事需要三个易于辨认的主体:Elena,戴红色阅读眼镜、穿炭灰色开衫的老师;Misha,一名穿奶油色毛衣��成年学生;以及一只普通的白鹅。一张课堂主图确定了他们的外观,同时包含绿板、木质课桌和窗边光线。
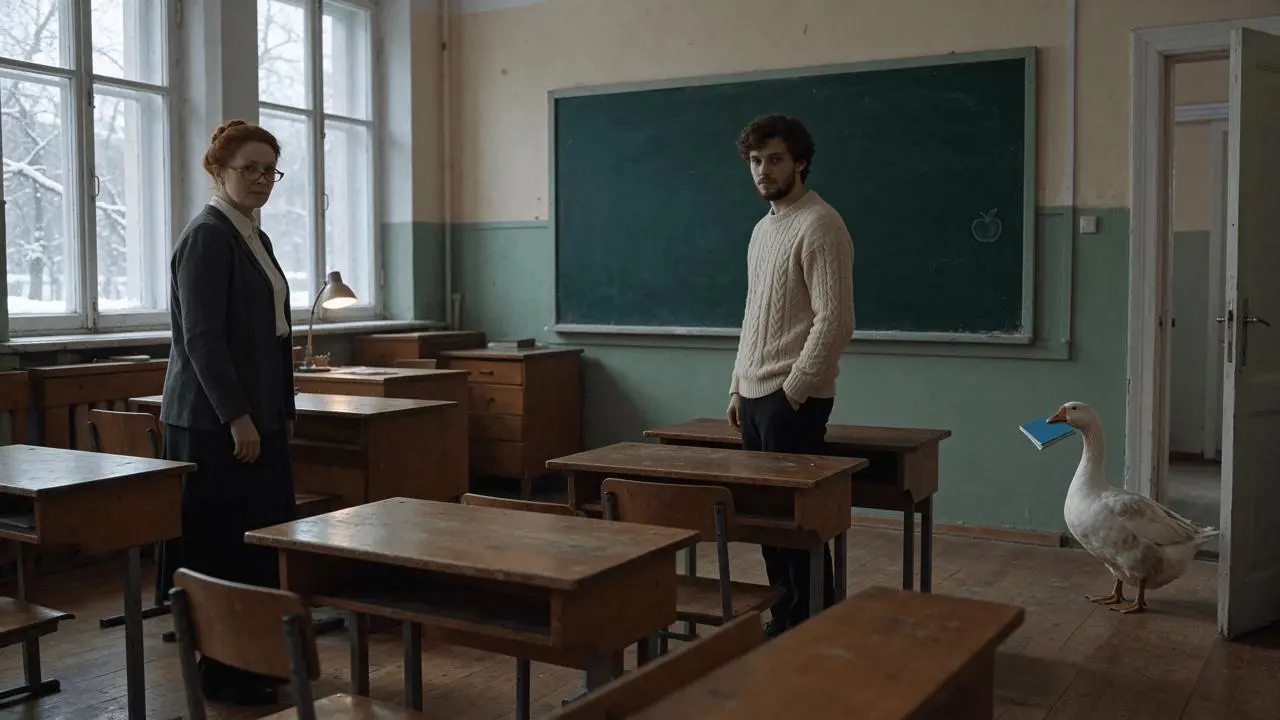
我们通过 WeShop CLI 中的 Seedream 5.5 准备了这张主图,随后制作关键场景照片和走位图。两种视频工作流都复用了这一视觉基础。项目使用共享的课堂图像作为身份参考;并未先创建独立的人物转面图或单独的面部设定图。
针对每种宽高比,准备三组摄影场景:检查作业、鹅带着蓝色笔记本到来,以及鹅授课而两名人类都在记笔记。将它们视为同一故事中的独立时刻。
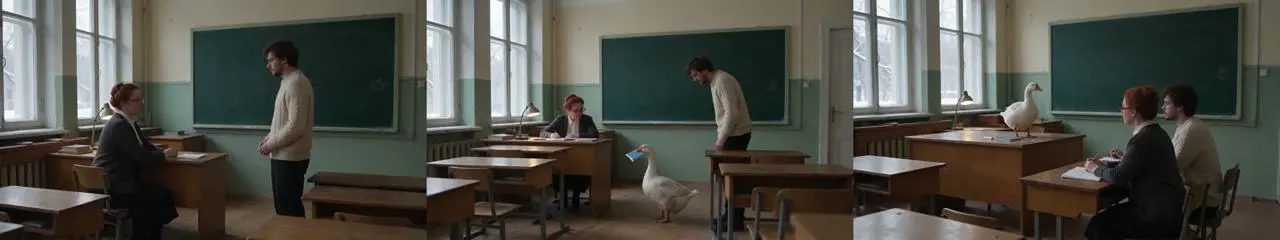
然后为每组场景制作匹配的简化走位图。保留镜头视角、裁切、相对大小、位置、朝向和遮挡关系。使用不同的细彩色轮廓线标识主体,同时将外观和光线交由照片决定。
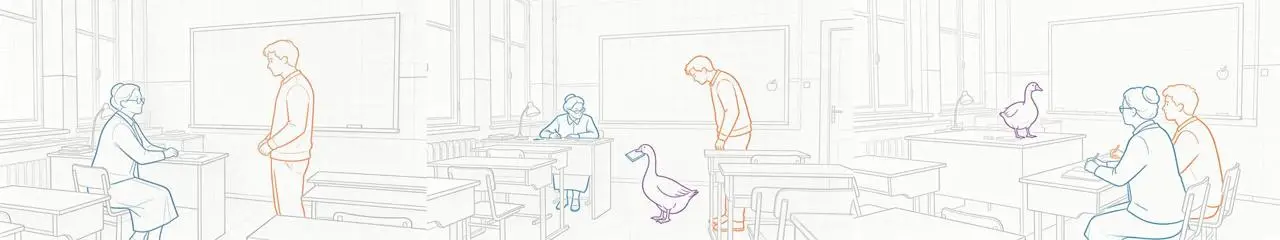
在我们的提示词中,蓝色标识 Elena,橙色标识 Misha,紫色标识鹅。这些颜色仅用于图示中标识主体。实际服装来自摄影参考图。照片在走位图之前附上,并在提示词中明确指定每张图像的角色。这些是在本案例中测试过的制作选择,并不保证实现精确定位。
路线 1:一次生成完整的 30 秒影片
打开 WeShop 上的 Kling,选择 Kling 4.0 Reference。要匹配本案例,请使用 30s、1080p、数量 1;横屏选择 16:9,竖屏选择 9:16。这些是我们在生成请求中记录的设置;当前 CLI 操作详情请参阅 WeShop API 参考。
按顺序附上七张图像:主图、三张场景照片,以及三张对应走位图。使用为所选格式准备的图像。两种格式分别独立生成,各自拥有对应的场景构图和走位图。
在一条提示词中写下完整故事。先分配参考图的角色,再给出动作顺序、精确对白、表演任务和声音要求。以下紧凑时间线展示的是请求的结构,而非对成片中每个切点的实测记录:
| 请求时间段 | 故事节拍 |
|---|---|
| 0–9s | 老师询问作业;学生责怪狗;一个停顿将注意力转移 |
| 9–18s | 鹅带着笔记本到来;老师认出它;学生加码自己的借口 |
| 18–25s | 老师评估这场打断,并移交授课权 |
| 25–30s | 鹅开始授课;两名人类记笔记;学生试图提问 |
可复用案例包含完整的原始提示词及其七项参考输入。以下是表演指令中的节选:
“你的作业在哪里?”——要求他承担责任,并观察他是否愿意回答。“那是一只鹅。”——给他一个纠正自己说法的机会。“很好。你来教。”——把责任交给鹅,并观察它是否接受。
老师试图让课堂继续进行。学生试图让自己的借口在新证据面前成立。鹅寻求关注,并占据授课位置。为每个主体分配任务,能让荒诞情境清晰易懂,而不必要求演员刻意强调笑点。
添加字幕前先检查结果
检查说出的台词、笔记本的可见性、课堂中的位置以及最终角色反转。检查画面中是否出现彩色轮廓或图示风格。抽样输出保留了摄影式画面,两种一镜生成版本也都达到了鹅授课的结尾,但请求的时间安排和动作并未被完全准确地执行。
竖屏原片重复了“很好。你来教。”这句台词。在后期处理中,21.65–24.65s 的第二次出现被替换为同一视频 6.4–9.4s 的室内环境声。画面保持不变。两种格式都添加了与生成语音对齐的字幕,并进行了响度处理。上方播放器展示的是这些完成后期的版本,而非未经处理的原始输出。
路线 2:生成六个镜头并控制最终剪辑
对于第二种工作流,我们增加了一张老师在课桌旁移交授课权的专用参考照片和走位图。这样让这一过渡拥有��立的视觉设定,而不是将整个交接过程交由完整影片提示词处理。
每个镜头均使用 Kling 4.0 Reference、6s、1080p、数量 1。横屏和竖屏素材集独立生成。每次请求都包含主图、相关场景照片及其走位图,并完整重复必要的身份、地点、对白和声音指令。
| 镜头 | 内容贡献 | 最终保留时长 |
|---|---|---|
| 1 | 作业提问和第一个借口 | 6s |
| 2 | 鹅叼着笔记本:简短的证据插镜 | 1s |
| 3 | “那是一只鹅。”/“它连狗也吃了。” | 6s |
| 4 | 老师将课程交给鹅 | 6s |
| 5 | 鹅授课;两名人类记笔记 | 5s |
| 6 | 学生举手,得到一声鹅叫回应后继续书写 | 6s |
最初的计划是从每段 6 秒源素材中保留 5 秒,在两端各留半秒用于修剪。实际对白无法适配这些预定窗口。我们将剪辑改为 6 + 1 + 6 + 6 + 5 + 6 = 30 秒,以保留完整台词。
笔记本也暴露了一个连续性问题:在鹅到来素材的后半段,它不再符合下一个镜头所需的状态。我们将第一秒保留为插镜。这样既让笔记本的到来清晰可读,又避开了片段尾部的不一致内容。这是剪辑层面的权宜处理,而非对原始生成动作的修复。
最终剪辑对第三和第六个镜头应用了固定裁切以增加构图变化,统一了响度并添加双语字幕。分别生成的对白被保留;在提示词中重复声音描述,不应被视为不同片段之间声音完全一致的证明。
将竖屏和横屏作为独立场景进行构图
在横屏中,教室为老师、学生和鹅提供了更多的水平分隔空间。竖屏需要一种仍能呈现三者关系、笔记本和课桌的构图。这就是本项目准备独立的 9:16 参考场景和走位图,再单独生成竖屏素材的原因。
观看两种格式中的笔记本入场和最后举手的节拍。相比对比一帧好看的画面,它们更能反映调度和喜剧节奏。完成后的竖屏视频并不只是横屏输出的居中裁切,尽管部分镜头在剪辑时接受了额外的重新构图。
围绕必须保留的节拍选择工作流
当你想测试完整笑点是否成立,并能接受模型解读内部切点时,使用一镜生成路线。你仍需检查语音、道具和结尾,再对结果进行后期处理。
当交接、反应停顿或最终提问需要拥有独立且保留的屏幕时间时,选择分镜路线。它也让你能够修改一个源片段而保留其他片段,但代价是需要检查不同生成片段之间的连续性和声音。
这四支视频记录的是一个制作案例,而不是成功率基准。先从完整的 30 秒课堂案例开始,检查你的结果实际保留了什么;当某个特定节拍需要更多控制时,再将场景拆分为多个镜头。
你可以直接使用右侧工具进行尝试。