





Qwen-Image-2.1: прозрачность, редактирование по 10 референсам и вывод 2K
Узнайте о единой модели изображений Qwen-Image-2.1 с 7 млрд параметров: нативный вывод RGBA, до 10 референсов, редактирование по маске и нативная генерация в 2K.
1. Qwen-Image-2.1 использует модель с 7 млрд параметров для генерации и редактирования
Qwen-Image-2.1 объединяет генерацию текста в изображение и редактирование изображений в одном конвейере модели. Её компонент визуальной генерации использует 32-слойную архитектуру Single-Stream DiT с 7 млрд параметров. Qwen3-VL 8B кодирует текст и условные изображения, а внимание смешанной гранулярности и повторное использование Prefix KV Cache сокращают повторные вычисления.
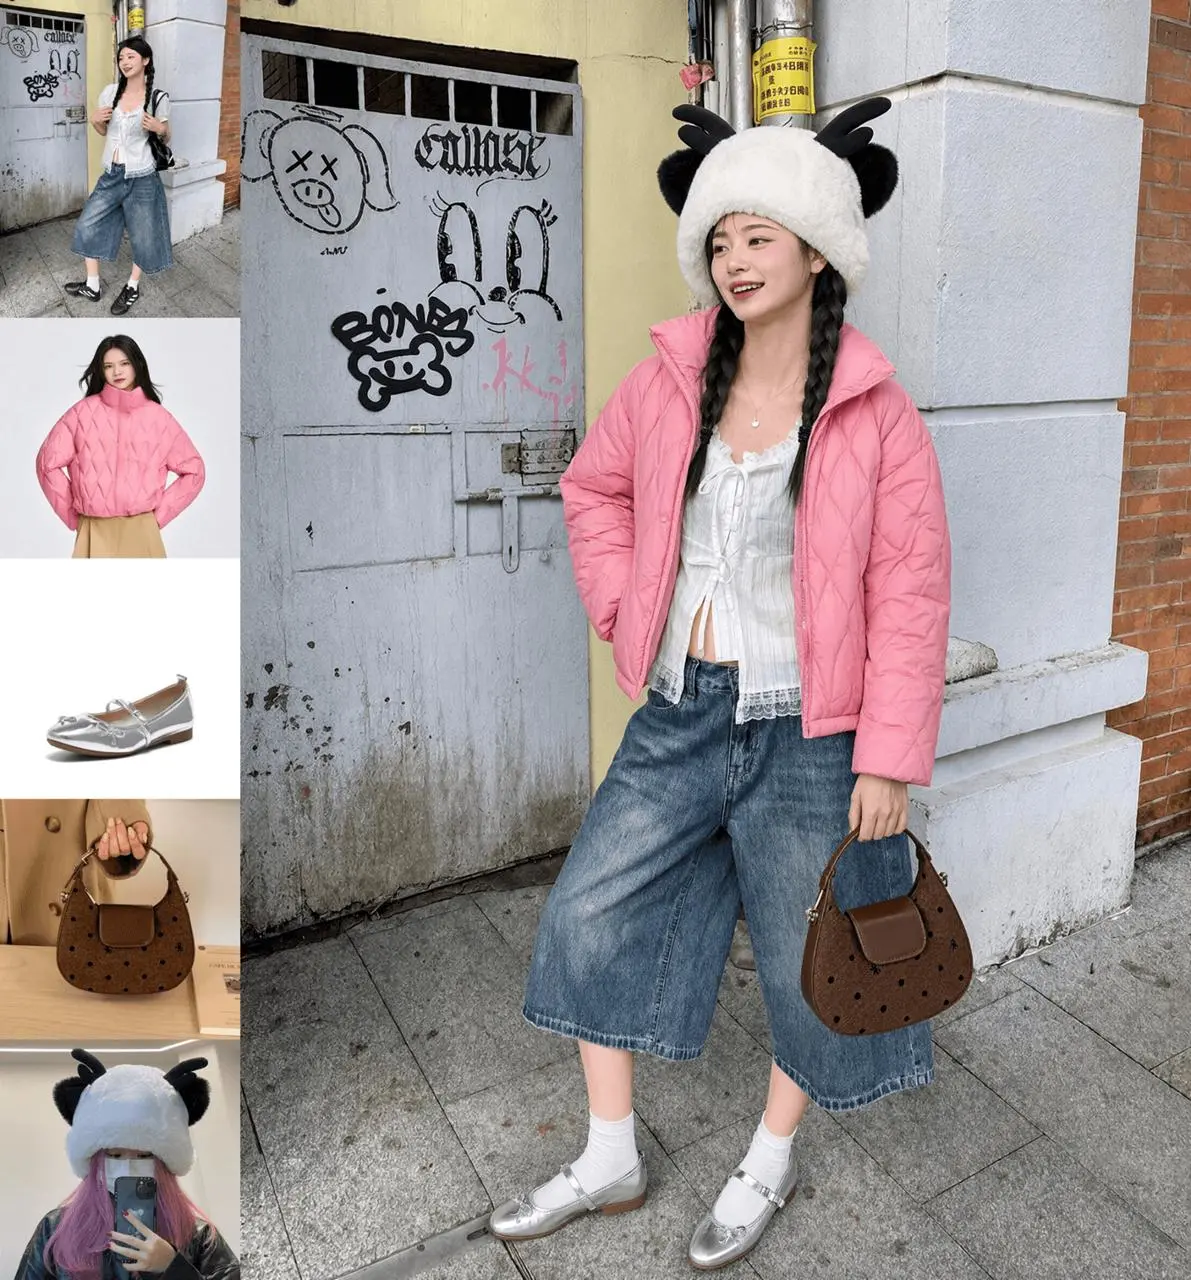
Эта архитектура особенно важна при редактировании нескольких изображений. Модель может кэшировать референсные изображения и инструкции по редактированию, вместо того чтобы заново обрабатывать один и тот же статичный контекст на каждом шаге денойзинга. Это создаёт более эффективную основу для задач, одновременно включающих человека, одежду, обувь, сумки или несколько референсов интерьерного дизайна.
2. Нативная генерация прозрачных изображений теперь встроена
Распространённый рабочий процесс — сначала создать обычное изображение, а затем удалить его фон. Вместо этого Qwen-Image-2.1 может генерировать изображения с нативным альфа-каналом, редактировать существующие прозрачные слои или извлекать выбранный объект из обычной RGB-фотографии в качестве RGBA-ассета.
Это делает функцию полезной не только для стикеров и иллюстраций. Вырезки товаров, людей, графические элементы и прозрачный текст можно сразу переносить в последующие процессы верстки и композитинга.
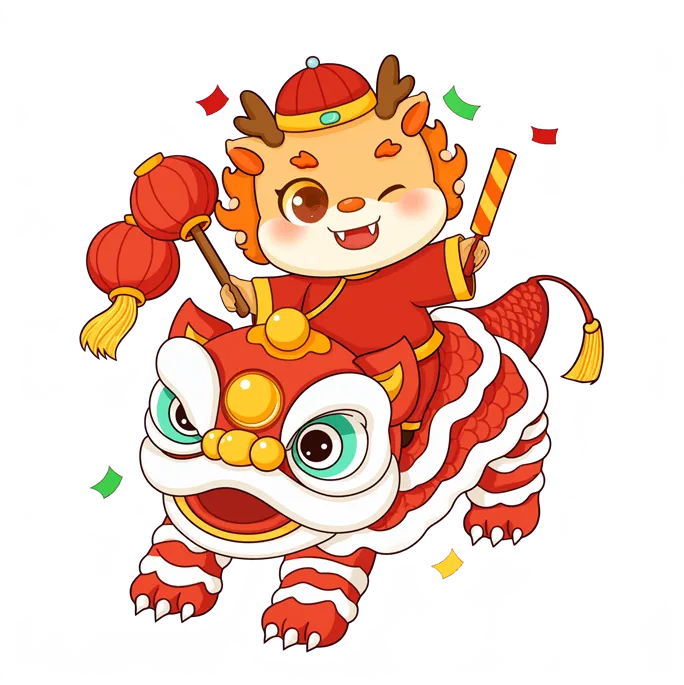
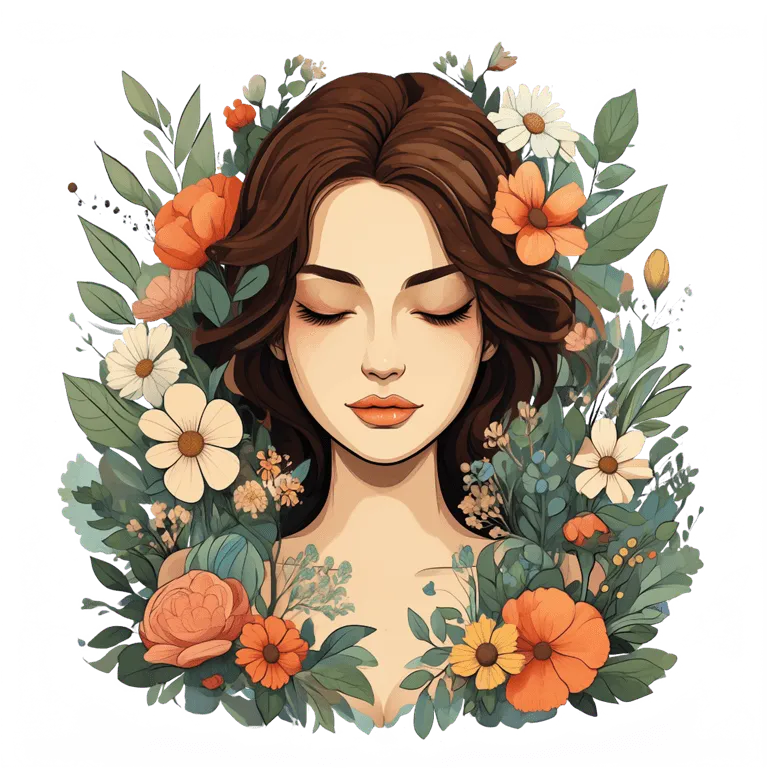
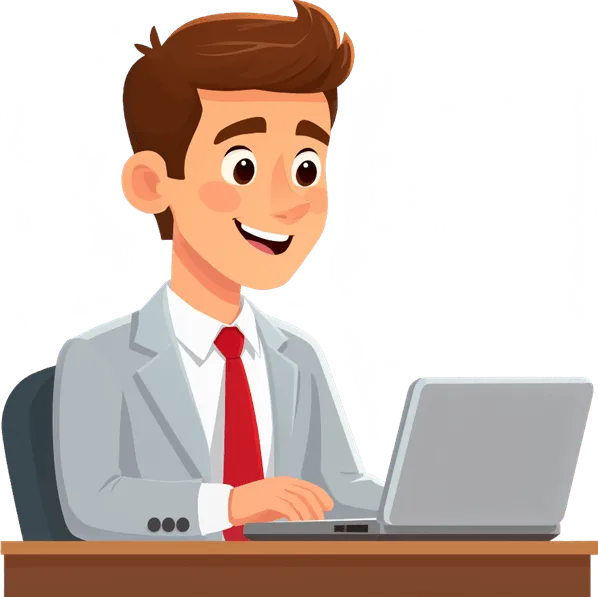
Qwen также демонстрирует редактирование выражений лица и типографики внутри прозрачных слоёв, а также извлечение объектов из реальных фотографий. Практическое изменение состоит не просто в том, что модель умеет удалять фон. Генерация, редактирование, извлечение и вывод прозрачных ассетов теперь находятся в рамках одной модели.
3. До 10 референсных изображений поддерживают более сложные композиции
Qwen-Image-2.1 поддерживает до 10 референсных изображений. Официальные демонстрации включают объединение шести портретов в групповое фото, составление образа из пяти отдельных референсов и проектирование интерьера по 10 изображениям мебели.
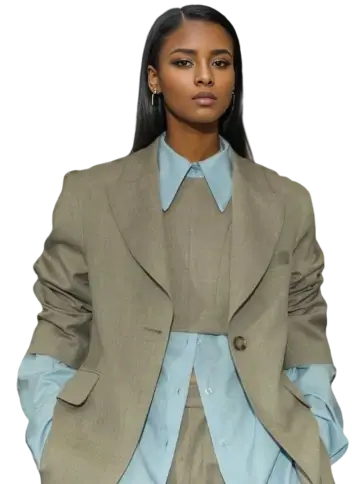
Для команд в ecommerce и моде редактирование изображений по нескольким референсам позволяет включить в одну задачу модель, одежду, обувь, сумку и референсы стилизации. Рабочий процесс больше не ограничивается редактированием одного исходного изображения за раз.
4. Круги, закрашенные области и отдельные маски могут направлять локальные правки
Локальное редактирование изображений не зависит только от текста. В материалах релиза Qwen показаны три способа обозначить целевую область:
- Обвести разными цветными кругами несколько областей, для которых нужны отдельные изменения.
- Закрасить участок, чтобы указать модели, куда добавить или чем заменить контент.
- Передать исходное изображение и отдельную маску как два входных данных, сохранив пиксели исходника, которые скрыла бы наложенная аннотация.
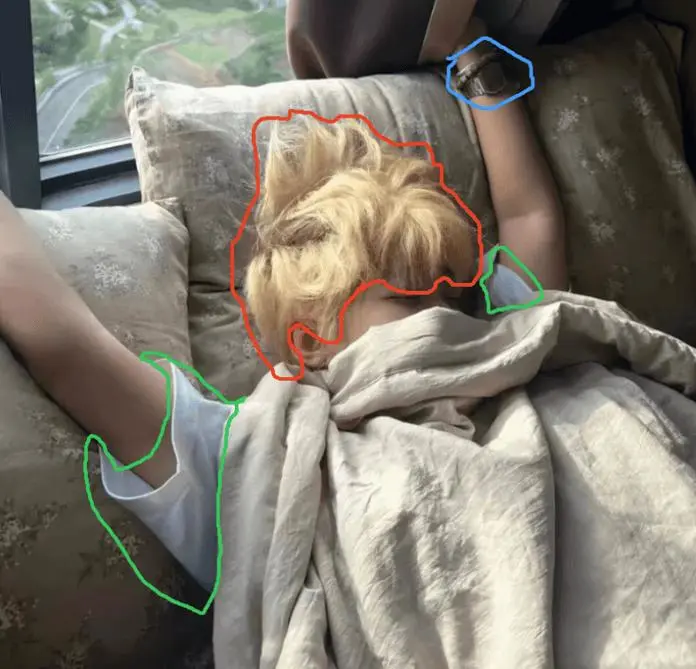
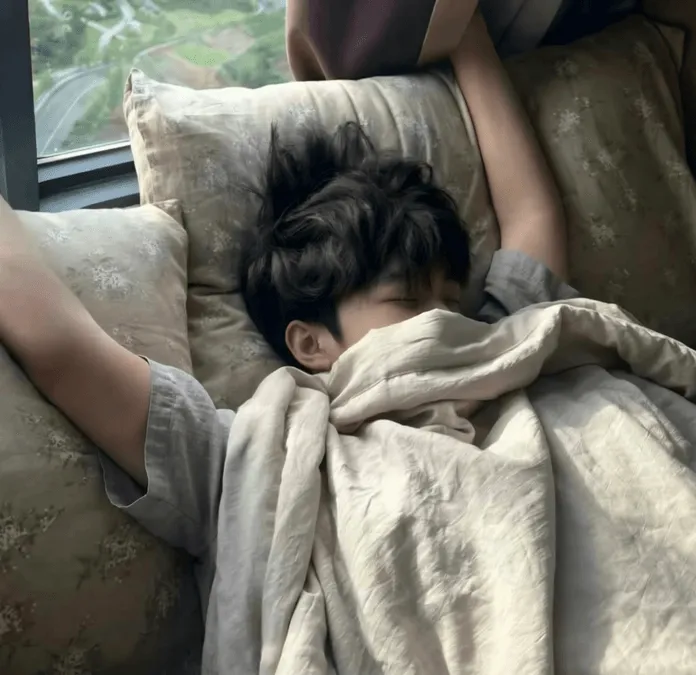
Эти входные данные точнее, чем описание в промпте «объекта слева» или «предмета вверху». Они также создают более ясный способ управления для итеративных и последовательных правок.
5. Qwen выделяет точность портретов и товаров
Qwen называет сохранение идентичности на портретах и согласованность товаров двумя основными направлениями улучшений. Портретные правки должны сохранять узнаваемые черты лица, а правки товаров сосредоточены на сохранении типографики, текстуры и формы, когда предмет перемещается в новую сцену.
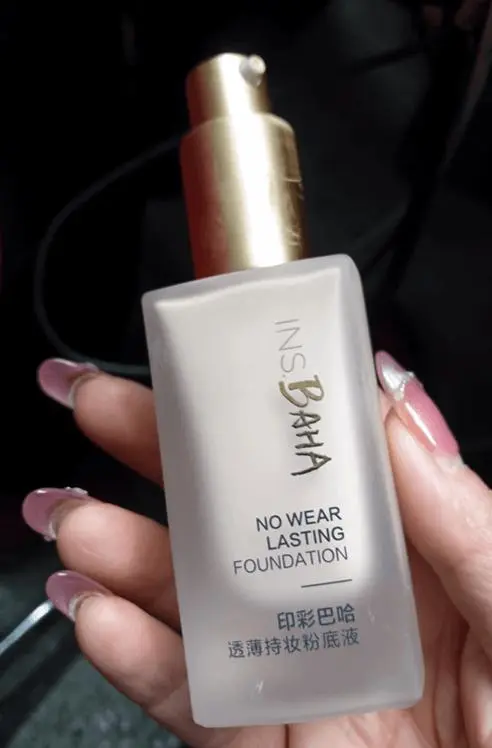
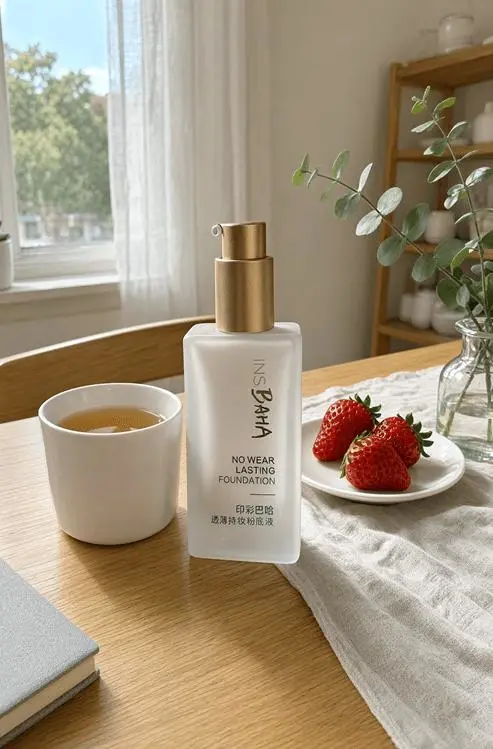
Эта возможность особенно актуальна для рабочих процессов с товарными изображениями, однако сейчас её следует описывать как официальную демонстрацию Qwen. Без повторных тестов с одинаковыми входными данными имеющиеся материалы не подтверждают стабильно высокое качество передачи товаров, достаточное для продакшена.
6. Также улучшены нативный вывод 2K, типографика и эстетика портретов
Официальная реализация использует размер по умолчанию 2048 × 2048 и перечисляет рекомендуемые размеры для форматов 1:1, 4:3, 3:4, 3:2, 2:3, 16:9 и 9:16. В материалах релиза Qwen также показаны сложная типографика, инфографика, панорамы, раскадровки, созданные по разворотам персонажей, и портреты с более продуманным освещением и детализацией.
В совокупности эти возможности делают Qwen-Image-2.1 чем-то большим, чем компактная модель преобразования текста в изображение. Она разработана для более широкого пути — от генерации ассетов до последующего редактирования.
Чего релиз Qwen-Image-2.1 пока не доказывает
- Официальные примеры не содержат достаточно полных промптов, настроек или повторных результатов, чтобы установить стабильность.
- Доступные материалы не подтверждают, что WeShop интегрировал Qwen-Image-2.1, и не содержат сведений о кредитах WeShop, времени генерации и доступных настройках.
- Открытые веса используют лицензию Qwen Research License. В официальной лицензии указано, что коммерческое использование материалов модели требует отдельной коммерческой лицензии.
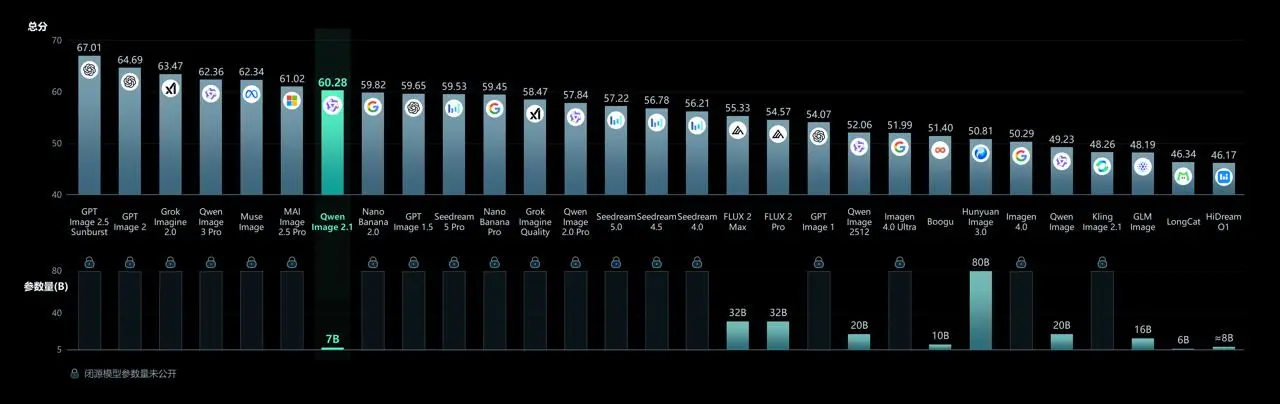
- Qwen-Image-Bench — это бенчмарк, опубликованный поставщиком, и он не должен заменять тестирование в реальных сценариях ecommerce, дизайна или работы с портретами.
Кому стоит обратить внимание на Qwen-Image-2.1?
- Визуальным дизайнерам, которым нужны прозрачные изображения людей, товаров, стикеров или элементы для композитинга.
- Командам ecommerce и моды, которые комбинируют моделей, одежду, обувь, сумки и другие референсы.
- Создателям, которые хотят управлять локальными правками с помощью кругов, закрашенных областей или масок.
- Разработчикам, заинтересованным в меньшей модели, локальном развёртывании и более эффективном инференсе для нескольких изображений.
Итог
Релиз Qwen-Image-2.1 можно резюмировать одним предложением: компонент визуальной генерации с 7 млрд параметров теперь обрабатывает обычные и прозрачные изображения, композиции по нескольким референсам и локальное редактирование в рамках одного творческого конвейера.
Его наиболее примечательные подтверждённые возможности — нативный вывод RGBA и поддержка до 10 референсных изображений. Следующий вопрос — насколько надёжно он справляется со сложными товарами, портретами, типографикой и локальными правками при повторных генерациях в реальных условиях.