












Curta Cômico Kling 4.0: De Uma Vez vs Plano a Plano
Compare quatro vídeos de comédia com IA de 30 segundos feitos com Kling 4.0 e Seedream 5.5: geração de uma vez versus edição plano a plano, em retrato e paisagem.
Um aluno culpa o cachorro pelo dever de casa desaparecido. Um ganso entra carregando o caderno. “Ele também comeu o cachorro”, explica o aluno. A professora analisa as evidências, dá a aula ao ganso e se senta para tomar notas.
Fizemos este curta de comédia com IA de 30 segundos usando Kling 4.0 Reference, com imagens do Seedream 5.5 como referências. Um fluxo de trabalho gerou o vídeo completo em uma única solicitação. O outro gerou seis clipes separados e os montou em uma edição. Ambos têm versões em paisagem e retrato, oferecendo quatro vídeos finalizados para comparar.
Assista à mesma comédia em sala de aula feita de duas formas
One-pass · Landscape
Shot-by-shot · Landscape
One-pass · Portrait
Shot-by-shot · Portrait
Os quatro vídeos finalizados têm 30 segundos, com diálogos em inglês e legendas em chinês/inglês. As exportações originais em paisagem são 1920 × 1080; as exportações em retrato são 1080 × 1920, a 24 fps. Os players do artigo usam cópias de reprodução da Biblioteca de Mídia em 854 × 480 e 480 × 854, respectivamente, mantendo a duração de 30 segundos, a taxa de quadros e o áudio. As pessoas são adultos fictícios em uma sala de aula para adultos na Rússia. Os visuais e os diálogos originais foram gerados por IA; as legendas e a finalização foram adicionadas depois.
| Escolha de produção | Geração de uma vez | Geração e edição plano a plano |
|---|---|---|
| Solicitações de vídeo por formato | Uma solicitação de 30 segundos | Seis solicitações de 6 segundos |
| Quem determina os cortes internos? | O modelo interpreta toda a linha do tempo | O editor seleciona os trechos de origem e os pontos de corte |
| Preparação de imagens | Imagem-mestre da sala, três fotos de cena, três mapas de posicionamento | Recursos compartilhados mais uma foto e um mapa separados da entrega do giz |
| Finalização usada aqui | Legendas, ajuste de volume; fala repetida removida no retrato | Montagem, cortes guiados por diálogos, reenquadramento selecionado, ajuste de volume e legendas |
| Principal trade-off | Menos controle sobre exatamente quando cada momento acontece | Mais verificações de continuidade entre clipes gerados separadamente |
Uma única geração não significa uma tomada contínua de câmera. O vídeo gerado pode conter cortes. Da mesma forma, a edição plano a plano significa cortar clipes gerados, com controle da edição quadro a quadro; não geramos cada quadro individual como uma imagem separada.
Crie as referências antes de pedir movimento
A história precisa de três sujeitos reconhecíveis: Elena, a professora com óculos de leitura vermelhos e cardigã cinza-escuro; Misha, um aluno adulto com suéter creme; e um ganso branco comum. Uma imagem-mestre da sala de aula estabeleceu suas aparências ao lado do quadro verde, das carteiras de madeira e da luz da janela.
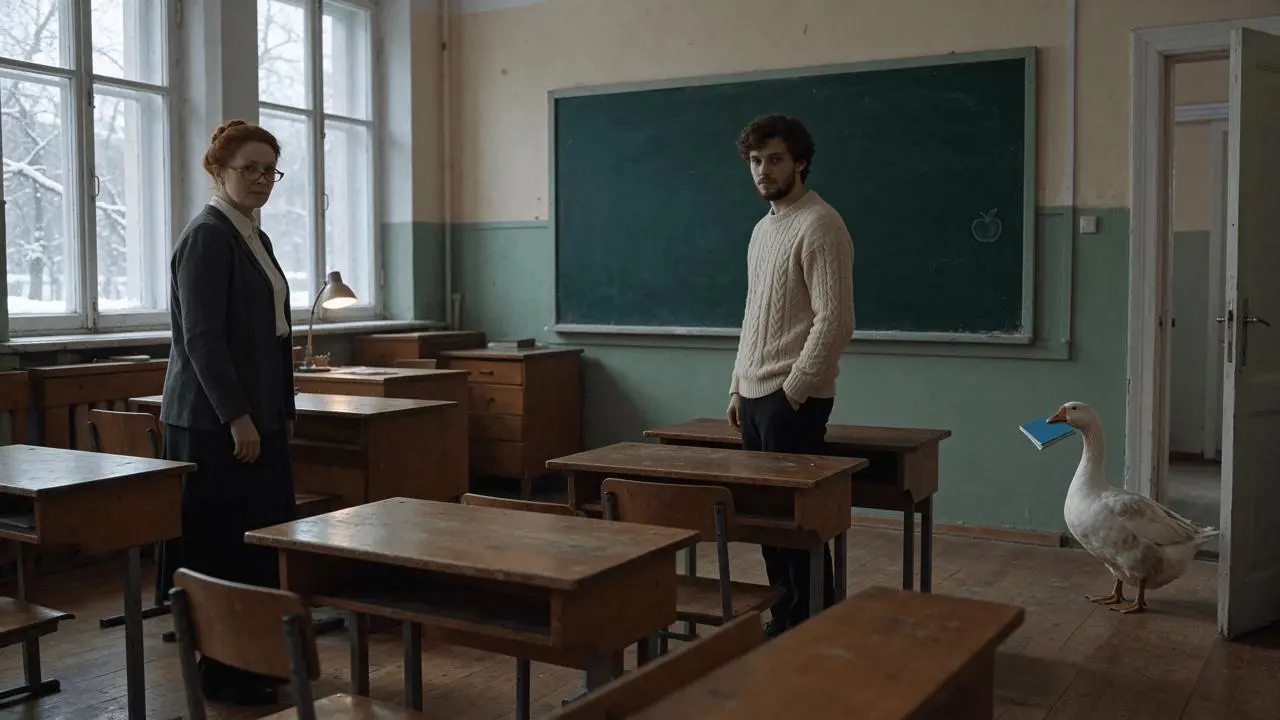
Usamos o Seedream 5.5 pelo WeShop CLI para preparar essa imagem-mestre, depois as principais fotografias das cenas e os mapas de posicionamento. Ambos os fluxos de vídeo reutilizaram essa base visual. O projeto usou uma imagem compartilhada da sala de aula como referência de identidade; ele não criou primeiro vistas de personagem independentes nem folhas de rosto separadas.
Para cada proporção, prepare três configurações fotográficas: a verificação do dever de casa, a chegada do ganso com um caderno azul e o ganso ensinando enquanto ambos os humanos tomam notas. Trate-as como momentos separados de uma mesma história.
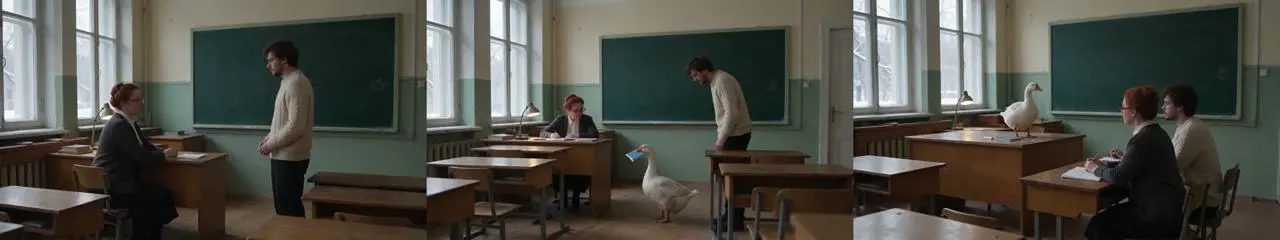
Em seguida, crie um mapa de posicionamento simplificado correspondente para cada configuração. Preserve a visão da câmera, o enquadramento, o tamanho relativo, a posição, a direção para a qual os sujeitos estão voltados e a oclusão. Use contornos finos de cores distintas para identificar os sujeitos, deixando a aparência e a iluminação para as fotos.
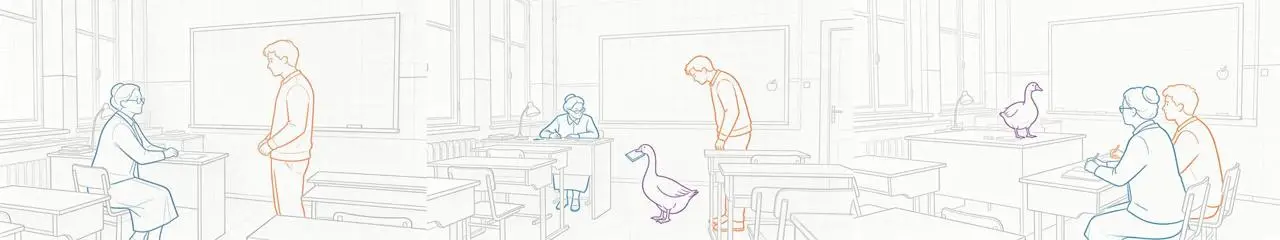
Em nossos prompts, azul identificava Elena, laranja identificava Misha e roxo identificava o ganso. Essas cores identificavam os sujeitos apenas nos diagramas. O figurino real veio das referências fotográficas. As fotos foram anexadas antes dos mapas, com a função de cada imagem explicitamente atribuída no prompt. Essas são escolhas de produção testadas neste exemplo, e não uma garantia de posicionamento exato.
Rota 1: Gere o filme completo de 30 segundos de uma vez
Abra Kling no WeShop e selecione Kling 4.0 Reference. Para reproduzir este caso, use 30s, 1080p, quantidade 1, com 16:9 para paisagem ou 9:16 para retrato. Essas são as configurações registradas em nossas solicitações de geração; consulte a referência da API WeShop para obter detalhes atuais da operação via CLI.
Anexe sete imagens em ordem: a imagem-mestre, as três fotos de cena e os três mapas correspondentes. Use as imagens preparadas para o formato selecionado. Os dois formatos foram gerados separadamente, com suas próprias composições de cena e mapas.
Escreva a história completa em um único prompt. Atribua primeiro as referências e, depois, apresente a ordem das ações, os diálogos exatos, as tarefas de atuação e o som. A linha do tempo compacta abaixo mostra a estrutura solicitada, e não um registro medido de cada corte no resultado:
| Intervalo solicitado | Momento da história |
|---|---|
| 0–9s | A professora pergunta pelo dever de casa; o aluno culpa o cachorro; uma pausa redireciona a atenção |
| 9–18s | O ganso chega com o caderno; a professora o identifica; o aluno intensifica sua desculpa |
| 18–25s | A professora avalia a interrupção e transfere a autoridade de ensinar |
| 25–30s | O ganso ensina; ambos os humanos tomam notas; o aluno tenta fazer uma pergunta |
O caso reutilizável contém o prompt original completo e suas sete entradas de referência. Este é um trecho das instruções de atuação:
“Onde está seu dever de casa?” — exija responsabilidade e verifique sua disposição para responder. “Isso é um ganso.” — dê a ele a chance de corrigir sua história. “Ótimo. Você ensina.” — dê ao ganso a responsabilidade, verificando se ele a aceita.
A professora está tentando manter a aula em andamento. O aluno está tentando fazer sua desculpa sobreviver às novas evidências. O ganso busca atenção e ocupa a posição de ensino. Dar uma tarefa a cada sujeito torna a situação absurda compreensível sem pedir aos atores que anunciem a piada.
Inspecione o resultado antes de adicionar legendas
Verifique as falas, a visibilidade do caderno, as posições na sala e a inversão final de papéis. Inspecione se contornos coloridos ou estilo de diagrama aparecem nas imagens. Os resultados analisados mantiveram imagens fotográficas, e ambas as versões de uma vez chegaram ao final com o ganso ensinando, mas os tempos e as ações solicitados não foram seguidos exatamente.
O original em retrato repetiu “Ótimo. Você ensina.” Durante a finalização, a segunda ocorrência em 21.65–24.65s foi substituída pelo som ambiente copiado de 6.4–9.4s do mesmo vídeo. A imagem permaneceu intacta. Ambos os formatos receberam legendas alinhadas à fala gerada e uma etapa de ajuste de volume. Os players acima mostram essas versões finalizadas, e não os resultados brutos sem alterações.
Rota 2: Gere seis planos e controle a edição final
Para o segundo fluxo de trabalho, adicionamos uma foto de referência e um mapa de posicionamento dedicados da professora entregando a autoridade na carteira. Isso deu à transição sua própria configuração visual, em vez de deixar toda a transferência para o prompt do filme completo.
Cada plano usou Kling 4.0 Reference, 6s, 1080p, quantidade 1. Os conjuntos em paisagem e retrato foram gerados independentemente. Cada solicitação incluiu a imagem-mestre, a foto de cena relevante e seu mapa de posicionamento, com as instruções necessárias de identidade, local, diálogo e som repetidas integralmente.
| Plano | Contribuição | Duração final mantida |
|---|---|---|
| 1 | Pergunta sobre o dever de casa e a primeira desculpa | 6s |
| 2 | Ganso carregando o caderno: uma breve inserção de evidência | 1s |
| 3 | “Isso é um ganso.” / “Ele também comeu o cachorro.” | 6s |
| 4 | A professora delega a aula ao ganso | 6s |
| 5 | O ganso ensina; ambos os humanos tomam notas | 5s |
| 6 | O aluno levanta a mão, recebe uma grasnada e volta a escrever | 6s |
O plano inicial era manter cinco segundos de cada fonte de seis segundos, deixando meio segundo em cada extremidade para cortes. O diálogo real não coube nessas janelas planejadas. Alteramos a edição para 6 + 1 + 6 + 6 + 5 + 6 = 30 segundos, preservando as falas completas.
O caderno também revelou um problema de continuidade: mais adiante na fonte da chegada do ganso, ele já não correspondia ao estado exigido pelo plano seguinte. Mantivemos o primeiro segundo como inserção. Isso tornou a chegada do caderno compreensível, evitando a parte final inconsistente do clipe. Foi uma solução editorial, e não um reparo da ação original gerada.
A edição final aplicou recortes fixos ao terceiro e ao sexto planos para variar o enquadramento, normalizou o volume e adicionou legendas bilíngues. O diálogo gerado separadamente foi mantido; repetir uma descrição de voz nos prompts não deve ser confundido com prova de vozes perfeitamente idênticas entre clipes.
Componha retrato e paisagem como cenas separadas
Em paisagem, a sala oferece mais separação horizontal entre a professora, o aluno e o ganso. O retrato precisa de uma composição que ainda mostre a relação entre eles, o caderno e a carteira. Por isso, este projeto preparou cenas e mapas de referência 9:16 distintos e depois gerou as imagens em retrato separadamente.
Observe a entrada do caderno e o momento final da mão levantada nos dois formatos. Eles revelam mais sobre encenação e timing cômico do que comparar um único quadro atraente. O vídeo final em retrato não é simplesmente um recorte central da saída em paisagem, embora alguns planos tenham recebido reenquadramento adicional durante a edição.
Escolha o fluxo de trabalho em torno do momento que você precisa preservar
Use a rota de uma vez quando quiser testar se a piada completa funciona e puder aceitar que o modelo interprete os cortes internos. Ainda assim, você precisa revisar a fala, os objetos e o final, depois finalizar o resultado.
Escolha a rota plano a plano quando a transferência, a pausa de reação ou a pergunta final precisar de seu próprio tempo de tela preservado. Ela também permite revisar um clipe de origem mantendo os outros, ao custo de verificar a continuidade e o som entre gerações separadas.
Estes quatro vídeos documentam um exemplo de produção, e não uma referência de taxa de sucesso. Comece com o caso completo de 30 segundos na sala de aula, inspecione o que seu resultado realmente preserva e divida a cena em planos quando um momento específico precisar de mais controle.
Você pode experimentar diretamente usando a ferramenta à direita.