





AI着せ替え:服装・モデル・背景の参照画像を組み合わせる方法
衣装、成人モデル、背景の参照画像をそれぞれ指定し、明確な3画像プロンプトを使って、コントロールされたAIファッション画像を作成する方法を学びます。
AI画像ジェネレーター:GPT Image 2.5で衣装・モデル・背景の参照画像を使うAI着せ替え
1枚目の画像で、モデルが何を着るかを決めます。2枚目の画像で、誰が着るかを決めます。3枚目の画像で、完成写真の撮影場所を決めます。
生成結果では、ショートヘアのモデルが衣装参照画像のチャコールコート、ブラックトップス、オーバーサイズのトラウザーズ、シルバーのスニーカーを着用し、ロケーション画像の淡い壁と石段の前に立っています。
AIに単に「服を着せ替えて」と指示して写真全体を再デザインさせるのではなく、このワークフローでは各参照画像に明確な役割を与えます。
このチュートリアルでは、WeShop AI GPT ImageをAI着せ替えとして使用し、衣装画像、成人モデルの写真、背景参照画像を1つのファッションビジュアルに組み合わせます。
自分が所有している画像、または使用許可を得た成人モデルの写真のみを使用してください。
このAI着せ替えワークフローで必要なもの
以下の3つの参照画像を用意します。
- 目的のコーディネート全体が写った全身画像
- 成人モデルの鮮明な写真
- 希望する背景と構図が写ったロケーション画像
各参照画像は、生成画像の異なる部分をコントロールします。
| 参照画像 | コントロールする要素 | コントロールすべきでない要素 |
|---|---|---|
| 図1 | 衣服、履物、レイヤリング、シルエット | モデルのアイデンティティまたは最終背景 |
| 図2 | 顔、ヘアスタイル、肌の色、アイデンティティ | 衣服またはロケーション |
| 図3 | 背景、構図、ライティング、被写体の配置 | 最終モデルのアイデンティティまたは衣装 |
背景参照画像には別の人物、衣装、ハンドバッグ、サングラス、アクセサリーなどが含まれている場合があるため、この分離は重要です。
プロンプトで各画像の用途を定義しない場合、それらの不要なディテールが生成結果に現れる可能性があります。
ステップ1:衣装参照画像をアップロードする
図1は衣装参照画像です。
最終画像に表示するべきコーディネート全体を指定します。
- チャコールのフルレングスコート
- ブラックのクルーネックトップス
- オーバーサイズのダークグレーのプリーツトラウザーズ
- シルバーのスニーカー
- ゆったりとした低彩度のシルエット
- コート、トップス、トラウザーズのレイヤリング
| 衣装参照画像 — 図1 |
|---|
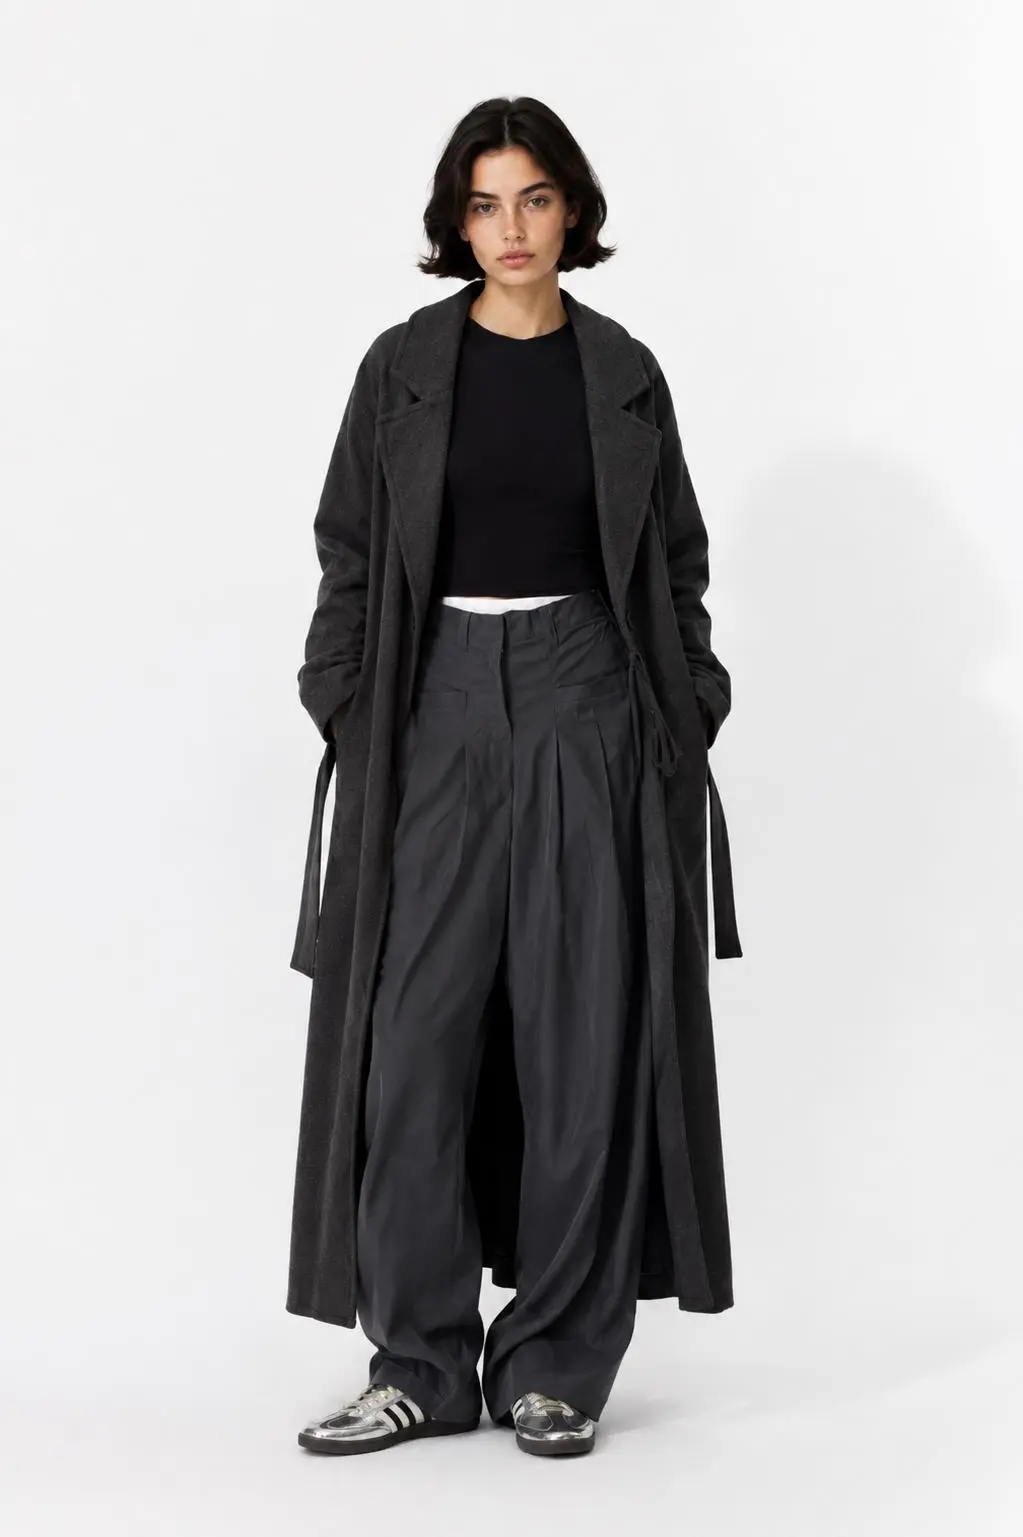 |
| 図1は衣装、履物、服のプロポーション、全体的なスタイリングをコントロールします。 |
この画像内の人物は、アイデンティティの参照ではありません。最終モデルの顔とヘアスタイルは図2から取得する必要があります。
この区別により、AI着せ替えが元のファッション写真をそのまま再現してしまうことを防げます。
ステップ2:成人モデルの参照画像をアップロードする
図2はアイデンティティ参照画像です。
モデルの目に見える特徴を提供します。
- 短い黒髪のヘアスタイル
- 顔の骨格
- 目、鼻、唇
- 肌の色
- ナチュラルメイク
- ミニマルで落ち着いたファッションの雰囲気
| 成人モデル参照画像 — 図2 |
|---|
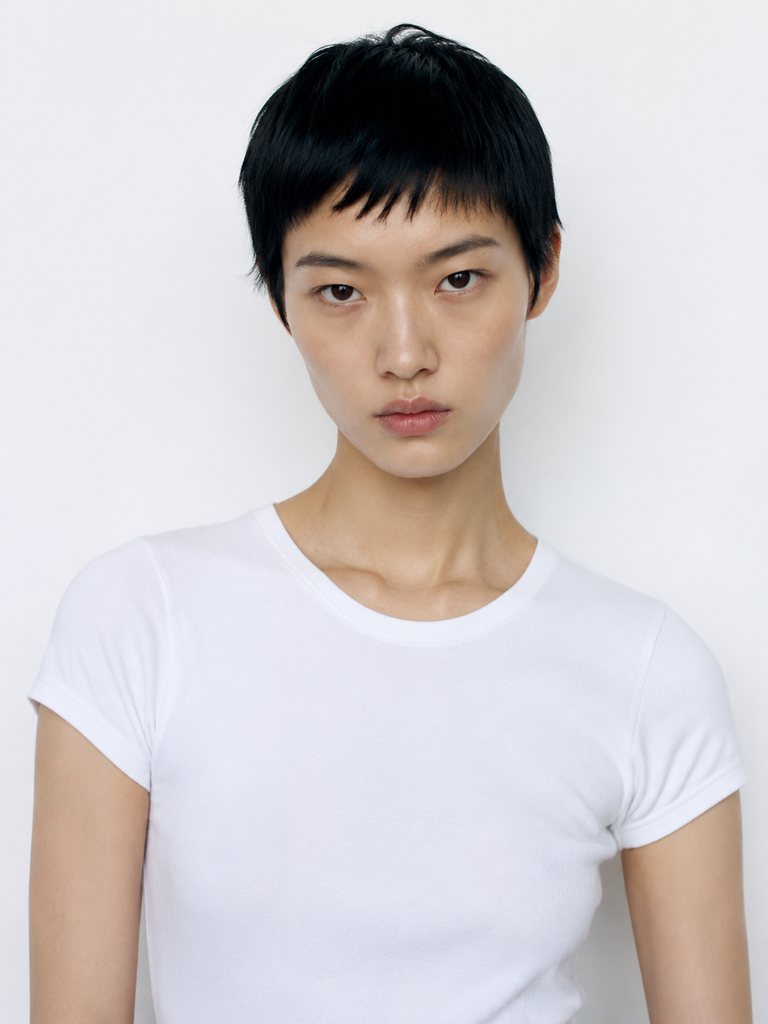 |
| 図2は成人モデルの顔のアイデンティティ、ショートヘア、肌の色、全体的な外見を提供します。 |
参照画像にはモデルの上半身しか写っていないため、AIは欠けている身体、全身ポーズ、衣服のフィット感を推測する必要があります。
そのため、結果は実在する人物の身体や実際の衣服を正確に表現したものではなく、クリエイティブなAI合成として扱うべきです。
ステップ3:背景参照画像をアップロードする
図3は環境と基本構図をコントロールします。
役立つ視覚情報には以下が含まれます。
- 淡い色の外壁
- ダークウッドの出入口
- グレーの石段
- 全身を収めた縦構図
- 壁のそばへの被写体配置
- 柔らかな屋外の自然光
- 抑制されたストリートスタイルの雰囲気
| 背景参照画像 — 図3 |
|---|
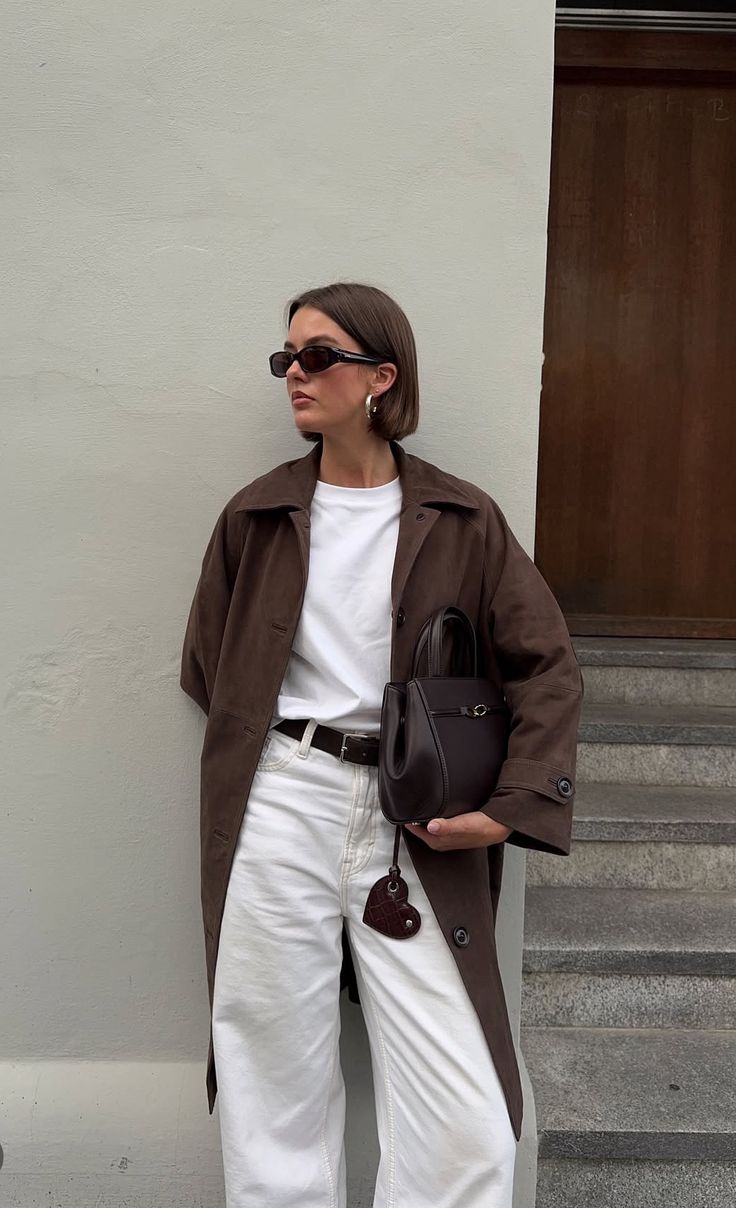 |
| 図3は建築的な背景、カメラ構図、自然光、被写体の配置を提供します。 |
図3にすでに写っている人物を最終モデルにしてはいけません。
その人物の顔、衣装、サングラス、イヤリング、ハンドバッグ、その他の個人的なディテールは、意図的に指定した場合を除いて無視してください。
ステップ4:3画像プロンプトを入力する
プロンプトの最短バージョンでは、3つの参照画像の関係性を説明します。
シンプルなプロンプト
図2のモデルが図1の服を着用し、図3の背景の前に立っています。
これで基本的な目的は伝わりますが、モデルに複数の判断を委ねることになります。
- どの顔のディテールを図2から取得する必要があるか?
- どの衣服のディテールを図1から維持する必要があるか?
- 図3は環境のみをコントロールすべきか?
- 図3のアクセサリーをコピーすべきか?
- 構図のどの部分を変更してよいか?
より構造化されたプロンプトを使うと、AI着せ替えにより明確な境界を与えられます。
そのまま使えるプロンプト
図1を衣装参照、図2を成人モデルのアイデンティティ参照、図3を背景および構図の参照として使用してください。

図2の成人モデルが図1のコーディネート全体を着用し、図3の建築的な環境に立っている、全身を収めた縦構図のストリートスタイル写真を作成してください。

図2のモデルの短い黒髪、認識できる顔の特徴、肌の色、自然な体型バランスを維持してください。

図1のチャコールのロングコート、ブラックトップス、オーバーサイズのダークグレーのプリーツトラウザーズ、シルバーのスニーカー、服のレイヤリング、ゆったりしたシルエットを維持してください。

図3の淡い外壁、ダークウッドの出入口、石段、自然光、カメラアングル、被写体の配置を維持してください。

図3は環境と構図にのみ使用してください。図3の元の人物、衣服、サングラス、イヤリング、ハンドバッグ、その他の個人的なアクセサリーはコピーしないでください。

リアルな布のシワ、正確な手足、自然な接地影、一貫性のある身体プロポーションを備えたフォトリアルな仕上がりにしてください。

ロゴ、テキスト、ウォーターマーク、追加の衣服、無関係なアクセサリー、新しいデザインディテールは追加しないでください。
このバージョンでは、各画像に明確な役割を割り当てています。
- 図1が衣装をコントロールする
- 図2がモデルをコントロールする
- 図3が背景と構図をコントロールする
また、ロケーション参照画像内のサングラス、ジュエリー、ハンドバッグ、元の衣服が意図せずコピーされることも防ぎます。
ステップ5:AI着せ替え画像を生成する
WeShop AI GPT Imageを開き、プロンプトで使用した順番と同じ順序で参照画像を追加します。
- 図1を衣装参照画像としてアップロードします。
- 図2を成人モデル参照画像としてアップロードします。
- 図3を背景参照画像としてアップロードします。
- 3画像プロンプトを貼り付けます。
- 全身を収めた縦構図の結果を生成します。
利用できる機能は変わる場合があるため、ツールページに表示される現在のステータスとコントロールに従ってください。
右側のツールを使って直接お試しいただけます。
最初の結果で図3のサングラス、ジュエリー、ハンドバッグ、その他のスタイリングが誤って引き継がれた場合は、シーン全体を書き直すのではなく、対象を絞った修正を続けて行ってください。
現在のモデル、衣装、ポーズ、背景、ライティング、構図を変更しないでください。

図3からコピーされたサングラス、イヤリング、ハンドバッグ、その他のアクセサリーをすべて削除してください。

モデルの顔とヘアスタイルは引き続き図2に従い、コーディネート全体は引き続き図1に従う必要があります。
この追加指示では、すでに正しい部分を保護しながら、不要な要素を特定できます。
ステップ6:生成結果を確認する
最終画像は、3つすべての参照画像からの情報を組み合わせています。
| AI生成結果 — 図4 |
|---|
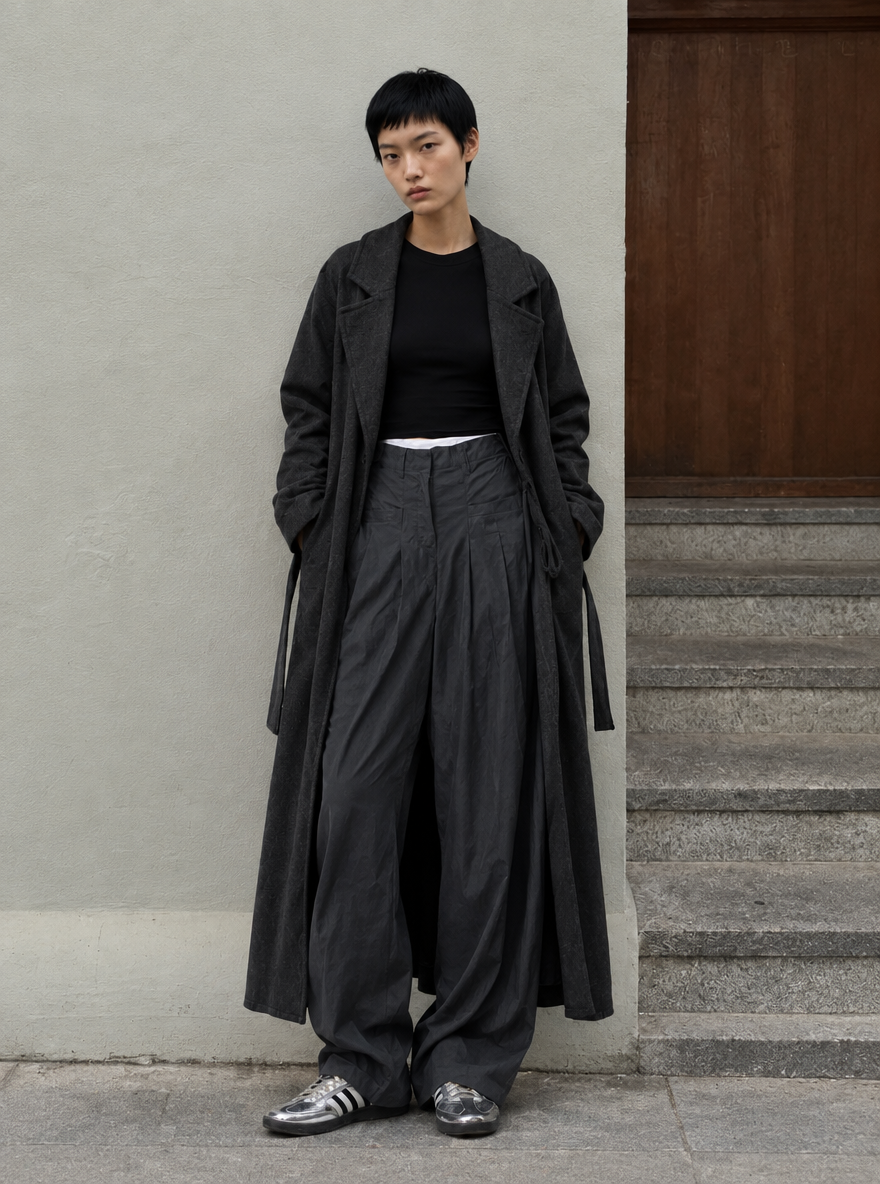 |
| 生成結果は、図1の衣装、図2の成人モデルのアイデンティティ、図3の建築的な環境を組み合わせています。 |
完成した画像には、いくつかの認識可能な要素が維持されています。
- 短い黒髪と主な顔立ちは図2から取得されています。
- チャコールコート、ブラックトップス、オーバーサイズのトラウザーズ、シルバーのスニーカーは図1から取得されています。
- 淡い壁、木製の出入口、石段、被写体の位置は図3から取得されています。
- 最終構図は、全身を収めた縦構図のストリートスタイル写真のままです。
この結果は、複数参照画像による画像生成でよくある問題も示しています。ロケーション参照画像は、背景以上の要素に影響を与えることがあります。
モデルや衣装を別の画像から取得する場合でも、サングラスなどのアクセサリーが図3から引き継がれる可能性があります。アクセサリーが目的のスタイリングに含まれない場合は、メインプロンプトで明示的に除外するか、対象を絞った2回目の編集で削除してください。
「服を着せ替える」だけでは具体性が足りない理由
「服を着せ替える」のような基本的な指示では、画像モデルがあまりにも多くの判断を行わなければなりません。
モデルは次のことを推測する必要があります。
- どのコーディネートを使うか
- どの人物を維持するか
- 人物をどこに立たせるか
- 最終的な環境をどのように見せるか
- アクセサリーを残すかどうか
- どの視覚的ディテールを再デザインしてよいか
3つの参照画像を使うワークフローは、これらの判断を分離します。
衣装画像はファッション商品を定義します。モデル画像は人物を定義します。背景画像はロケーションと構図を定義します。次に、プロンプトでこれらの参照画像をどのように連携させるかを説明します。
このアプローチは、以下の用途に活用できます。
- ファッション商品画像
- Shopify向け衣料品ビジュアル
- ルックブックのコンセプト
- SNS向けコーディネートコンテンツ
- モデルとロケーションの実験
- ファッションのプリプロダクションコンセプト
- ECキャンペーンのドラフト
販売用画像では、生成された衣服を実際の商品と手作業で比較してください。商品画像として提示する前に、丈、色、素材、構造、留め具、アクセサリーを確認しましょう。
3つの参照画像からコントロール可能なファッション画像を作る
効果的なAI着せ替えプロンプトは、「誰が衣装を着るのか」「何を着るのか」「写真はどこで撮影されるのか」という3つの質問に答えます。
図1、図2、図3は、それぞれの質問に個別に答えます。GPT Image 2.5はこれらを1つのファッションビジュアルに組み合わせ、プロンプトによってどのディテールを分離して維持すべきかを定義します。
この役割分担により、関連性のない3つの参照画像を、よりコントロールしやすく再利用可能なファッションコンテンツのワークフローへと変えられます。