




GPT Image 2.5:OpenAI最新画像モデルの新機能
GPT Image 2.5の向上した参照画像の忠実度、より精密な編集、マルチターンでの一貫性、クリエイティブコントロール、高速な画像生成を紹介します。
GPT Image 2.5は、印象的な画像を1枚生成すること以上に重要な課題、すなわち制作を続ける間も適切なディテールを維持することに焦点を当てています。OpenAIの新しい画像モデルは、より鮮明なレンダリング、高速な生成、より制御しやすい編集、そして複数回の修正にわたる一貫性の向上を組み合わせています。
OpenAIは2026年9月8日にChatGPT Images 2.5を発表しました。このモデルはChatGPT、ChatGPT Work、Codexで順次提供されており、開発者はGPT-Image-2.5 FlareとGPT-Image-2.5 Sunburstの2つのAPIバリエーションを利用できます。
GPT Image 2.5の主なアップグレード
今回のリリースは、画像をより洗練された見た目にするだけのものではありません。参照画像の活用から、アセットを作り直さずに狙った変更を加えることまで、制作ワークフロー全体に役立つ改善が含まれています。
参照画像の忠実度向上
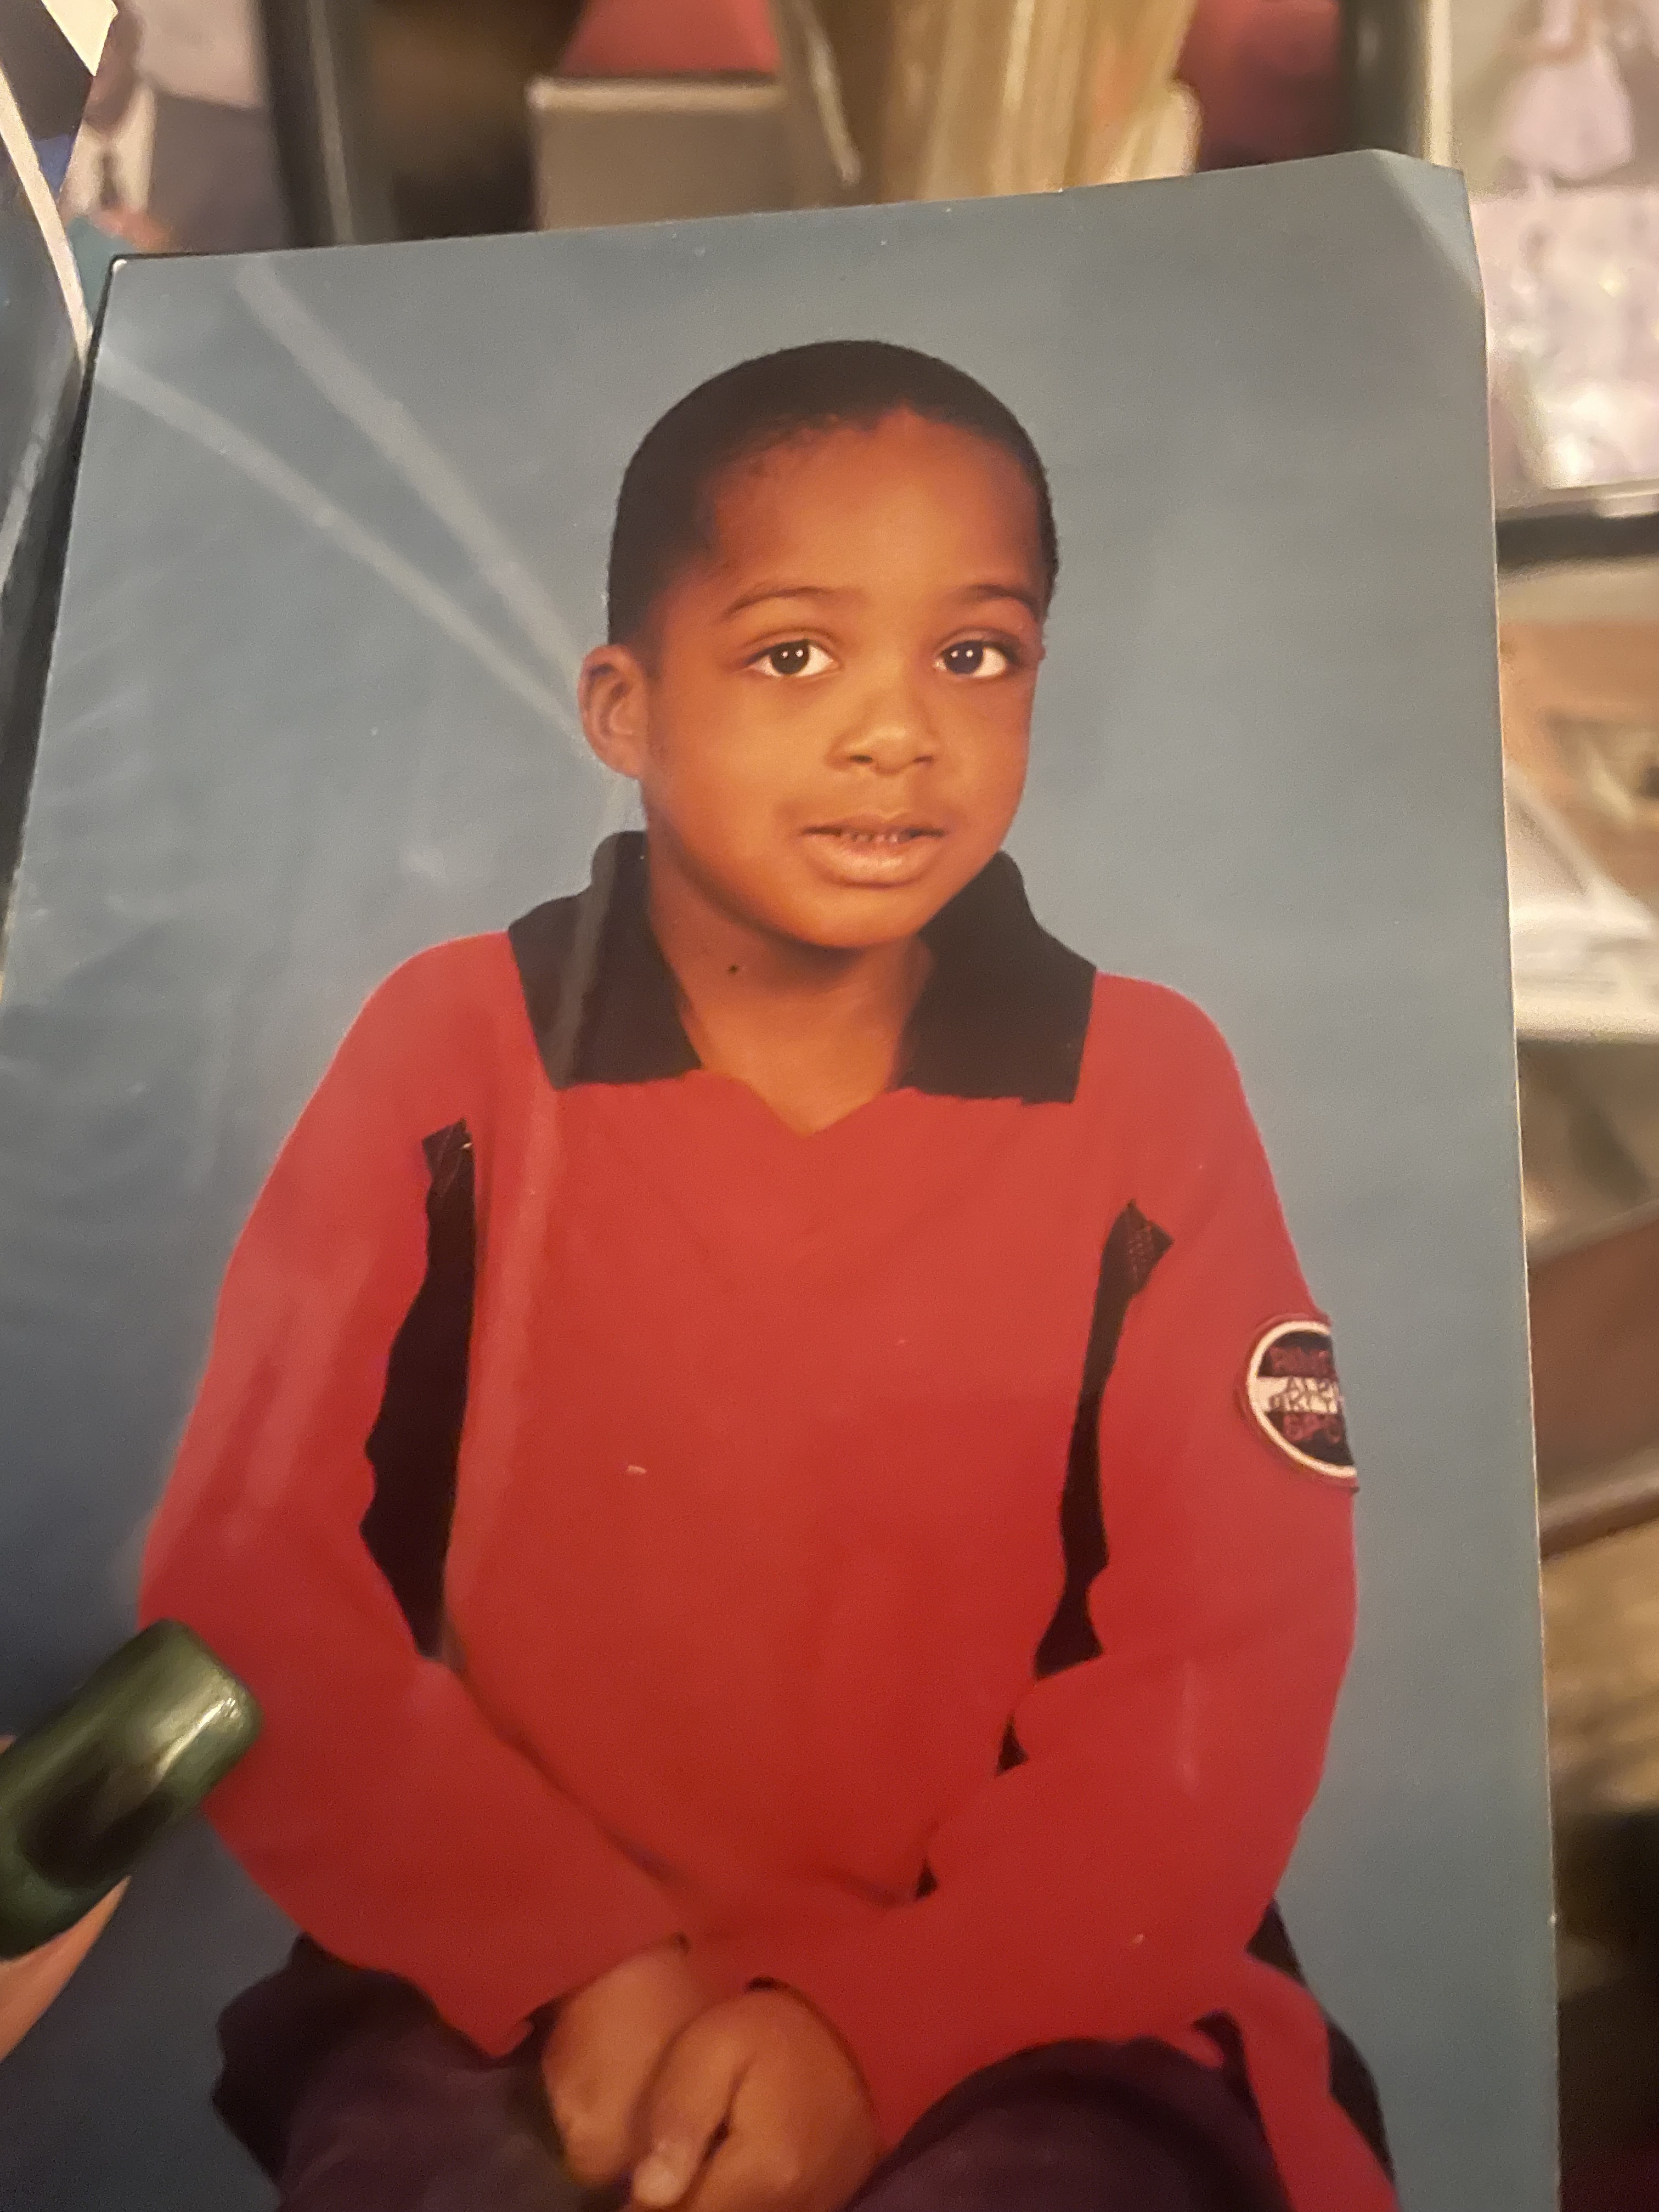
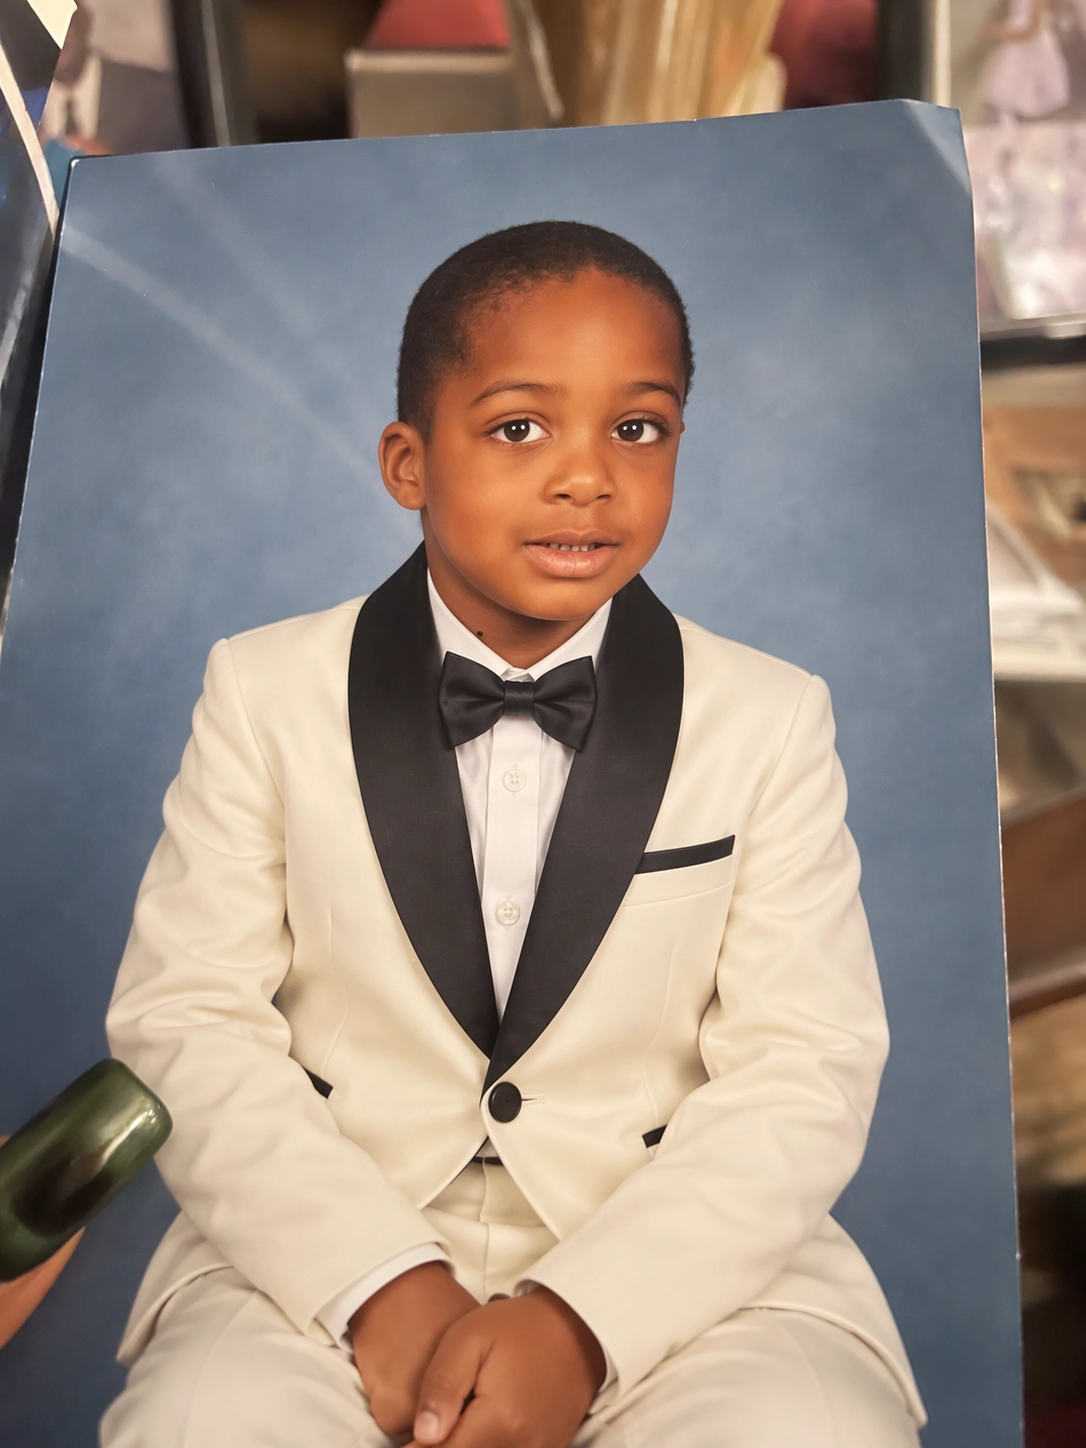
参照写真を使って新しいシーン、スタイル、構図を作成する場合、被写体は認識できる状態で維持される必要があります。OpenAIによると、GPT Image 2.5は参照画像の特徴的な要素をより適切に保持しながら、より自然なライティングと豊かなテクスチャを生成できます。
このアップデートは、人物、製品、場所、繰り返し登場するキャラクターなど、元の画像との視覚的なつながりを保つ必要があるアセットを扱うワークフローに特に適しています。
| 入力 | 編集結果 |
|---|---|
 |  |
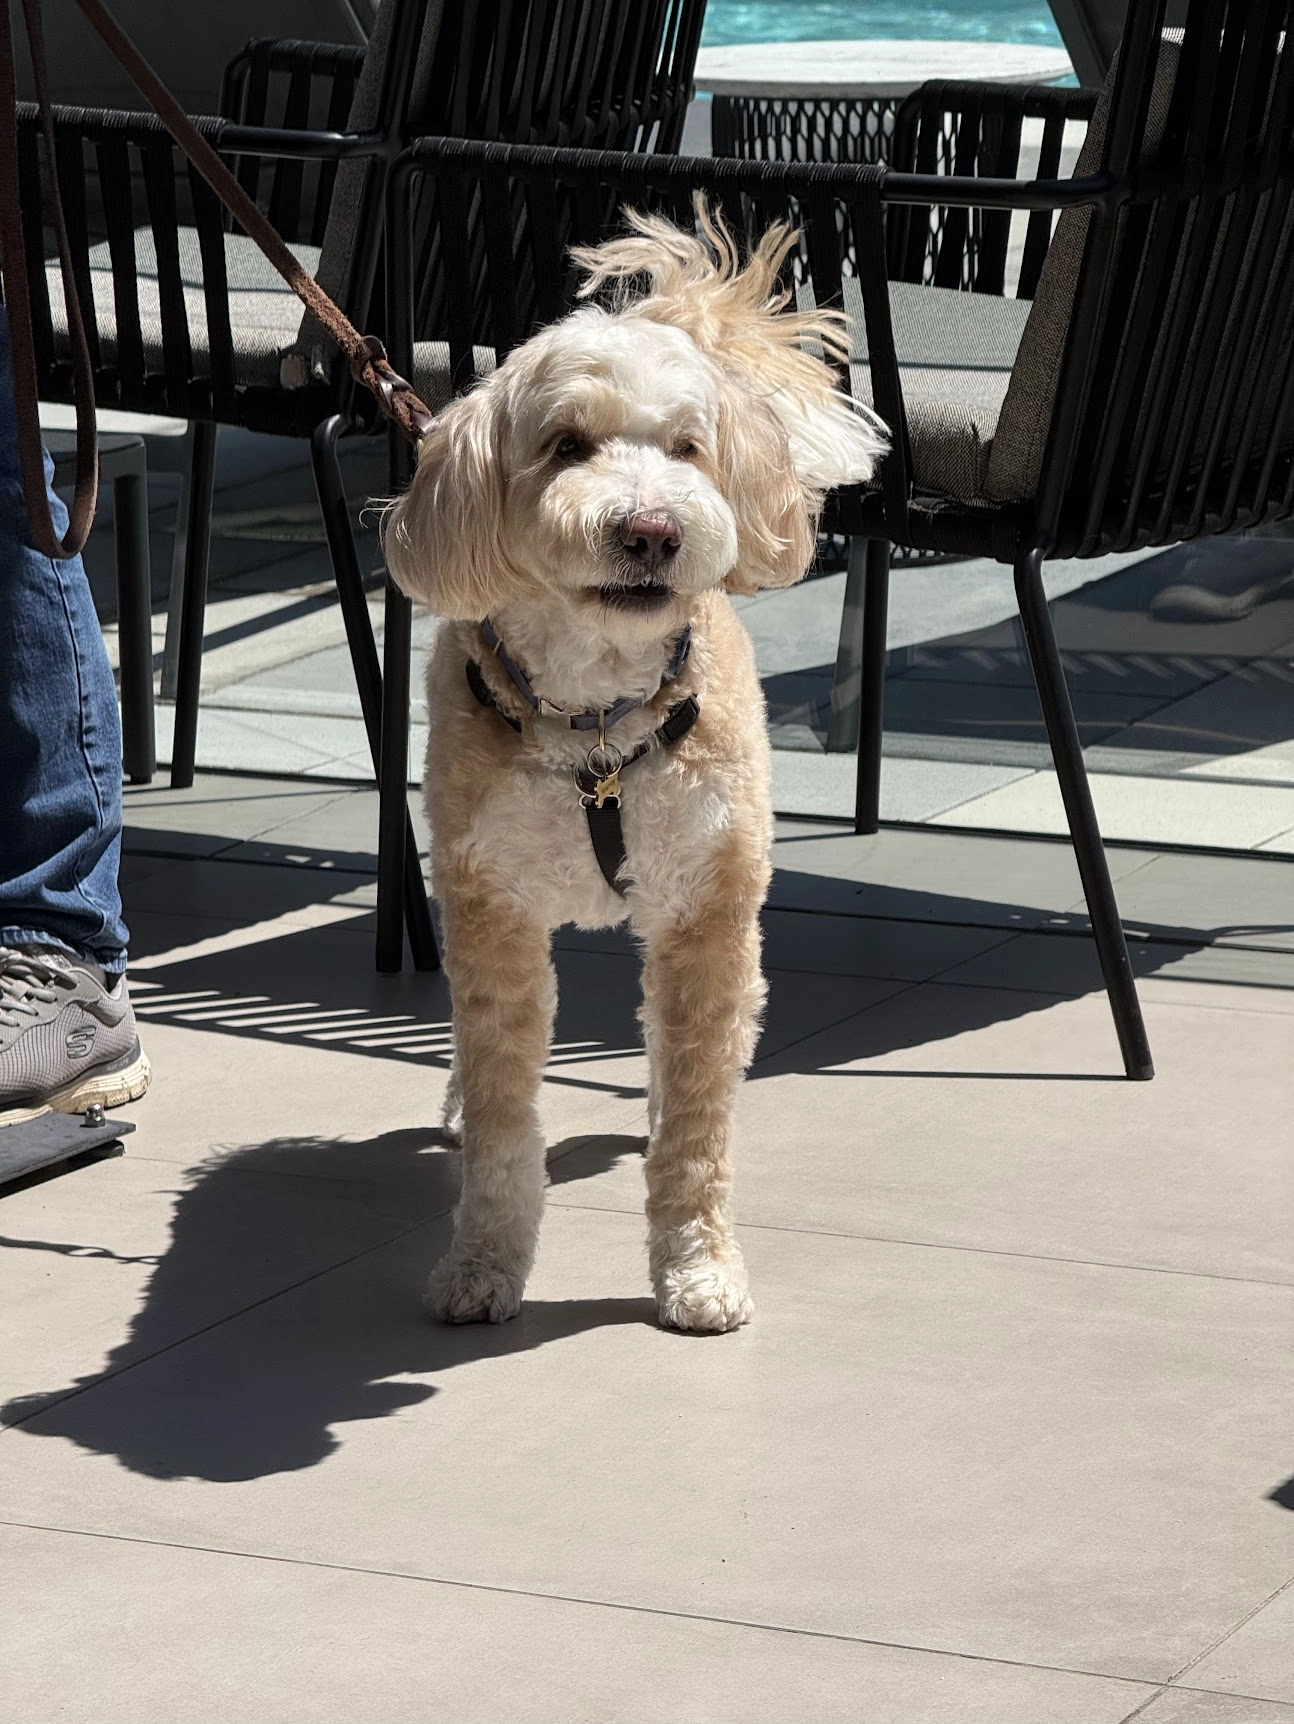
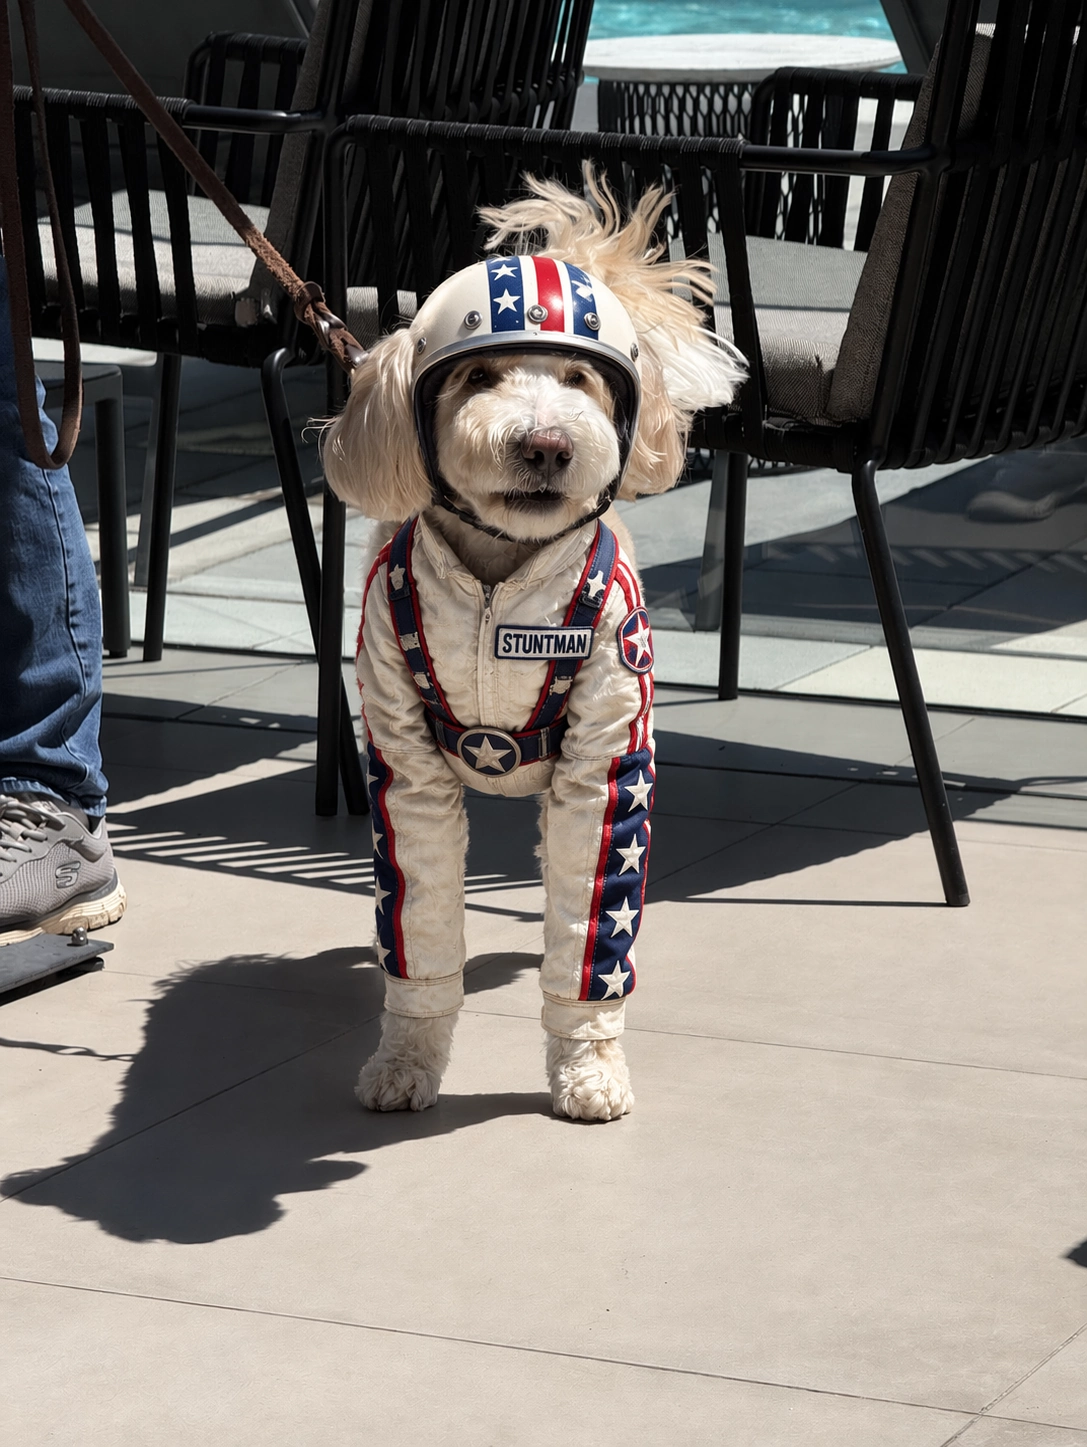
リリースページでは、ペットでも同じ参照主導のアプローチが示されています。犬は認識できる状態を保ちながら、服装が精巧なスタント用コスチュームへと変化しています。
| 入力 | 編集結果 |
|---|---|
 |  |
より精密な画像編集
画像編集は、依頼した変更によって被写体、構図、背景、ブランド表現まで変化してしまうと失敗しがちです。GPT Image 2.5は、指定された要素を変更しつつ、無関係なディテールをより安定して維持するよう設計されています。
OpenAIは、ビジュアル全体を再構築せずに製品、背景、コピーの一部を変更するといった実用的な編集例を紹介しています。これは、製品画像、マーケティングアセット、レイアウトの修正など、小さな変更を小さな変更のままにしたい用途で役立ちます。
上の入力画像と編集後のポートレートは、リリースページの参照主導ワークフローを示しています。指定された服装は変化していますが、ポーズと青いスタジオ背景は視覚的な基準として維持されています。
全身のシーケンスでは、GPT Image 2とGPT Image 2.5における連続編集を比較しており、1枚の最終フレームだけでなく、複数の変更にわたる違いを確認しやすくしています。
リリースではシンプルな部屋の編集も用いられ、要求された1つの状態だけを変更しながら、シーン全体を認識可能なまま維持できることを示しています。
| 入力 | 編集結果 |
|---|---|
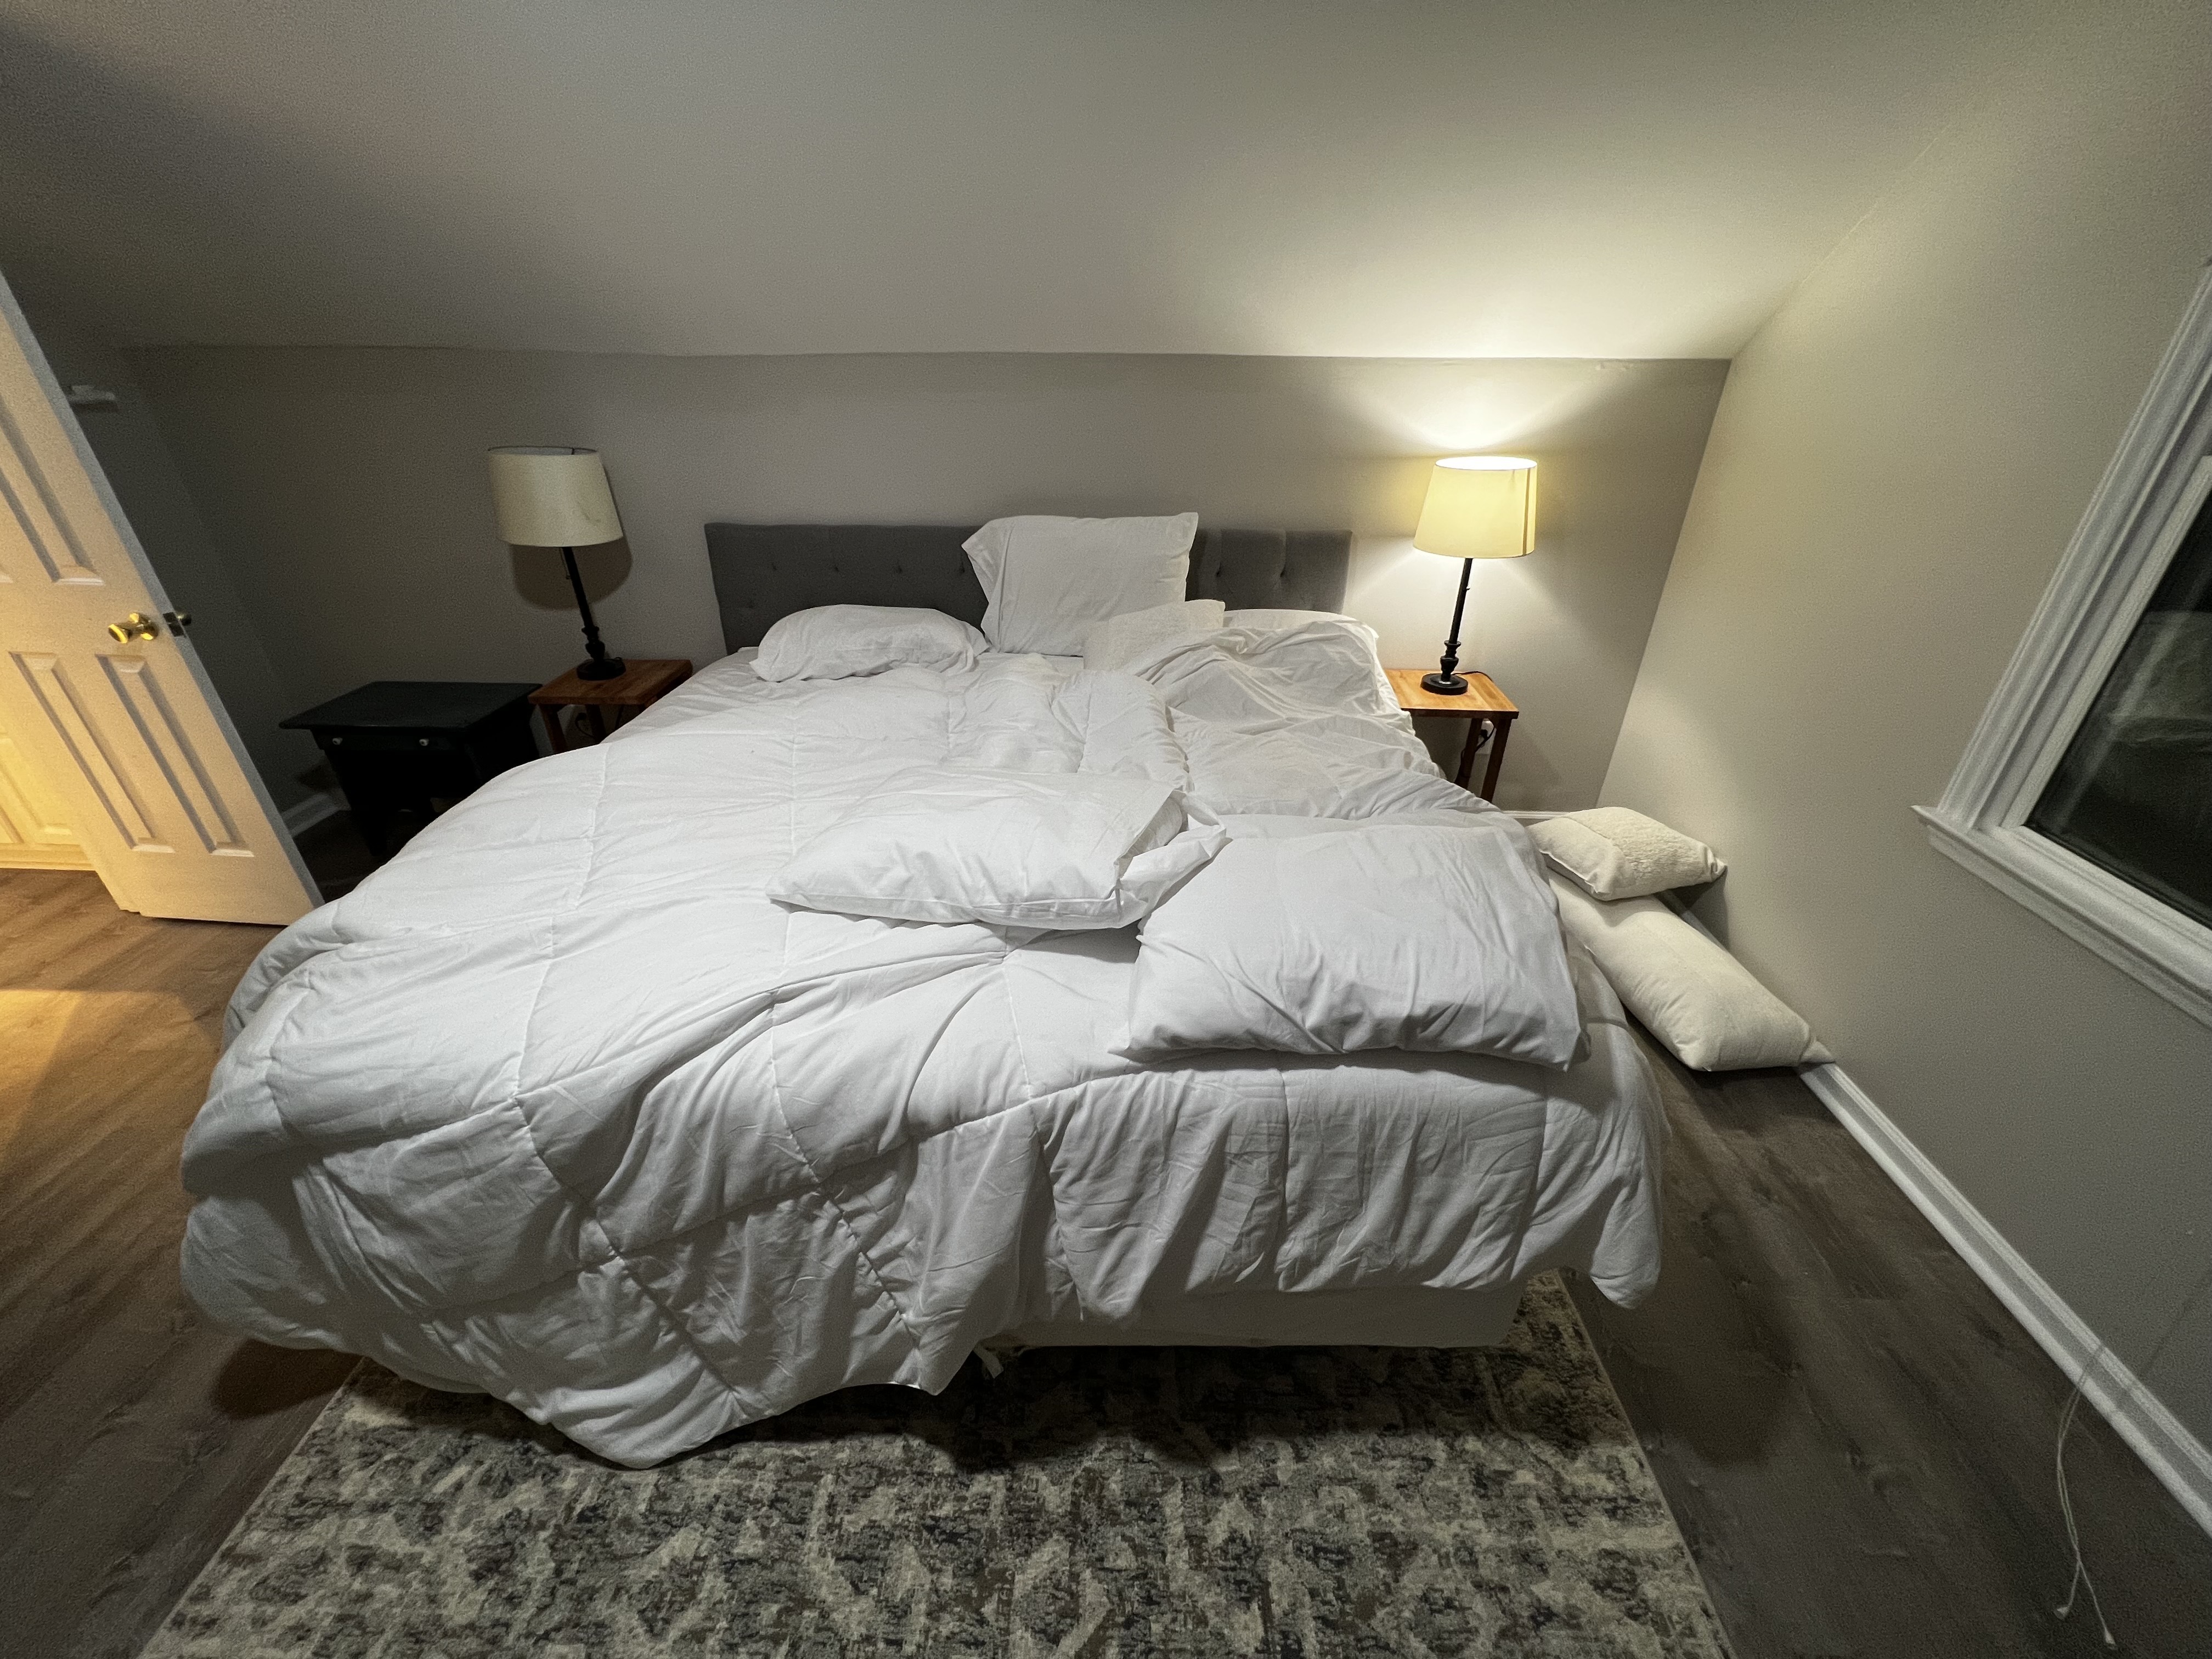 | 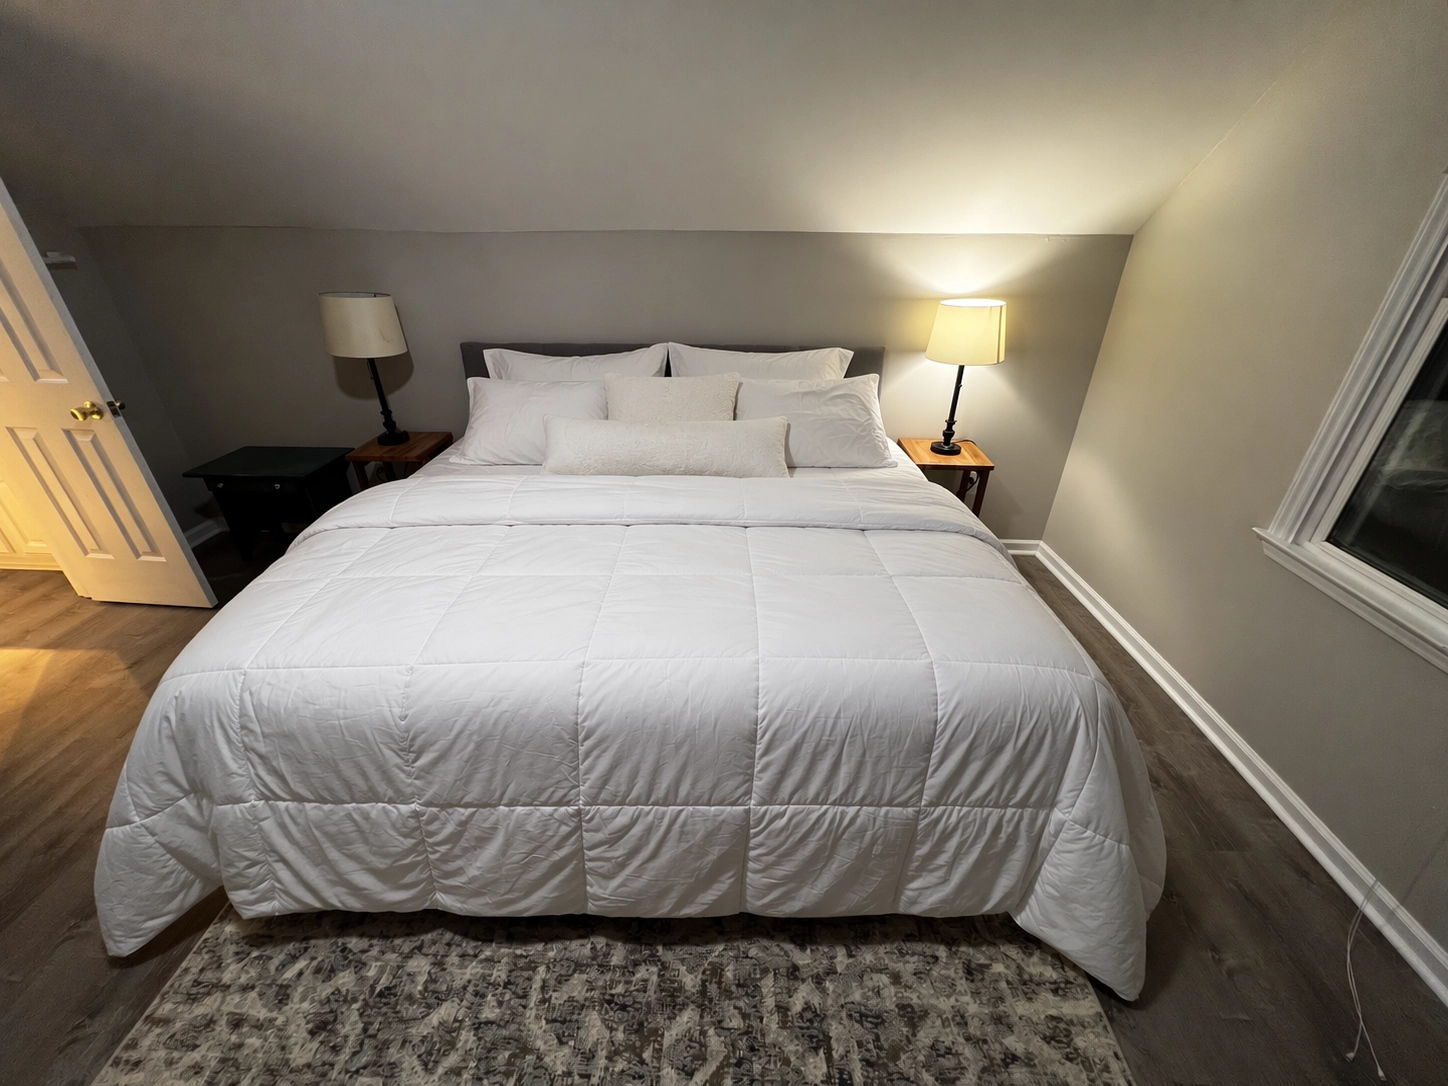 |
複数回の編集における一貫性の強化
画像に何段階もの調整が必要な場合、1回の編集が成功するだけでは十分ではありません。より長い会話の中でも、GPT Image 2.5は新しい指示が追加された際に以前の変更をより確実に保持することを目指しています。
これにより、あるディテールを修正した結果、以前の改善が消えてしまうという、よくあるクリエイティブ上のドリフトを軽減できます。そのため、このアップデートは一発生成だけでなく、反復的な制作ワークフローにも関連します。
キューブ回転のシーケンスでは、オブジェクトが一回転を通じて構造的な整合性を維持できるかを検証しています。これは、静的な1フレームを単に再スタイル化するよりも厳しい一貫性の例です。
旅行インフォグラフィックのシーケンスでは別の課題が示されています。編集が積み重なっても、写真、旅程の詳細、テキストが1つのレイアウトとして機能し続ける必要があります。
より高度なレイアウト、スタイル、透過画像
GPT Image 2.5は、複雑な視覚指示への対応も改善しています。OpenAIは特に、現実世界の情報、より複雑なレイアウト、透過背景、指定されたビジュアルスタイルへの忠実な対応を強化したと説明しています。
これらの機能は、次のようなアセットに役立ちます。
- 製品の切り抜きや透過背景のグラフィック
- 1つのビジュアル方針を共有するキャンペーンバリエーション
- 明確な階層構造を持つUIコンセプト
- プレゼンテーション用グラフィックや構造化された構図
- 1つのブリーフ内で複数の視覚要件を組み合わせる画像
これらは独立したベンチマーク結果ではなく、公式に発表された機能に関する説明です。出力品質は、入力、プロンプト、設定、タスクの複雑さによって変動する可能性があります。
より高速な画像生成
OpenAIによると、画像生成のレイテンシはImages 2.0と比較して最大50%削減されています。同社は、日常的な制作や大量のワークフローに向けた、より高速な標準APIオプションとしてGPT-Image-2.5 Flareを位置付けています。
Sunburstは異なるニーズを対象としています。生成時間は長くなるものの、詳細なクリエイティブ作業や編集作業に向けて、より精密なコントロールを提供します。この2つのバージョンは単純な「良い」と「より良い」の違いではなく、それぞれ異なる制作要件を優先しています。
ChatGPTの新しいクリエイティブコントロール
Images 2.5のリリースでは、モデルに関連するChatGPTの製品機能もいくつか導入されています。
- スケッチ: ChatGPT内でラフなビジュアル参照を直接描画
- テンプレート: ポスター、商品、製品写真などの形式から開始
- 画像コメント: 画像の特定箇所にフィードバックを配置
- プロンプト共有: 他のユーザーが独自の詳細を加えて画像アイデアを再利用
これらの機能はChatGPTの体験に属するものであり、すべてのAPIベースの実装に存在すると想定すべきではありません。
GPT Image 2.5は誰に向いている?
文書化された機能に基づくと、GPT Image 2.5は、一度生成して終わりではなく、画像を継続的に洗練させる必要があるクリエイターやチームに最も適しています。特に期待できる価値は、参照画像に基づく制作、狙いを定めた編集、繰り返し行うキャンペーン修正、製品画像、ビジュアルプロトタイピング、構造化されたクリエイティブアセットにあります。
この記事は、OpenAIのGPT Image 2.5発表で説明されている機能を要約したものです。独立したハンズオンレビューとして提示するものではありません。
より実用的な画像モデルのアップグレード
GPT Image 2.5の最も興味深い約束は、1枚の注目を集める画像ではありません。より信頼性の高い編集ループです。参照から始め、1つのディテールを変更し、すでにうまくいっている部分を保ち、不必要なドリフトを抑えながら調整を続けられます。
FlareとSunburstは、異なる優先事項でこのワークフローをAPIにもたらします。どちらが制作プロセスに適しているかを判断する必要がある場合は、GPT Image 2.5 FlareとSunburstの比較記事をご覧ください。