





AI Clothes Changer: Gabungkan Referensi Outfit, Model, dan Latar
Pelajari cara membuat gambar mode AI yang terkontrol dengan menetapkan referensi terpisah untuk outfit, model dewasa, dan latar belakang, lalu menggunakan prompt tiga gambar yang jelas.
Generator Gambar AI: Pengganti Pakaian AI dengan Referensi Outfit, Model, dan Latar Belakang menggunakan GPT Image 2.5
Satu gambar menentukan pakaian yang dikenakan model. Gambar kedua menentukan siapa yang mengenakannya. Gambar ketiga menentukan lokasi pengambilan foto akhir.
Dalam hasil yang dihasilkan, model berambut pendek mengenakan mantel abu-abu arang, atasan hitam, celana longgar berukuran besar, dan sepatu kets perak dari referensi pakaian sambil berdiri di depan dinding pucat dan anak tangga batu dari gambar lokasi.
Alih-alih meminta AI untuk “mengganti pakaian” dan membiarkannya mendesain ulang seluruh foto, alur kerja ini memberi setiap gambar referensi tanggung jawab khusus.
Tutorial ini menggunakan WeShop AI GPT Image sebagai Pengganti Pakaian AI untuk menggabungkan gambar pakaian, foto model dewasa, dan referensi latar belakang menjadi satu visual mode.
Hanya gunakan gambar milik Anda sendiri atau foto model dewasa yang Anda miliki izin untuk menggunakannya.
Yang Anda Butuhkan untuk Alur Kerja Pengganti Pakaian AI Ini
Siapkan tiga gambar referensi:
- Gambar seluruh tubuh yang menampilkan outfit target secara lengkap
- Foto model dewasa yang jelas
- Gambar lokasi yang menampilkan latar belakang dan komposisi yang diinginkan
Setiap referensi mengontrol bagian berbeda dari gambar yang dihasilkan.
| Referensi | Mengontrol | Tidak Boleh Mengontrol |
|---|---|---|
| Gambar 1 | Pakaian, alas kaki, layering, dan siluet | Identitas model atau latar belakang akhir |
| Gambar 2 | Wajah, gaya rambut, warna kulit, dan identitas | Pakaian atau lokasi |
| Gambar 3 | Latar belakang, komposisi, pencahayaan, dan penempatan subjek | Identitas model atau outfit akhir |
Pemisahan ini penting karena referensi latar belakang dapat memuat orang lain, outfit, tas tangan, kacamata hitam, atau aksesori.
Jika prompt tidak menetapkan tujuan setiap gambar, detail yang tidak diinginkan tersebut dapat muncul dalam hasil yang dihasilkan.
Langkah 1: Unggah Referensi Pakaian
Gambar 1 adalah referensi pakaian.
Gambar ini menetapkan outfit lengkap yang harus muncul dalam gambar akhir:
- Mantel panjang penuh berwarna abu-abu arang
- Atasan hitam berleher bulat
- Celana lipit longgar berukuran besar berwarna abu-abu tua
- Sepatu kets perak
- Siluet longgar dengan saturasi rendah
- Layering antara mantel, atasan, dan celana
| Referensi Pakaian — Gambar 1 |
|---|
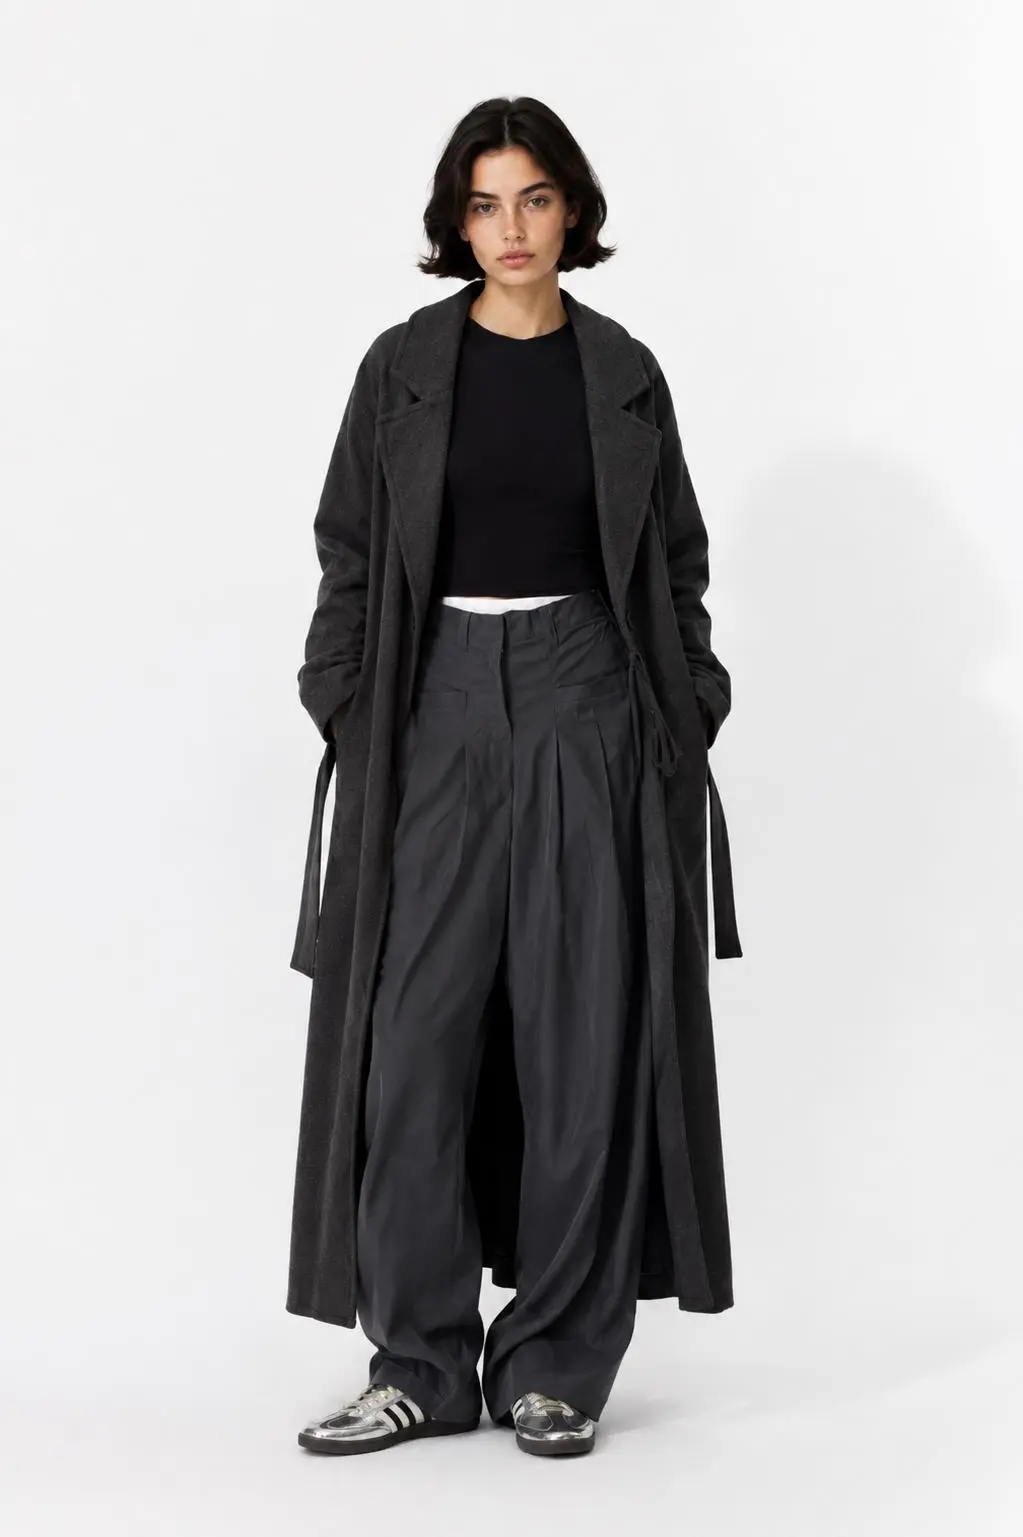 |
| Gambar 1 mengontrol outfit, alas kaki, proporsi pakaian, dan gaya keseluruhan. |
Orang dalam gambar ini bukanlah referensi identitas. Wajah dan gaya rambut model akhir harus berasal dari Gambar 2.
Perbedaan ini mencegah Pengganti Pakaian AI sekadar mereproduksi foto mode asli.
Langkah 2: Unggah Referensi Model Dewasa
Gambar 2 adalah referensi identitas.
Gambar ini menyediakan karakteristik model yang terlihat:
- Gaya rambut hitam pendek
- Struktur wajah
- Mata, hidung, dan bibir
- Warna kulit
- Riasan alami
- Estetika mode yang minimal dan tenang
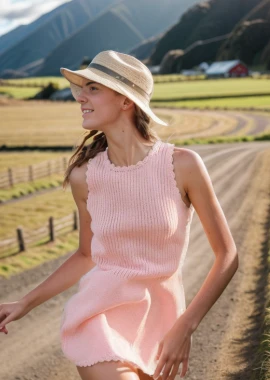
| Referensi Model Dewasa — Gambar 2 |
|---|
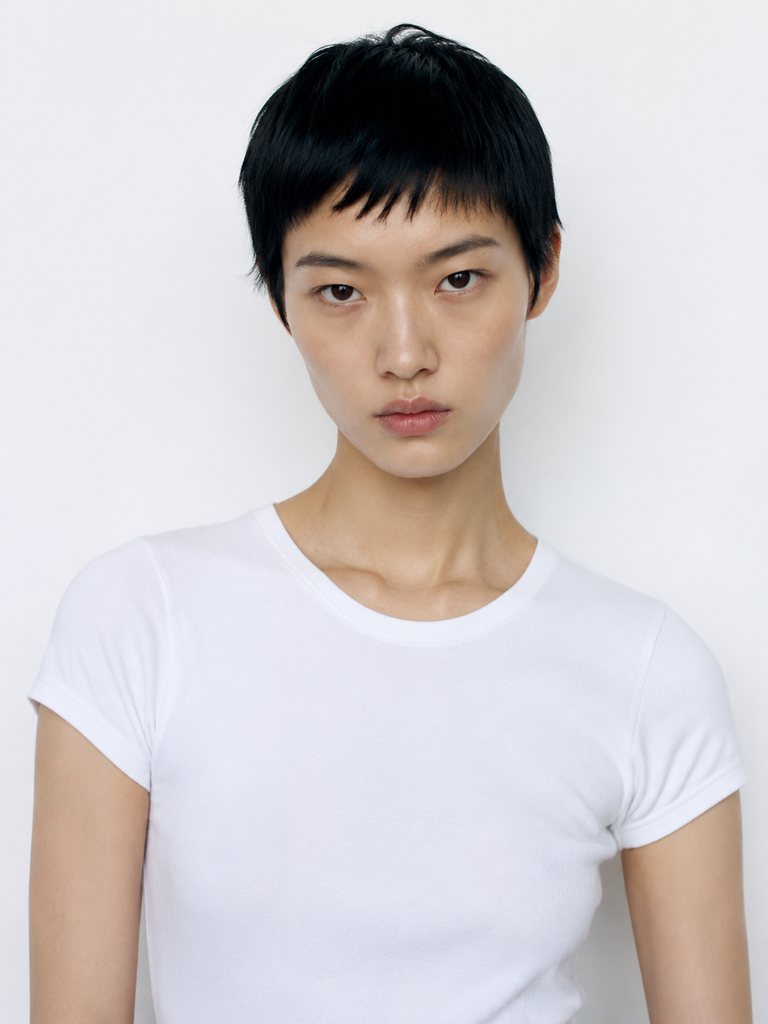 |
| Gambar 2 menyediakan identitas wajah model dewasa, gaya rambut pendek, warna kulit, dan penampilan keseluruhannya. |
Karena referensi hanya menampilkan tubuh bagian atas model, AI harus menyimpulkan tubuh yang tidak terlihat, pose seluruh tubuh, dan kecocokan pakaian.
Karena itu, hasilnya harus diperlakukan sebagai komposit AI kreatif, bukan representasi akurat dari tubuh orang asli atau pakaian sebenarnya.
Langkah 3: Unggah Referensi Latar Belakang
Gambar 3 mengontrol lingkungan dan komposisi dasar.
Informasi visual yang berguna mencakup:
- Dinding eksterior pucat
- Pintu kayu gelap
- Anak tangga batu abu-abu
- Pembingkaian vertikal seluruh tubuh
- Penempatan subjek di samping dinding
- Cahaya siang alami yang lembut
- Suasana gaya jalanan yang bersahaja
| Referensi Latar Belakang — Gambar 3 |
|---|
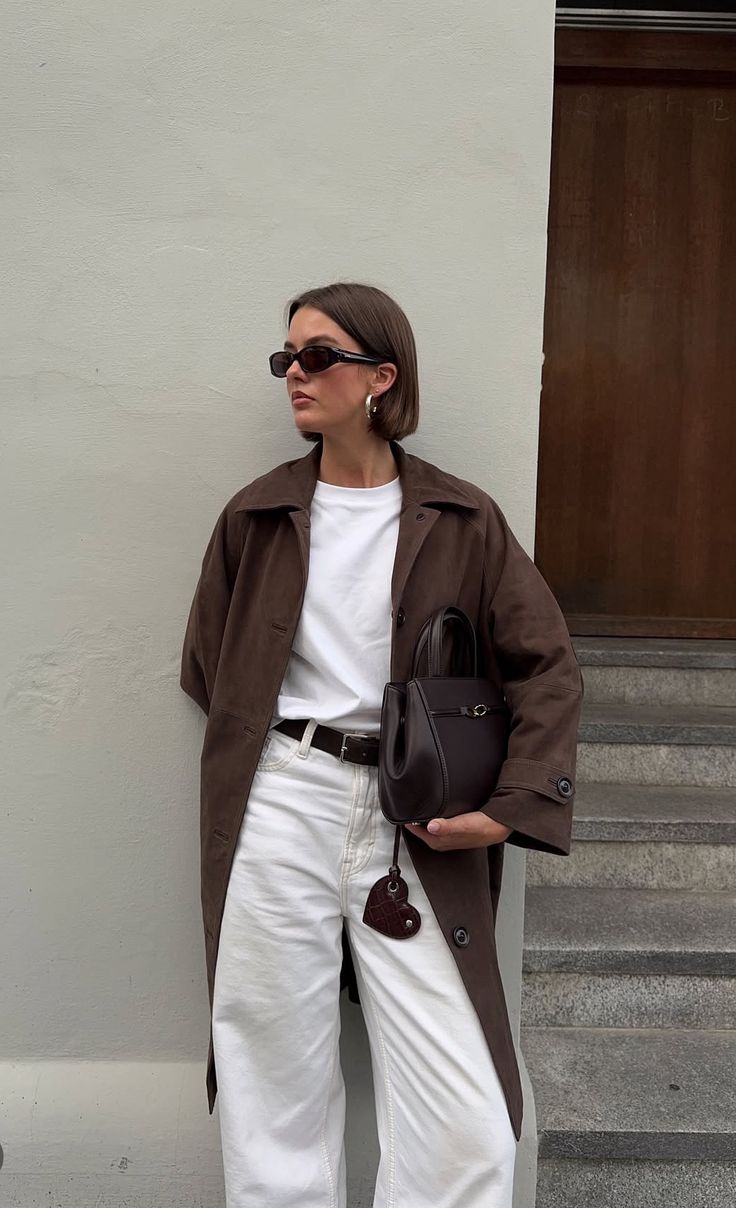 |
| Gambar 3 menyediakan latar belakang arsitektural, komposisi kamera, cahaya alami, dan penempatan subjek. |
Orang yang sudah terlihat di Gambar 3 tidak boleh menjadi model akhir.
Wajah, outfit, kacamata hitam, anting, tas tangan, dan detail pribadinya yang lain harus diabaikan kecuali jika memang diminta secara sengaja.
Langkah 4: Masukkan Prompt Tiga Gambar
Versi prompt paling singkat menjelaskan hubungan antara ketiga referensi.
Prompt Sederhana
Model pada Gambar 2 mengenakan pakaian dari Gambar 1 dan berdiri dengan latar belakang Gambar 3.
Ini menyampaikan tujuan dasar, tetapi menyerahkan beberapa keputusan kepada model:
- Detail wajah mana yang harus berasal dari Gambar 2?
- Detail pakaian mana yang harus dipertahankan dari Gambar 1?
- Apakah Gambar 3 hanya mengontrol lingkungan?
- Apakah aksesori dari Gambar 3 harus disalin?
- Bagian komposisi mana yang boleh berubah?
Prompt yang lebih terstruktur memberi batasan yang lebih jelas kepada Pengganti Pakaian AI.
Prompt Siap Salin
Gunakan Gambar 1 sebagai referensi pakaian, Gambar 2 sebagai referensi identitas model dewasa, dan Gambar 3 sebagai referensi latar belakang dan komposisi.

Buat foto gaya jalanan vertikal seluruh tubuh yang menampilkan model dewasa dari Gambar 2 mengenakan outfit lengkap dari Gambar 1 dan berdiri dalam latar arsitektural dari Gambar 3.

Pertahankan gaya rambut hitam pendek, fitur wajah yang mudah dikenali, warna kulit, dan proporsi alami model dari Gambar 2.

Pertahankan mantel panjang abu-abu arang, atasan hitam, celana lipit longgar berukuran besar berwarna abu-abu tua, sepatu kets perak, layering pakaian, dan siluet longgar dari Gambar 1.

Pertahankan dinding eksterior pucat, pintu kayu gelap, anak tangga batu, cahaya siang alami, perspektif kamera, dan penempatan subjek dari Gambar 3.

Gunakan Gambar 3 hanya untuk lingkungan dan komposisi. Jangan salin orang asli, pakaian, kacamata hitam, anting, tas tangan, atau aksesori pribadi lainnya dari Gambar 3.

Pertahankan hasil yang fotorealistis, dengan lipatan kain realistis, tangan dan kaki yang akurat, bayangan kontak alami, dan proporsi tubuh yang koheren.

Jangan tambahkan logo, teks, tanda air, pakaian tambahan, aksesori yang tidak terkait, atau detail desain baru.
Versi ini menetapkan satu peran yang jelas untuk setiap gambar:
- Gambar 1 mengontrol pakaian
- Gambar 2 mengontrol model
- Gambar 3 mengontrol latar belakang dan komposisi
Versi ini juga mencegah kacamata hitam, perhiasan, tas tangan, dan pakaian asli dalam referensi lokasi tersalin secara tidak sengaja.
Langkah 5: Hasilkan Gambar Pengganti Pakaian AI
Buka WeShop AI GPT Image dan tambahkan referensi dalam urutan yang sama seperti yang digunakan oleh prompt:
- Unggah Gambar 1 sebagai referensi pakaian.
- Unggah Gambar 2 sebagai referensi model dewasa.
- Unggah Gambar 3 sebagai referensi latar belakang.
- Tempelkan prompt tiga gambar.
- Hasilkan gambar vertikal seluruh tubuh.
Ketersediaan fitur dapat bervariasi, jadi ikuti status dan kontrol terkini yang ditampilkan pada halaman alat.
Anda dapat langsung mencobanya menggunakan alat di sebelah kanan.
Jika hasil pertama salah mewarisi kacamata hitam, perhiasan, tas tangan, atau gaya lain dari Gambar 3, lanjutkan dengan koreksi terfokus alih-alih menulis ulang seluruh adegan.
Pertahankan model, outfit, pose, latar belakang, pencahayaan, dan komposisi saat ini tanpa perubahan.

Hapus kacamata hitam, anting, tas tangan, dan aksesori lain yang disalin dari Gambar 3.

Wajah dan gaya rambut model harus tetap mengikuti Gambar 2, sementara outfit lengkap harus tetap mengikuti Gambar 1.
Instruksi lanjutan ini mengidentifikasi elemen yang tidak diinginkan sekaligus melindungi bagian yang sudah benar.
Langkah 6: Tinjau Hasil yang Dihasilkan
Gambar akhir menggabungkan informasi dari ketiga referensi.
| Hasil Buatan AI — Gambar 4 |
|---|
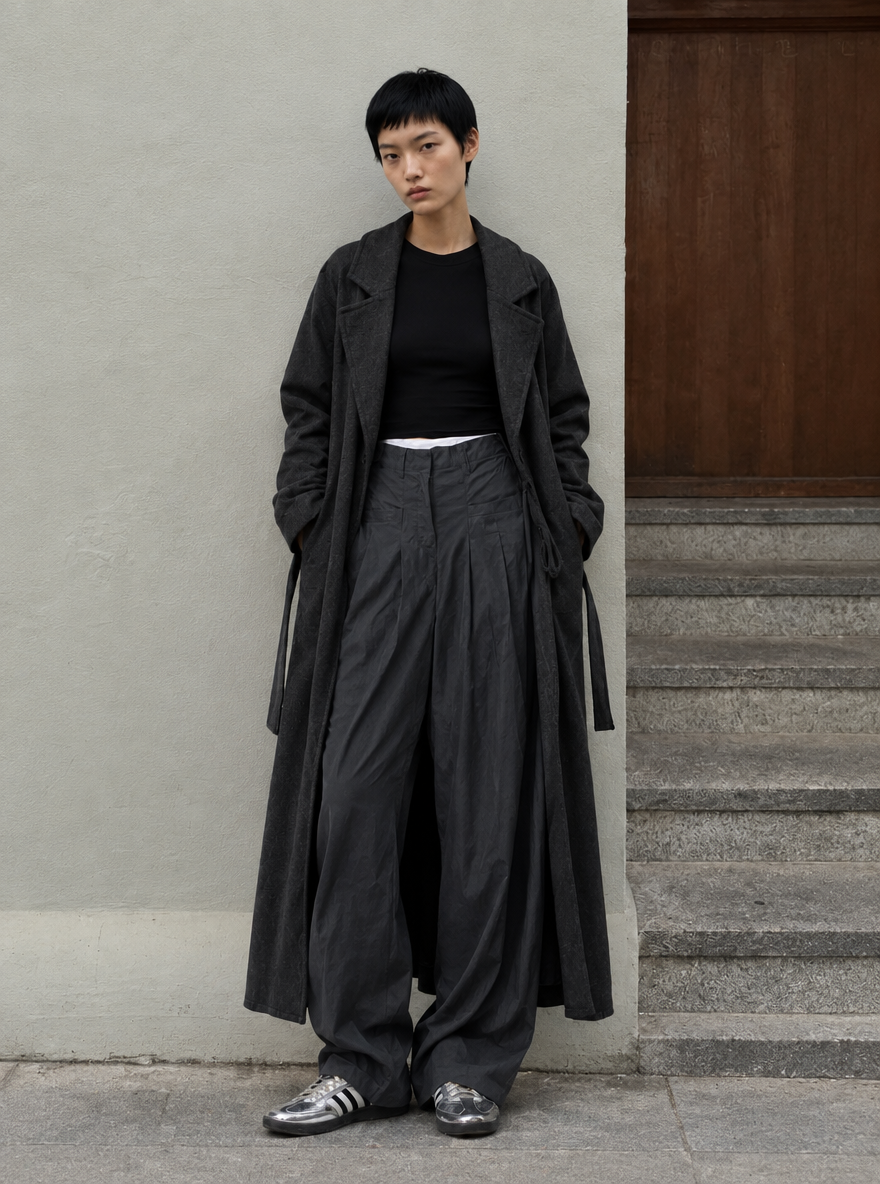 |
| Hasil yang dihasilkan menggabungkan outfit dari Gambar 1, identitas model dewasa dari Gambar 2, dan latar arsitektural dari Gambar 3. |
Gambar yang selesai mempertahankan beberapa elemen yang mudah dikenali:
- Gaya rambut hitam pendek dan penampilan wajah utama berasal dari Gambar 2.
- Mantel abu-abu arang, atasan hitam, celana longgar berukuran besar, dan sepatu kets perak berasal dari Gambar 1.
- Dinding pucat, pintu kayu, anak tangga batu, dan posisi subjek berasal dari Gambar 3.
- Komposisi akhir tetap berupa foto gaya jalanan vertikal seluruh tubuh.
Hasil ini juga menunjukkan masalah umum dalam pembuatan gambar dengan beberapa referensi: referensi lokasi dapat memengaruhi lebih dari sekadar latar belakang.
Aksesori seperti kacamata hitam dapat terbawa dari Gambar 3 bahkan ketika model dan pakaian yang dituju berasal dari gambar berbeda. Jika aksesori bukan bagian dari gaya target, kecualikan secara eksplisit dalam prompt utama atau hapus melalui pengeditan kedua yang terfokus.
Mengapa “Ganti Pakaian” Tidak Cukup Spesifik
Instruksi dasar seperti “ganti pakaian” memaksa model gambar untuk membuat terlalu banyak keputusan.
Model harus menebak:
- Outfit mana yang akan digunakan
- Orang mana yang harus dipertahankan
- Di mana orang tersebut harus berdiri
- Seperti apa lingkungan akhir seharusnya
- Apakah aksesori harus tetap ada
- Detail visual mana yang boleh didesain ulang
Alur kerja tiga referensi memisahkan keputusan-keputusan ini.
Gambar pakaian mendefinisikan produk mode. Gambar model mendefinisikan orangnya. Gambar latar belakang mendefinisikan lokasi dan komposisi. Prompt kemudian menjelaskan bagaimana referensi tersebut harus bekerja bersama.
Pendekatan ini dapat mendukung:
- Gambar produk mode
- Visual pakaian Shopify
- Konsep lookbook
- Konten outfit media sosial
- Eksperimen model dan lokasi
- Konsep mode praproduksi
- Draf kampanye ecommerce
Untuk gambar penjualan, bandingkan secara manual pakaian yang dihasilkan dengan produk asli. Periksa panjang, warna, bahan, konstruksi, penutup, dan aksesori sebelum menampilkan gambar tersebut sebagai representasi produk.
Ubah Tiga Referensi Menjadi Satu Gambar Mode yang Terkontrol
Prompt Pengganti Pakaian AI yang efektif menjawab tiga pertanyaan: siapa yang mengenakan outfit, apa yang mereka kenakan, dan di mana foto tersebut diambil?
Gambar 1, Gambar 2, dan Gambar 3 menjawab pertanyaan tersebut secara terpisah. GPT Image 2.5 kemudian menggabungkannya menjadi satu visual mode, sementara prompt menentukan detail mana yang harus tetap terisolasi.
Pembagian tanggung jawab ini mengubah tiga gambar referensi yang tidak terkait menjadi alur kerja konten mode yang lebih terkontrol dan dapat digunakan kembali.