












Corto cómico con Kling 4.0: edición de una pasada vs. plano a plano
Compara cuatro videos cómicos de IA de 30 segundos creados con Kling 4.0 y Seedream 5.5: generación de una pasada frente a edición plano a plano, en vertical y horizontal.
Un estudiante culpa al perro por sus deberes perdidos. Entra un ganso llevando el cuaderno. «También se comió al perro», explica el estudiante. La profesora evalúa las pruebas, le da la clase al ganso y se sienta a tomar apuntes.
Creamos este corto cómico de IA de 30 segundos con Kling 4.0 Reference, usando imágenes de Seedream 5.5 como referencias. Un flujo de trabajo generó el video completo en una sola solicitud. El otro generó seis clips independientes y los montó en una edición. Ambos tienen una versión horizontal y otra vertical, lo que te ofrece cuatro videos terminados para comparar.
Mira la misma comedia de aula creada de dos formas
One-pass · Landscape
Shot-by-shot · Landscape
One-pass · Portrait
Shot-by-shot · Portrait
Los cuatro videos terminados duran 30 segundos, con diálogos en inglés y subtítulos en chino e inglés. Las exportaciones horizontales originales son de 1920 × 1080; las verticales son de 1080 × 1920, a 24 fps. Los reproductores del artículo utilizan copias de reproducción de la biblioteca multimedia a 854 × 480 y 480 × 854 respectivamente, conservando la duración de 30 segundos, la frecuencia de fotogramas y el audio. Las personas son adultos ficticios en un aula rusa para adultos. Las imágenes y los diálogos originales fueron generados por IA; los subtítulos y el acabado se añadieron posteriormente.
| Decisión de producción | Generación de una pasada | Generación y edición plano a plano |
|---|---|---|
| Solicitudes de video por formato | Una solicitud de 30 segundos | Seis solicitudes de 6 segundos |
| ¿Quién determina los cortes internos? | El modelo interpreta toda la línea de tiempo | El editor selecciona rangos de origen y puntos de corte |
| Preparación de imágenes | Imagen maestra del aula, tres fotos de escena, tres mapas de posicionamiento | Recursos compartidos más una foto y un mapa independientes de la entrega de la tiza |
| Acabado utilizado aquí | Subtítulos, ajuste de sonoridad; discurso repetido eliminado en vertical | Montaje, recorte según el diálogo, reencuadre seleccionado, ajuste de sonoridad y subtítulos |
| Principal contrapartida | Menor control sobre el momento exacto de cada acción | Más comprobaciones de continuidad entre clips generados por separado |
Una pasada no significa una sola toma continua de cámara. El video generado puede contener cortes. Del mismo modo, la edición plano a plano implica cortar clips generados, con control de la edición a nivel de fotograma; no generamos cada fotograma individual como una imagen independiente.
Crea las referencias antes de pedir movimiento
La historia necesita tres sujetos reconocibles: Elena, la profesora con gafas de lectura rojas y cárdigan color carbón; Misha, un estudiante adulto con jersey crema; y un ganso blanco común. Una imagen maestra del aula estableció su apariencia junto a la pizarra verde, los pupitres de madera y la luz de la ventana.
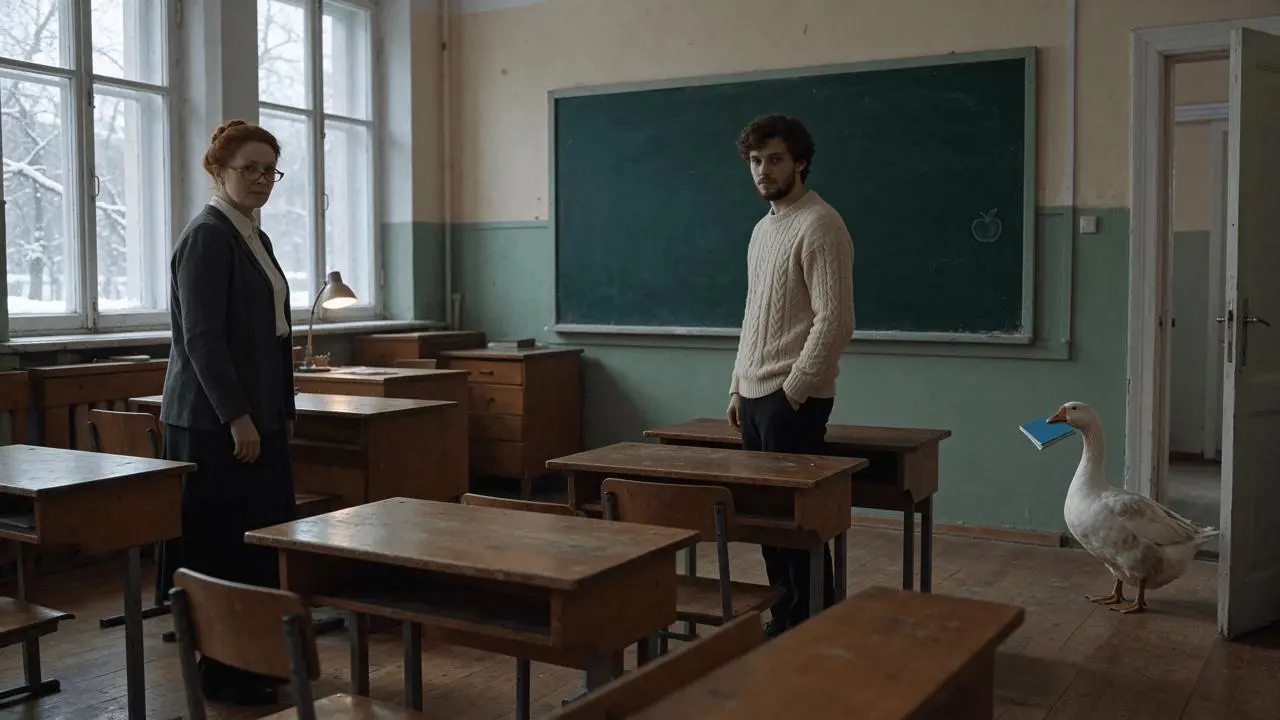
Usamos Seedream 5.5 mediante WeShop CLI para preparar esa imagen maestra y luego las fotografías clave de las escenas y los mapas de posicionamiento. Ambos flujos de trabajo de video reutilizaron esta base visual. El proyecto utilizó una imagen compartida del aula como referencia de identidad; no creó primero giros de personaje independientes ni hojas faciales separadas.
Para cada relación de aspecto, prepara tres configuraciones fotográficas: la revisión de deberes, la llegada del ganso con un cuaderno azul y el ganso enseñando mientras ambos humanos toman apuntes. Trata estas escenas como momentos independientes de una misma historia.
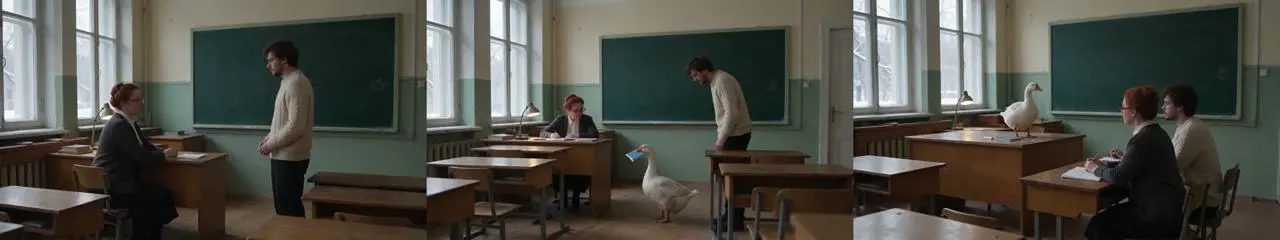
Después, crea un mapa de posicionamiento simplificado que corresponda a cada configuración. Conserva la vista de cámara, el recorte, el tamaño relativo, la posición, la dirección de la mirada y la oclusión. Utiliza contornos finos de colores distintos para identificar a los sujetos, dejando la apariencia y la iluminación a cargo de las fotos.
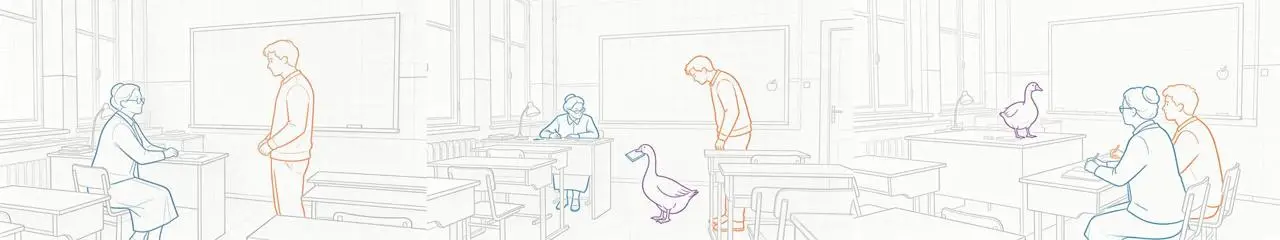
En nuestros prompts, el azul identificaba a Elena, el naranja a Misha y el morado al ganso. Esos colores solo identificaban a los sujetos en los diagramas. El vestuario real procedía de las referencias fotográficas. Las fotos se adjuntaron antes que los mapas, con el papel de cada imagen asignado explícitamente en el prompt. Son decisiones de producción probadas en este ejemplo, no una garantía de posicionamiento exacto.
Ruta 1: Genera la película completa de 30 segundos en una pasada
Abre Kling en WeShop y selecciona Kling 4.0 Reference. Para reproducir este caso, usa 30s, 1080p, cantidad 1, con 16:9 para horizontal o 9:16 para vertical. Estas son las configuraciones registradas en nuestras solicitudes de generación; consulta la referencia de la API de WeShop para conocer los detalles actuales de operación de CLI.
Adjunta siete imágenes en orden: la imagen maestra, las tres fotos de escena y los tres mapas correspondientes. Usa las imágenes preparadas para el formato seleccionado. Los dos formatos se generaron por separado, con sus propias composiciones de escena y mapas.
Escribe la historia completa en un solo prompt. Asigna primero las referencias y después indica el orden de las acciones, el diálogo exacto, las tareas de interpretación y el sonido. La línea de tiempo compacta siguiente muestra la estructura solicitada, no un registro medido de cada corte en el resultado:
| Intervalo solicitado | Acción de la historia |
|---|---|
| 0–9s | La profesora pide los deberes; el estudiante culpa al perro; una pausa desvía la atención |
| 9–18s | Llega el ganso con el cuaderno; la profesora lo identifica; el estudiante exagera su excusa |
| 18–25s | La profesora evalúa la interrupción y transfiere la autoridad docente |
| 25–30s | El ganso enseña; ambos humanos toman apuntes; el estudiante intenta hacer una pregunta |
El caso reutilizable contiene el prompt original completo y sus siete entradas de referencia. Este es un extracto de las instrucciones de interpretación:
«¿Dónde están tus deberes?» — exige responsabilidad y comprueba su disposición a responder. «Eso es un ganso». — dale la oportunidad de corregir su historia. «Bien. Tú enseñas». — da responsabilidad al ganso y comprueba si la acepta.
La profesora intenta mantener la clase en marcha. El estudiante intenta que su excusa sobreviva a las nuevas pruebas. El ganso busca atención y ocupa la posición docente. Dar a cada sujeto una tarea hace que la situación absurda sea comprensible sin pedir a los actores que subrayen el chiste.
Inspecciona el resultado antes de añadir subtítulos
Comprueba las líneas habladas, la visibilidad del cuaderno, las posiciones en el aula y la inversión final de roles. Revisa si aparecen en el metraje contornos de colores o estilo de diagrama. Los resultados muestreados conservaron imágenes fotográficas y ambas versiones de una pasada llegaron al final en que el ganso enseña, pero los tiempos y las acciones solicitados no se siguieron exactamente.
El original vertical repitió «Bien. Tú enseñas». Durante el acabado, la segunda aparición en 21.65–24.65s se sustituyó por sonido ambiente copiado de 6.4–9.4s del mismo video. La imagen se mantuvo intacta. Ambos formatos recibieron subtítulos alineados con el habla generada y una pasada de sonoridad. Los reproductores anteriores muestran estas versiones terminadas, en lugar de resultados brutos sin modificar.
Ruta 2: Genera seis planos y controla la edición final
Para el segundo flujo de trabajo, añadimos una foto de referencia y un mapa de posicionamiento específicos de la profesora entregando la autoridad en el pupitre. Esto dio a la transición su propia configuración visual, en lugar de dejar toda la entrega al prompt de la película completa.
Cada plano utilizó Kling 4.0 Reference, 6s, 1080p, cantidad 1. Los conjuntos horizontal y vertical se generaron de forma independiente. Cada solicitud incluía la imagen maestra, la foto de escena correspondiente y su mapa de posicionamiento, con las instrucciones necesarias de identidad, ubicación, diálogo y sonido repetidas íntegramente.
| Plano | Lo que aporta | Duración final conservada |
|---|---|---|
| 1 | Pregunta sobre los deberes y primera excusa | 6s |
| 2 | Ganso llevando el cuaderno: un breve inserto de evidencia | 1s |
| 3 | «Eso es un ganso». / «También se comió al perro». | 6s |
| 4 | La profesora delega la clase al ganso | 6s |
| 5 | El ganso enseña; ambos humanos toman apuntes | 5s |
| 6 | El estudiante levanta la mano, recibe un graznido y vuelve a escribir | 6s |
El plan inicial era conservar cinco segundos de cada fuente de seis segundos, dejando medio segundo en cada extremo para recortar. El diálogo real no encajaba en esas ventanas previstas. Cambiamos la edición a 6 + 1 + 6 + 6 + 5 + 6 = 30 segundos, conservando las líneas habladas completas.
El cuaderno también reveló un problema de continuidad: más adelante en la fuente de llegada del ganso, ya no coincidía con el estado requerido por el siguiente plano. Conservamos el primer segundo como inserto. Esto hizo comprensible la llegada del cuaderno y evitó la parte final inconsistente del clip. Fue una solución editorial, no una reparación de la acción generada original.
La edición final aplicó recortes fijos al tercer y sexto plano para variar el encuadre, normalizó la sonoridad y añadió subtítulos bilingües. Se conservaron los diálogos generados por separado; repetir una descripción de voz en los prompts no debe interpretarse como prueba de voces perfectamente idénticas entre clips.
Compón vertical y horizontal como escenas independientes
En horizontal, la sala ofrece mayor separación horizontal entre la profesora, el estudiante y el ganso. El formato vertical necesita una composición que siga mostrando su relación, el cuaderno y el pupitre. Por eso este proyecto preparó escenas y mapas de referencia 9:16 distintos, y después generó el metraje vertical por separado.
Observa la entrada del cuaderno y el momento final de la mano levantada en ambos formatos. Revelan más sobre la puesta en escena y el ritmo cómico que comparar un único fotograma atractivo. El video vertical terminado no es simplemente un recorte central de la salida horizontal, aunque ciertos planos recibieron reencuadre adicional durante la edición.
Elige el flujo de trabajo según la acción que debas conservar
Usa la ruta de una pasada cuando quieras comprobar si el chiste completo funciona y puedas aceptar que el modelo interprete los cortes internos. Aun así, debes revisar el habla, los objetos y el final, y después terminar el resultado.
Elige la ruta plano a plano cuando la entrega, la pausa de reacción o la pregunta final necesiten su propio tiempo de pantalla conservado. También te permite revisar un clip de origen manteniendo los demás, a cambio de comprobar la continuidad y el sonido entre generaciones independientes.
Estos cuatro videos documentan un ejemplo de producción, no una referencia de tasa de éxito. Empieza con el caso completo de aula de 30 segundos, inspecciona lo que realmente conserva tu resultado y divide la escena en planos cuando una acción específica necesite más control.
Puedes probarlo directamente usando la herramienta de la derecha.