





Cambiador de ropa con IA: combina referencias de outfit, modelo y fondo
Aprende a crear una imagen de moda con IA controlada asignando referencias separadas de atuendo, modelo adulto y fondo, y usando después un prompt claro de tres imágenes.
Generador de imágenes con IA: cambiador de ropa con IA con referencias de atuendo, modelo y fondo mediante GPT Image 2.5
Una imagen decide qué lleva puesto el modelo. Una segunda imagen decide quién lo lleva. Una tercera imagen decide dónde tiene lugar la fotografía final.
En el resultado generado, el modelo de pelo corto lleva el abrigo color carbón, la parte superior negra, los pantalones oversize y las zapatillas plateadas de la referencia de ropa mientras está de pie frente a la pared clara y los escalones de piedra de la imagen de ubicación.
En lugar de pedirle a la IA que «cambie la ropa» y dejar que rediseñe toda la fotografía, este flujo de trabajo asigna a cada imagen de referencia una responsabilidad específica.
Este tutorial utiliza WeShop AI GPT Image como un Cambiador de ropa con IA para combinar una imagen de ropa, una foto de un modelo adulto y una referencia de fondo en una única imagen de moda.
Utiliza únicamente tus propias imágenes o fotografías de modelos adultos para las que tengas permiso de uso.
Lo que necesitas para este flujo de trabajo de cambiador de ropa con IA
Prepara tres imágenes de referencia:
- Una imagen de cuerpo entero que muestre el atuendo objetivo completo
- Una fotografía clara del modelo adulto
- Una imagen de ubicación que muestre el fondo y la composición deseados
Cada referencia controla una parte diferente de la imagen generada.
| Referencia | Controla | No debe controlar |
|---|---|---|
| Figura 1 | Ropa, calzado, capas y silueta | Identidad del modelo o fondo final |
| Figura 2 | Rostro, peinado, tono de piel e identidad | Ropa o ubicación |
| Figura 3 | Fondo, composición, iluminación y ubicación del sujeto | Identidad final del modelo o atuendo |
Esta separación es importante porque una referencia de fondo puede contener a otra persona, atuendo, bolso, gafas de sol o accesorios.
Si el prompt no define la función de cada imagen, esos detalles no deseados pueden aparecer en el resultado generado.
Paso 1: Sube la referencia de ropa
La Figura 1 es la referencia de ropa.
Establece el atuendo completo que debe aparecer en la imagen final:
- Abrigo largo color carbón
- Parte superior negra de cuello redondo
- Pantalones plisados oversize gris oscuro
- Zapatillas plateadas
- Silueta holgada de baja saturación
- Capas entre el abrigo, la parte superior y los pantalones
| Referencia de ropa — Figura 1 |
|---|
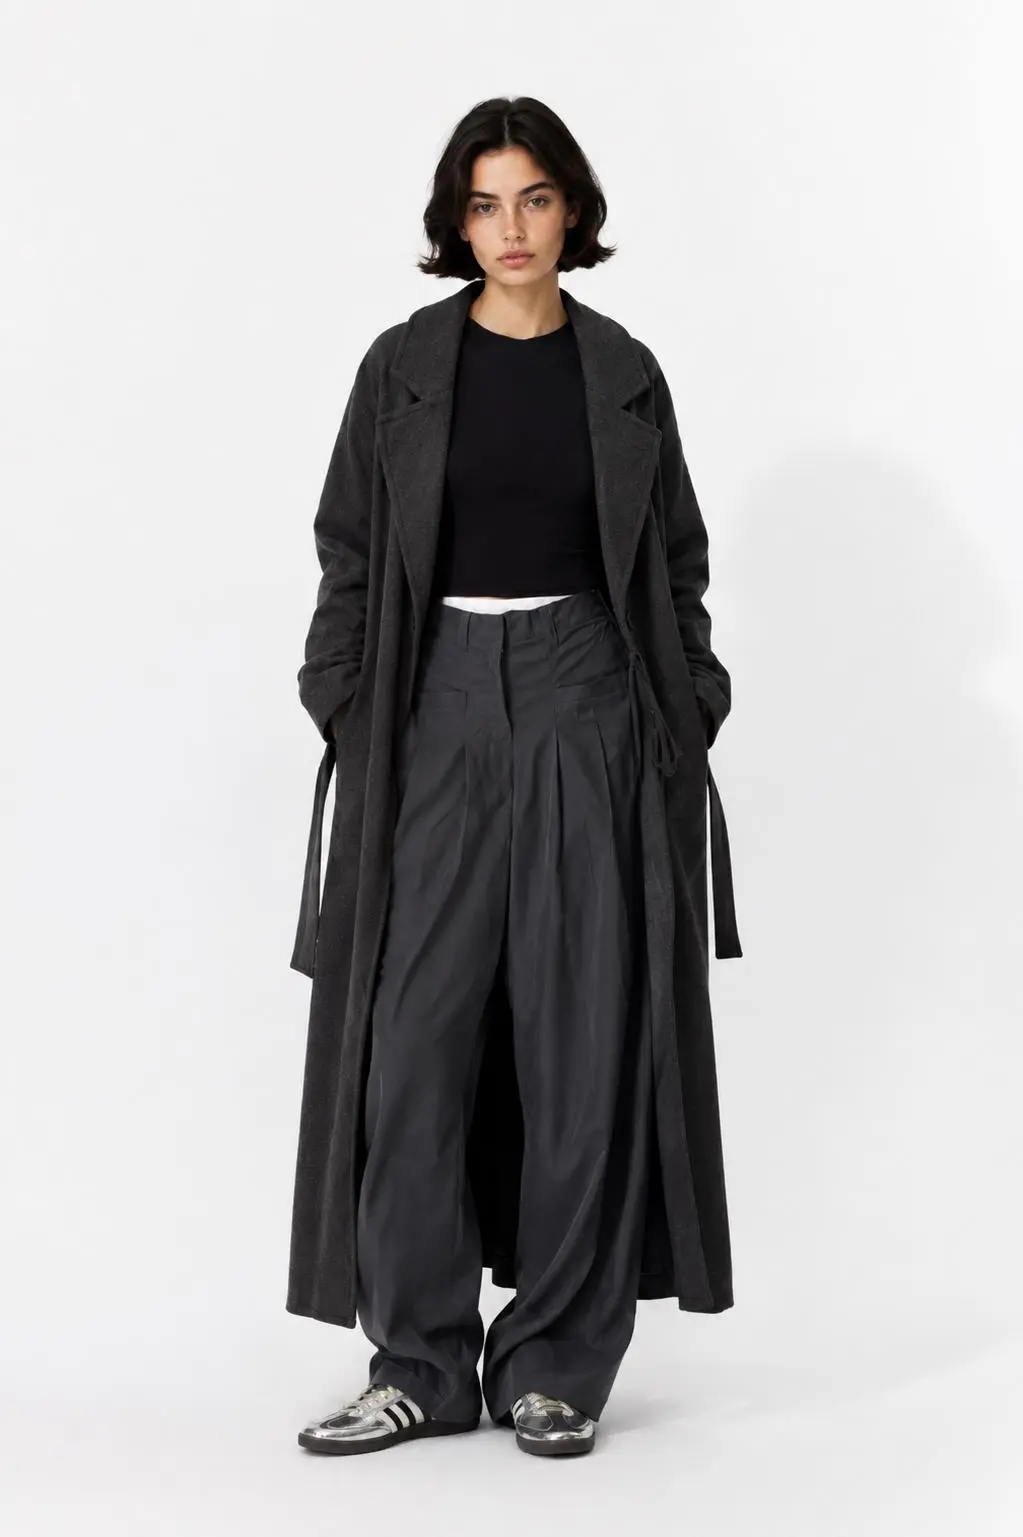 |
| La Figura 1 controla el atuendo, el calzado, las proporciones de las prendas y el estilo general. |
La persona de esta imagen no es la referencia de identidad. El rostro y el peinado del modelo final deben provenir de la Figura 2.
Esta distinción evita que el cambiador de ropa con IA simplemente reproduzca la fotografía de moda original.
Paso 2: Sube la referencia del modelo adulto
La Figura 2 es la referencia de identidad.
Proporciona las características visibles del modelo:
- Peinado corto negro
- Estructura facial
- Ojos, nariz y labios
- Tono de piel
- Maquillaje natural
- Estética de moda minimalista y sobria
| Referencia de modelo adulto — Figura 2 |
|---|
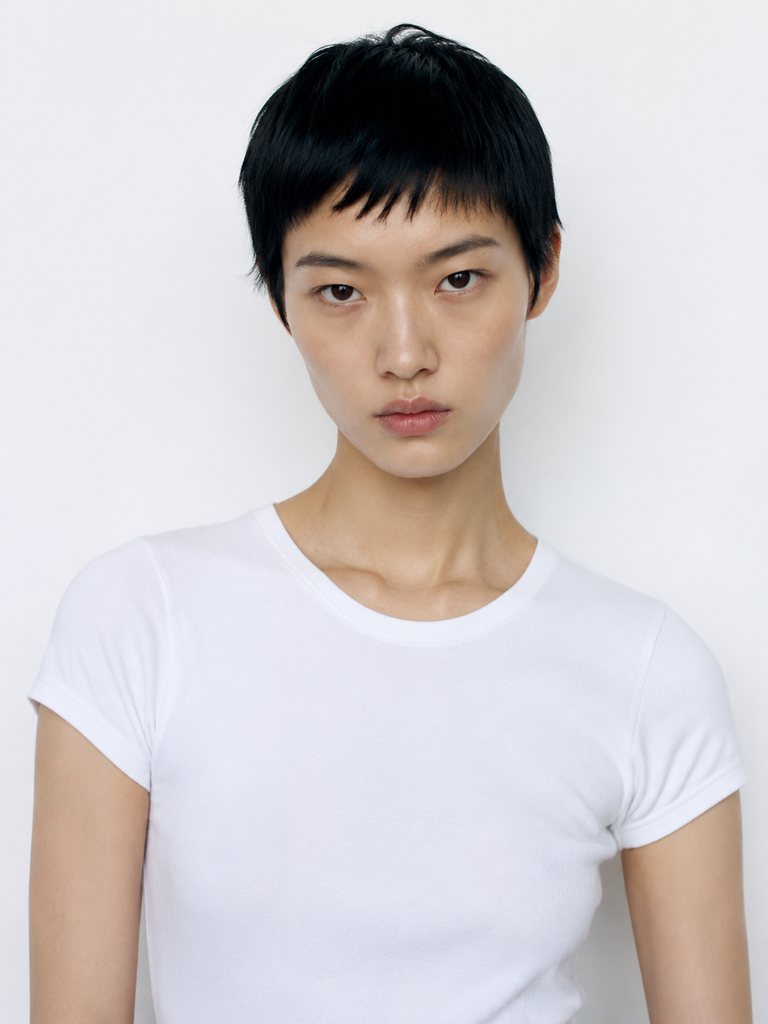 |
| La Figura 2 aporta la identidad facial del modelo adulto, el peinado corto, el tono de piel y la apariencia general. |
Como la referencia solo muestra la parte superior del cuerpo del modelo, la IA debe inferir el cuerpo que falta, la pose de cuerpo entero y el ajuste de la ropa.
Por lo tanto, el resultado debe considerarse una composición creativa de IA y no una representación precisa del cuerpo de la persona real ni de su ropa real.
Paso 3: Sube la referencia de fondo
La Figura 3 controla el entorno y la composición básica.
La información visual útil incluye:
- Pared exterior clara
- Entrada de madera oscura
- Escalones de piedra gris
- Encuadre vertical de cuerpo entero
- Ubicación del sujeto junto a la pared
- Luz diurna exterior suave
- Ambiente sobrio de estilo urbano
| Referencia de fondo — Figura 3 |
|---|
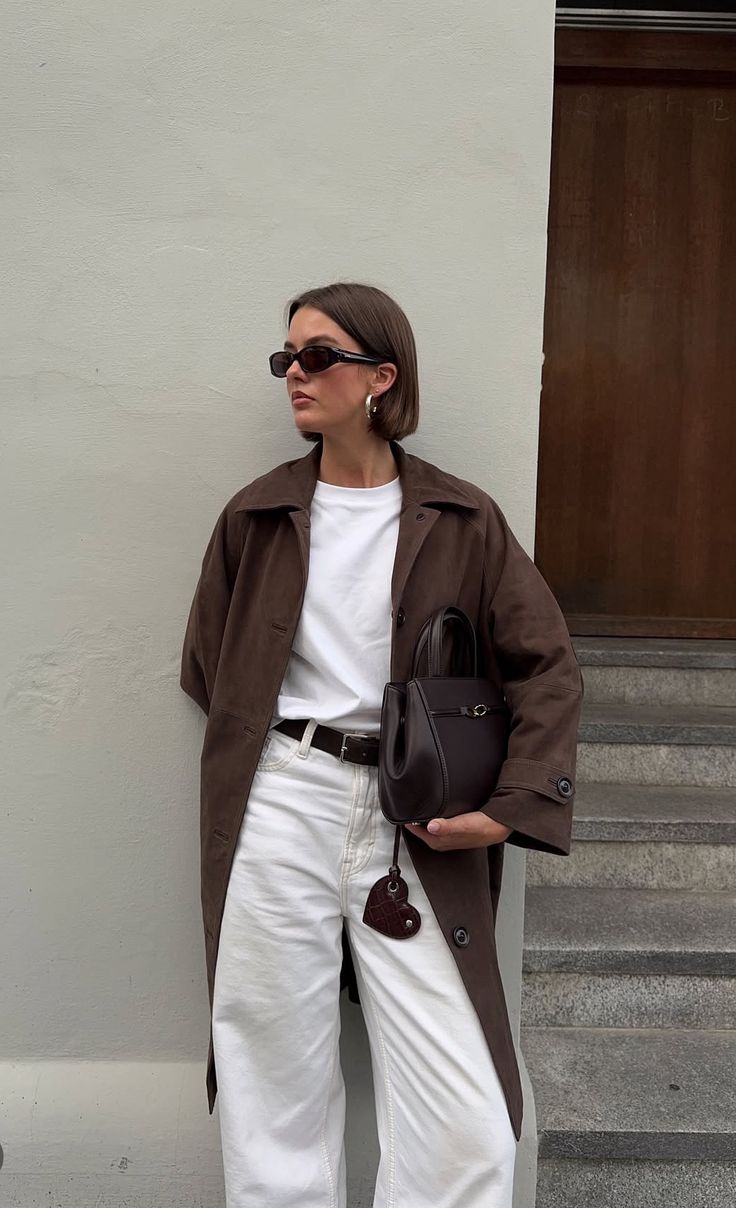 |
| La Figura 3 aporta el fondo arquitectónico, la composición de cámara, la luz natural y la ubicación del sujeto. |
La persona ya visible en la Figura 3 no debe convertirse en el modelo final.
Su rostro, atuendo, gafas de sol, pendientes, bolso y otros detalles personales deben ignorarse a menos que se soliciten intencionadamente.
Paso 4: Introduce el prompt de tres imágenes
La versión más corta del prompt describe la relación entre las tres referencias.
Prompt sencillo
El modelo de la Figura 2 lleva la ropa de la Figura 1 y está de pie frente al fondo de la Figura 3.
Esto comunica el objetivo básico, pero deja varias decisiones al modelo:
- ¿Qué detalles faciales deben provenir de la Figura 2?
- ¿Qué detalles de la ropa deben conservarse de la Figura 1?
- ¿La Figura 3 debe controlar solo el entorno?
- ¿Deben copiarse los accesorios de la Figura 3?
- ¿Qué partes de la composición pueden cambiar?
Un prompt más estructurado proporciona límites más claros al cambiador de ropa con IA.
Prompt listo para copiar
Usa la Figura 1 como referencia de ropa, la Figura 2 como referencia de identidad del modelo adulto y la Figura 3 como referencia de fondo y composición.

Crea una fotografía vertical de cuerpo entero de estilo urbano en la que el modelo adulto de la Figura 2 lleve el atuendo completo de la Figura 1 y esté de pie en el entorno arquitectónico de la Figura 3.

Conserva el peinado corto negro del modelo, los rasgos faciales reconocibles, el tono de piel y las proporciones naturales de la Figura 2.

Conserva el abrigo largo color carbón, la parte superior negra, los pantalones plisados oversize gris oscuro, las zapatillas plateadas, las capas de las prendas y la silueta holgada de la Figura 1.

Conserva la pared exterior clara, la entrada de madera oscura, los escalones de piedra, la luz diurna natural, la perspectiva de cámara y la ubicación del sujeto de la Figura 3.

Usa la Figura 3 únicamente para el entorno y la composición. No copies a la persona original, la ropa, las gafas de sol, los pendientes, el bolso ni otros accesorios personales de la Figura 3.

Mantén el resultado fotorrealista, con pliegues de tela realistas, manos y pies precisos, sombras de contacto naturales y proporciones corporales coherentes.

No añadas logotipos, texto, marcas de agua, prendas adicionales, accesorios no relacionados ni nuevos detalles de diseño.
Esta versión asigna una función clara a cada imagen:
- La Figura 1 controla la ropa
- La Figura 2 controla el modelo
- La Figura 3 controla el fondo y la composición
También evita que las gafas de sol, las joyas, el bolso y la ropa original de la referencia de ubicación se copien de forma involuntaria.
Paso 5: Genera la imagen con el cambiador de ropa con IA
Abre WeShop AI GPT Image y añade las referencias en el mismo orden utilizado por el prompt:
- Sube la Figura 1 como referencia de ropa.
- Sube la Figura 2 como referencia del modelo adulto.
- Sube la Figura 3 como referencia de fondo.
- Pega el prompt de tres imágenes.
- Genera el resultado vertical de cuerpo entero.
La disponibilidad de las funciones puede variar, así que sigue el estado y los controles actuales que aparecen en la página de la herramienta.
Puedes probarlo directamente usando la herramienta de la derecha.
Si el primer resultado hereda incorrectamente gafas de sol, joyas, un bolso u otros elementos de estilo de la Figura 3, continúa con una corrección específica en lugar de reescribir toda la escena.
Mantén sin cambios el modelo, atuendo, pose, fondo, iluminación y composición actuales.

Elimina las gafas de sol, los pendientes, el bolso y cualquier otro accesorio copiado de la Figura 3.

El rostro y el peinado del modelo deben seguir la Figura 2, mientras que el atuendo completo debe seguir la Figura 1.
Esta instrucción de seguimiento identifica los elementos no deseados mientras protege las partes que ya son correctas.
Paso 6: Revisa el resultado generado
La imagen final combina información de las tres referencias.
| Resultado generado por IA — Figura 4 |
|---|
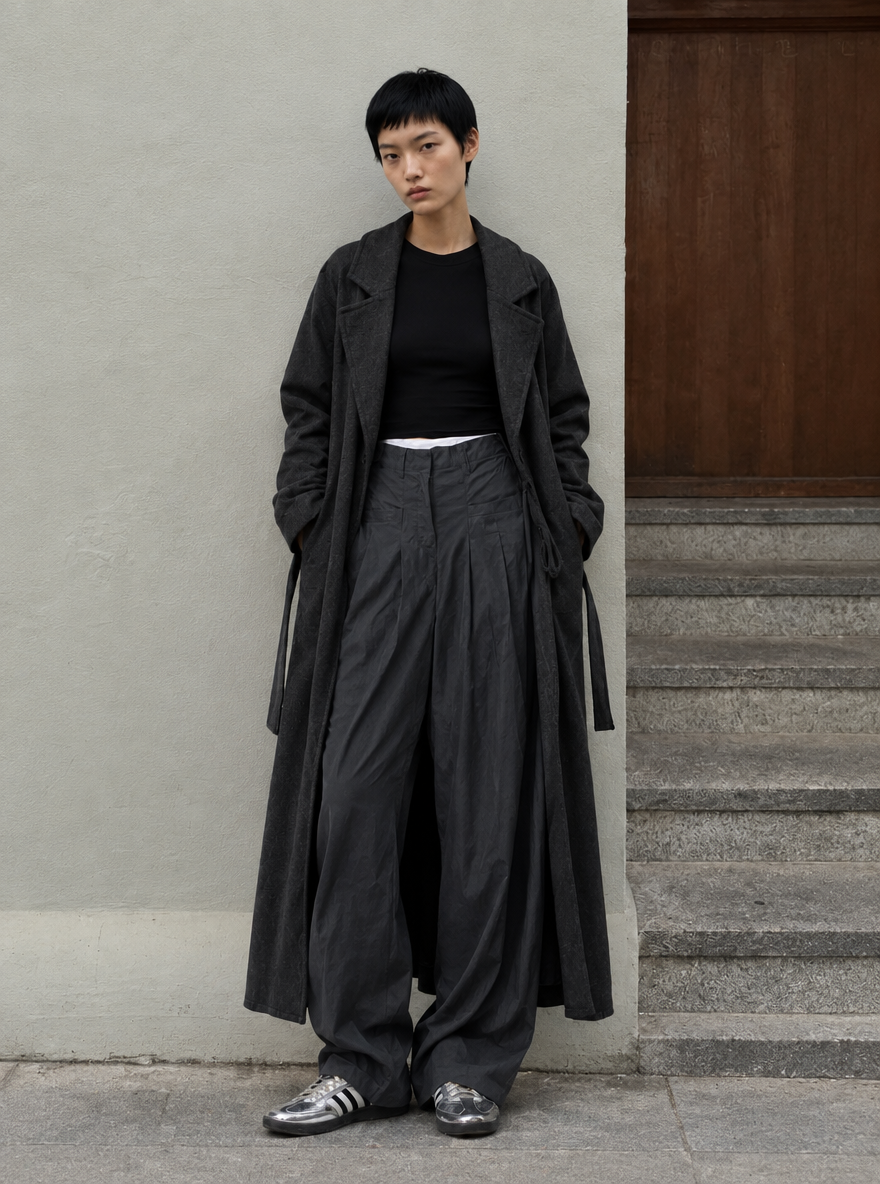 |
| El resultado generado combina el atuendo de la Figura 1, la identidad del modelo adulto de la Figura 2 y el entorno arquitectónico de la Figura 3. |
La imagen completada conserva varios elementos reconocibles:
- El peinado corto negro y la apariencia facial principal provienen de la Figura 2.
- El abrigo color carbón, la parte superior negra, los pantalones oversize y las zapatillas plateadas provienen de la Figura 1.
- La pared clara, la entrada de madera, los escalones de piedra y la posición del sujeto provienen de la Figura 3.
- La composición final sigue siendo una fotografía vertical de cuerpo entero de estilo urbano.
El resultado también demuestra un problema común de la generación de imágenes con múltiples referencias: una referencia de ubicación puede influir en algo más que el fondo.
Accesorios como las gafas de sol pueden trasladarse desde la Figura 3 incluso cuando el modelo y la ropa previstos provienen de imágenes diferentes. Si un accesorio no forma parte del estilo objetivo, exclúyelo explícitamente en el prompt principal o elimínalo mediante una segunda edición específica.
Por qué «cambiar la ropa» no es lo suficientemente específico
Una instrucción básica como «cambiar la ropa» obliga al modelo de imagen a tomar demasiadas decisiones.
Debe adivinar:
- Qué atuendo usar
- Qué persona conservar
- Dónde debe estar de pie la persona
- Cómo debe ser el entorno final
- Si los accesorios deben permanecer
- Qué detalles visuales pueden rediseñarse
El flujo de trabajo de tres referencias separa estas decisiones.
La imagen de ropa define el producto de moda. La imagen del modelo define a la persona. La imagen de fondo define la ubicación y la composición. Después, el prompt explica cómo deben funcionar juntas esas referencias.
Este enfoque puede servir para:
- Imágenes de productos de moda
- Imágenes de ropa para Shopify
- Conceptos de lookbook
- Contenido de atuendos para redes sociales
- Experimentos con modelos y ubicaciones
- Conceptos de preproducción de moda
- Borradores de campañas de ecommerce
Para imágenes de venta, compara manualmente la ropa generada con el producto real. Verifica su largo, color, material, confección, cierres y accesorios antes de presentar la imagen como una representación del producto.
Convierte tres referencias en una imagen de moda controlada
Un prompt eficaz para un cambiador de ropa con IA responde tres preguntas: quién lleva el atuendo, qué lleva puesto y dónde tiene lugar la fotografía.
La Figura 1, la Figura 2 y la Figura 3 responden a esas preguntas por separado. GPT Image 2.5 las combina después en una única imagen de moda, mientras que el prompt define qué detalles deben permanecer aislados.
Esta división de responsabilidades convierte tres imágenes de referencia no relacionadas en un flujo de trabajo de contenido de moda más controlado y reutilizable.
Crea una imagen con cambiador de ropa con IA usando WeShop AI GPT Image