





Qwen-Image-2.1: Прозрачност, редактиране с 10 референции и 2K изход
Разгледайте унифицирания 7B модел за изображения Qwen-Image-2.1 с вграден RGBA изход, до 10 референции, редактиране с маски и генериране в нативна 2K резолюция.
1. Qwen-Image-2.1 използва 7B модел както за генериране, така и за редактиране
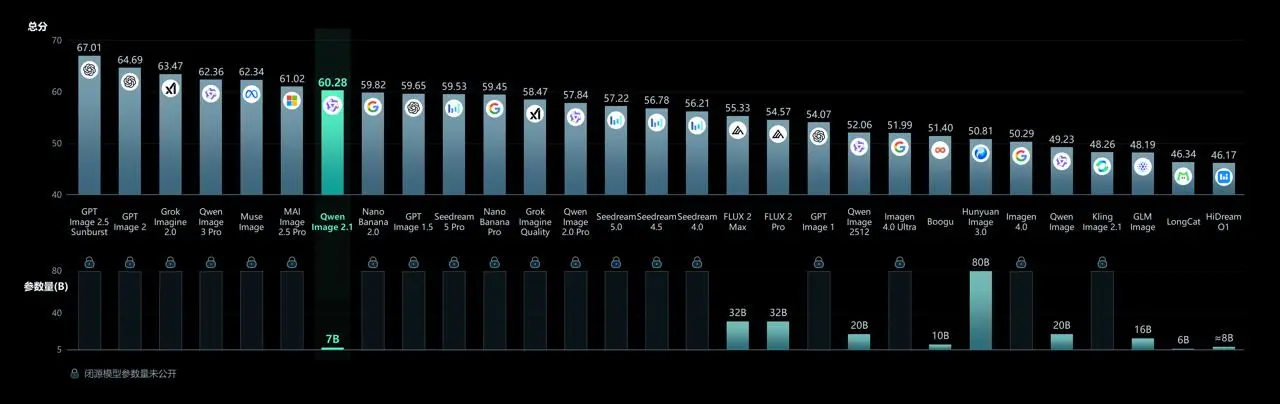
Qwen-Image-2.1 комбинира генериране на изображения от текст и редактиране на изображения в един моделeн процес. Компонентът му за визуално генериране използва 32-слойна Single-Stream DiT архитектура със 7B параметри. Qwen3-VL 8B кодира текста и условните изображения, а вниманието със смесена гранулярност и повторното използване на Prefix KV Cache намаляват повтарящите се изчисления.
Този дизайн е най-важен при редактиране на множество изображения. Моделът може да кешира референтните изображения и инструкциите за редактиране, вместо да обработва един и същ статичен контекст отново при всяка стъпка на премахване на шума. Това създава по-ефективна основа за задачи, включващи едновременно човек, дрехи, обувки, чанти или множество референции за интериорен дизайн.
2. Нативното генериране на прозрачни изображения вече е вградено
Често срещан работен процес е първо да се генерира стандартно изображение, а след това да се премахне фонът му. Вместо това Qwen-Image-2.1 може да генерира изображения с нативен Alpha канал, да редактира съществуващи прозрачни слоеве или да извлича избран обект от обикновена RGB снимка като RGBA ресурс.
Това прави възможността приложима не само за стикери и илюстрации. Изрязани продукти, хора, графични елементи и прозрачен текст могат да преминават директно към последващи работни процеси за оформление и композиране.
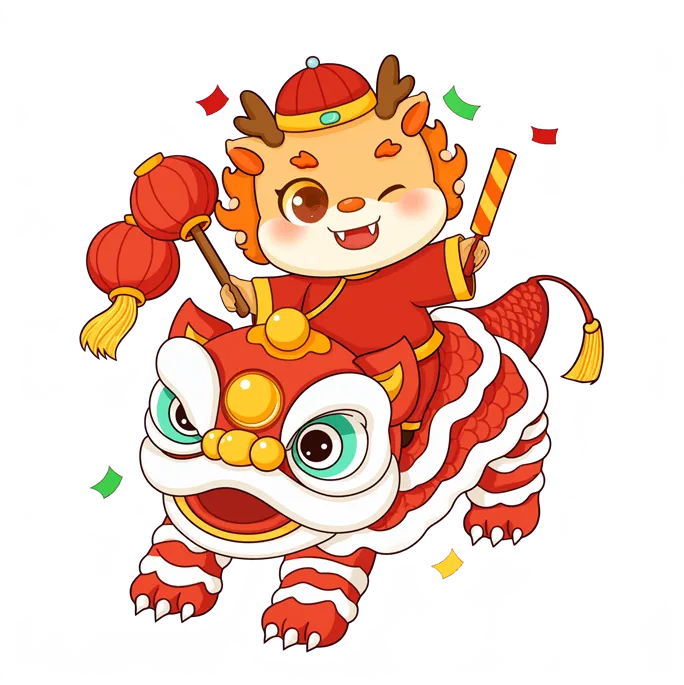
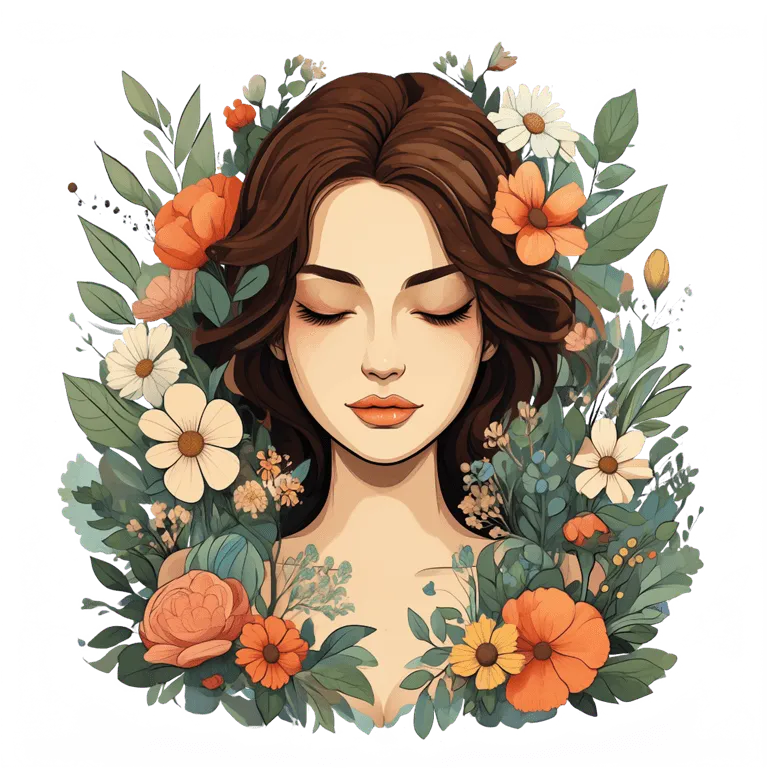
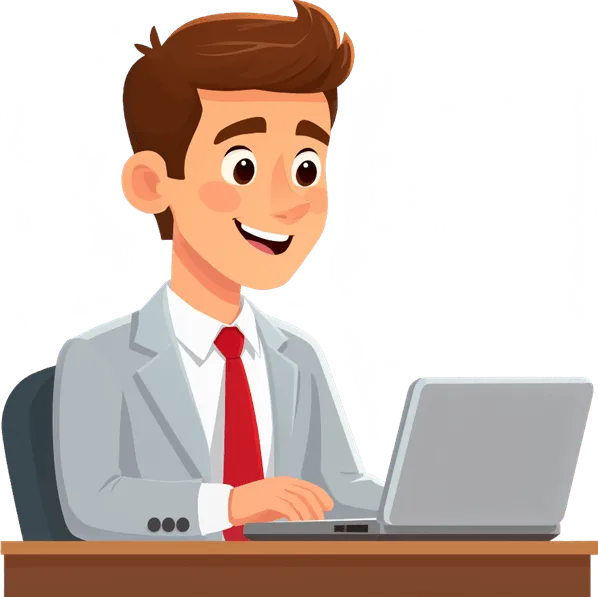
Qwen също така демонстрира редактиране на изражения и типография в прозрачни слоеве, както и извличане на обекти от реални снимки. Практическата промяна не е просто, че моделът може да премахва фон. Генерирането, редактирането, извличането и изходът на прозрачни ресурси вече са в един и същ модел.
3. До 10 референтни изображения поддържат по-сложни композиции
Qwen-Image-2.1 поддържа до 10 референтни изображения. Официалните демонстрации включват комбиниране на шест портрета в групова снимка, създаване на тоалет от пет отделни референции и проектиране на интериор от 10 изображения на мебели.
За екипите в електронната търговия и модата редактирането с множество референтни изображения може да постави модела, дрехата, обувките, чантата и референциите за стилизиране в една и съща задача. Работният процес вече не е ограничен до редактиране на едно изходно изображение наведнъж.
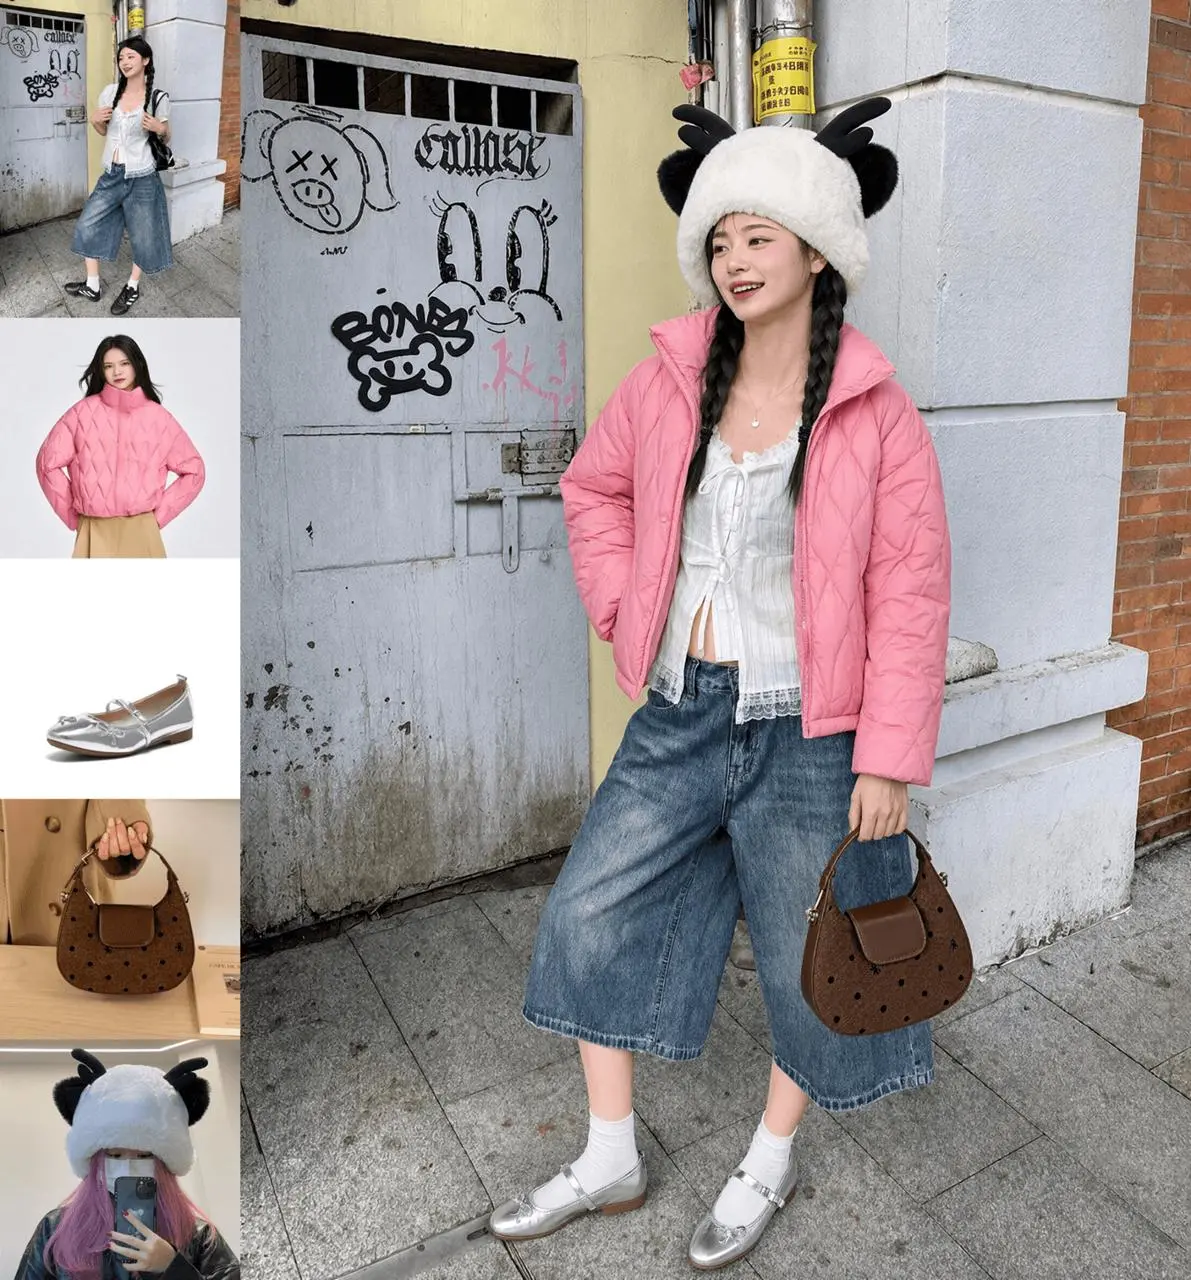
4. Кръгове, оцветени области и отделни маски могат да насочват локалните редакции
Локалното редактиране на изображения не зависи само от текст. Материалите на Qwen показват три начина за обозначаване на целева област:
- Начертайте кръгове с различни цветове около няколко области, които се нуждаят от отделни промени.
- Оцветете дадено място, за да кажете на модела къде да добави или замени съдържание.
- Подайте оригиналното изображение и отделна маска като два входа, като запазите изходните пиксели, които наслагвана анотация би скрила.
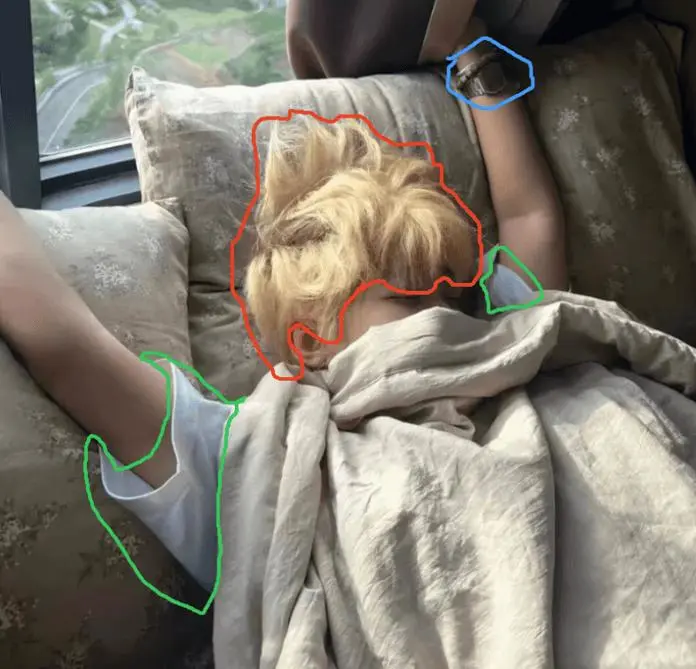
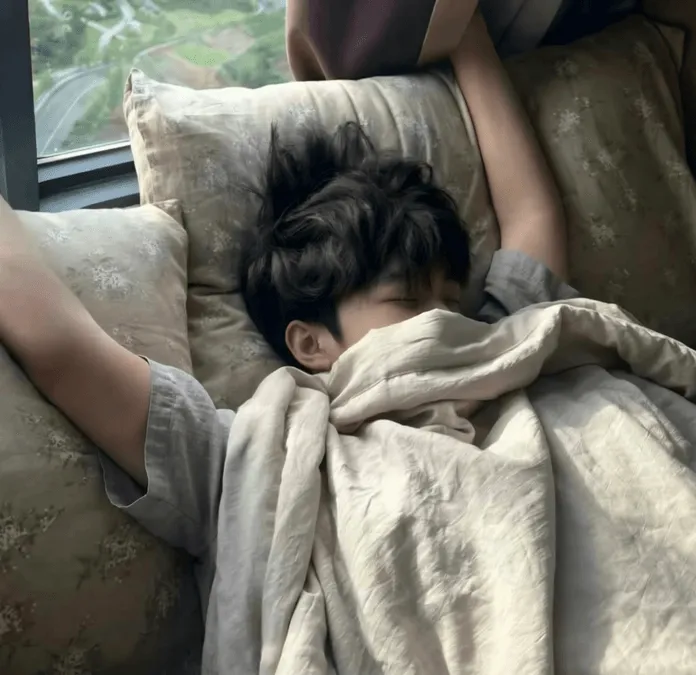
Тези входни данни са по-точни от описването в подкана на „обекта вляво“ или „елемента близо до върха“. Те също създават по-ясен метод за контрол при итеративни и последователни редакции.
5. Qwen акцентира върху вярното пресъздаване на портрети и продукти
Qwen посочва идентичността при портретите и последователността при продуктите като две основни области на подобрение. Редакциите на портрети са предназначени да запазват разпознаваемите черти на лицето, докато редакциите на продукти се фокусират върху запазването на типографията, текстурата и формата, когато артикулът бъде преместен в нова сцена.
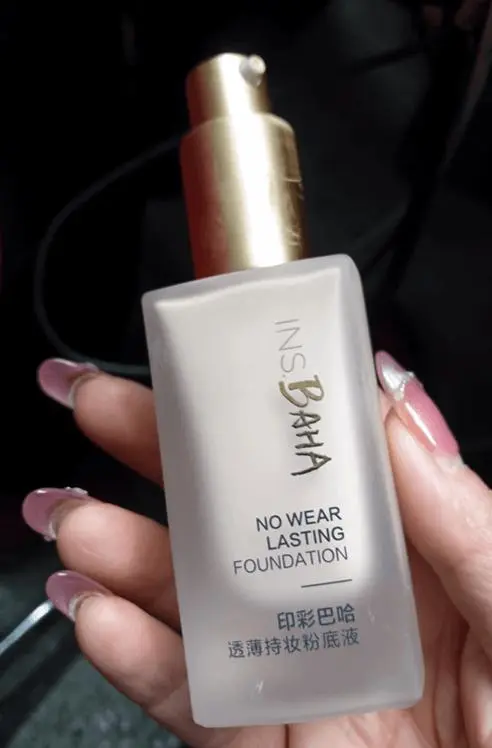
Тази възможност е особено релевантна за работни процеси с продуктови изображения, но засега следва да се описва като официална демонстрация на Qwen. Без многократни тестове със същите входни данни наличните доказателства не установяват постоянна вярност на продуктите на ниво, подходящо за производство.
6. Подобрени са също нативният 2K изход, типографията и естетиката на портретите
Официалната имплементация използва размер по подразбиране 2048 × 2048 и посочва препоръчителни размери за изходи в съотношения 1:1, 4:3, 3:4, 3:2, 2:3, 16:9 и 9:16. Материалите за представянето на Qwen показват също сложна типография, инфографики, панорами, сторибордове, генерирани от изгледи на персонажи от различни ъгли, и портрети с по-целенасочено осветление и детайлност.
Заедно тези възможности позиционират Qwen-Image-2.1 като нещо повече от компактен модел за генериране на изображения от текст. Той е създаден да обхваща по-широк път — от генерирането на ресурси до последващото редактиране.
Какво все още не доказва представянето на Qwen-Image-2.1
- Официалните примери не включват достатъчно пълни подкани, настройки или повторени резултати, за да се установи последователност.
- Наличните материали не потвърждават, че WeShop е интегрирал Qwen-Image-2.1, нито документират кредитите в WeShop, времето за генериране и достъпните настройки.
- Отворените тегла използват Qwen Research License. Официалният лиценз посочва, че търговското използване на материалите на модела изисква отделен търговски лиценз.
- Qwen-Image-Bench е бенчмарк, публикуван от доставчика, и не следва да замества тестовете в реални работни процеси за електронна търговия, дизайн или портрети.
Кой трябва да обърне внимание на Qwen-Image-2.1?
- Визуални дизайнери, които се нуждаят от прозрачни хора, продукти, стикери или елементи за композиране.
- Екипи в електронната търговия и модата, които комбинират модели, дрехи, обувки, чанти и други референции.
- Създатели, които искат да контролират локалните редакции с кръгове, оцветени области или маски.
- Разработчици, заинтересовани от по-малък модел, локално внедряване и по-ефективна инференция с множество изображения.
Основен извод
Представянето на Qwen-Image-2.1 може да се обобщи в едно изречение: 7B компонент за визуално генериране вече обработва стандартни изображения, прозрачни изображения, композиции с множество референции и локално редактиране в един творчески процес.
Най-отличителните му документирани възможности са нативният RGBA изход и поддръжката на до 10 референтни изображения. Следващият въпрос е колко надеждно обработва сложни продукти, портрети, типография и локални редакции при многократно генериране в реални условия.